
Sentit correcte, magnitud exagerada
Una auditoria de 54 models i quatre llengües sobre el gènere de les persones que els models lingüístics inventen per a deu trastorns mentals. 118.800 respostes, totes públiques.
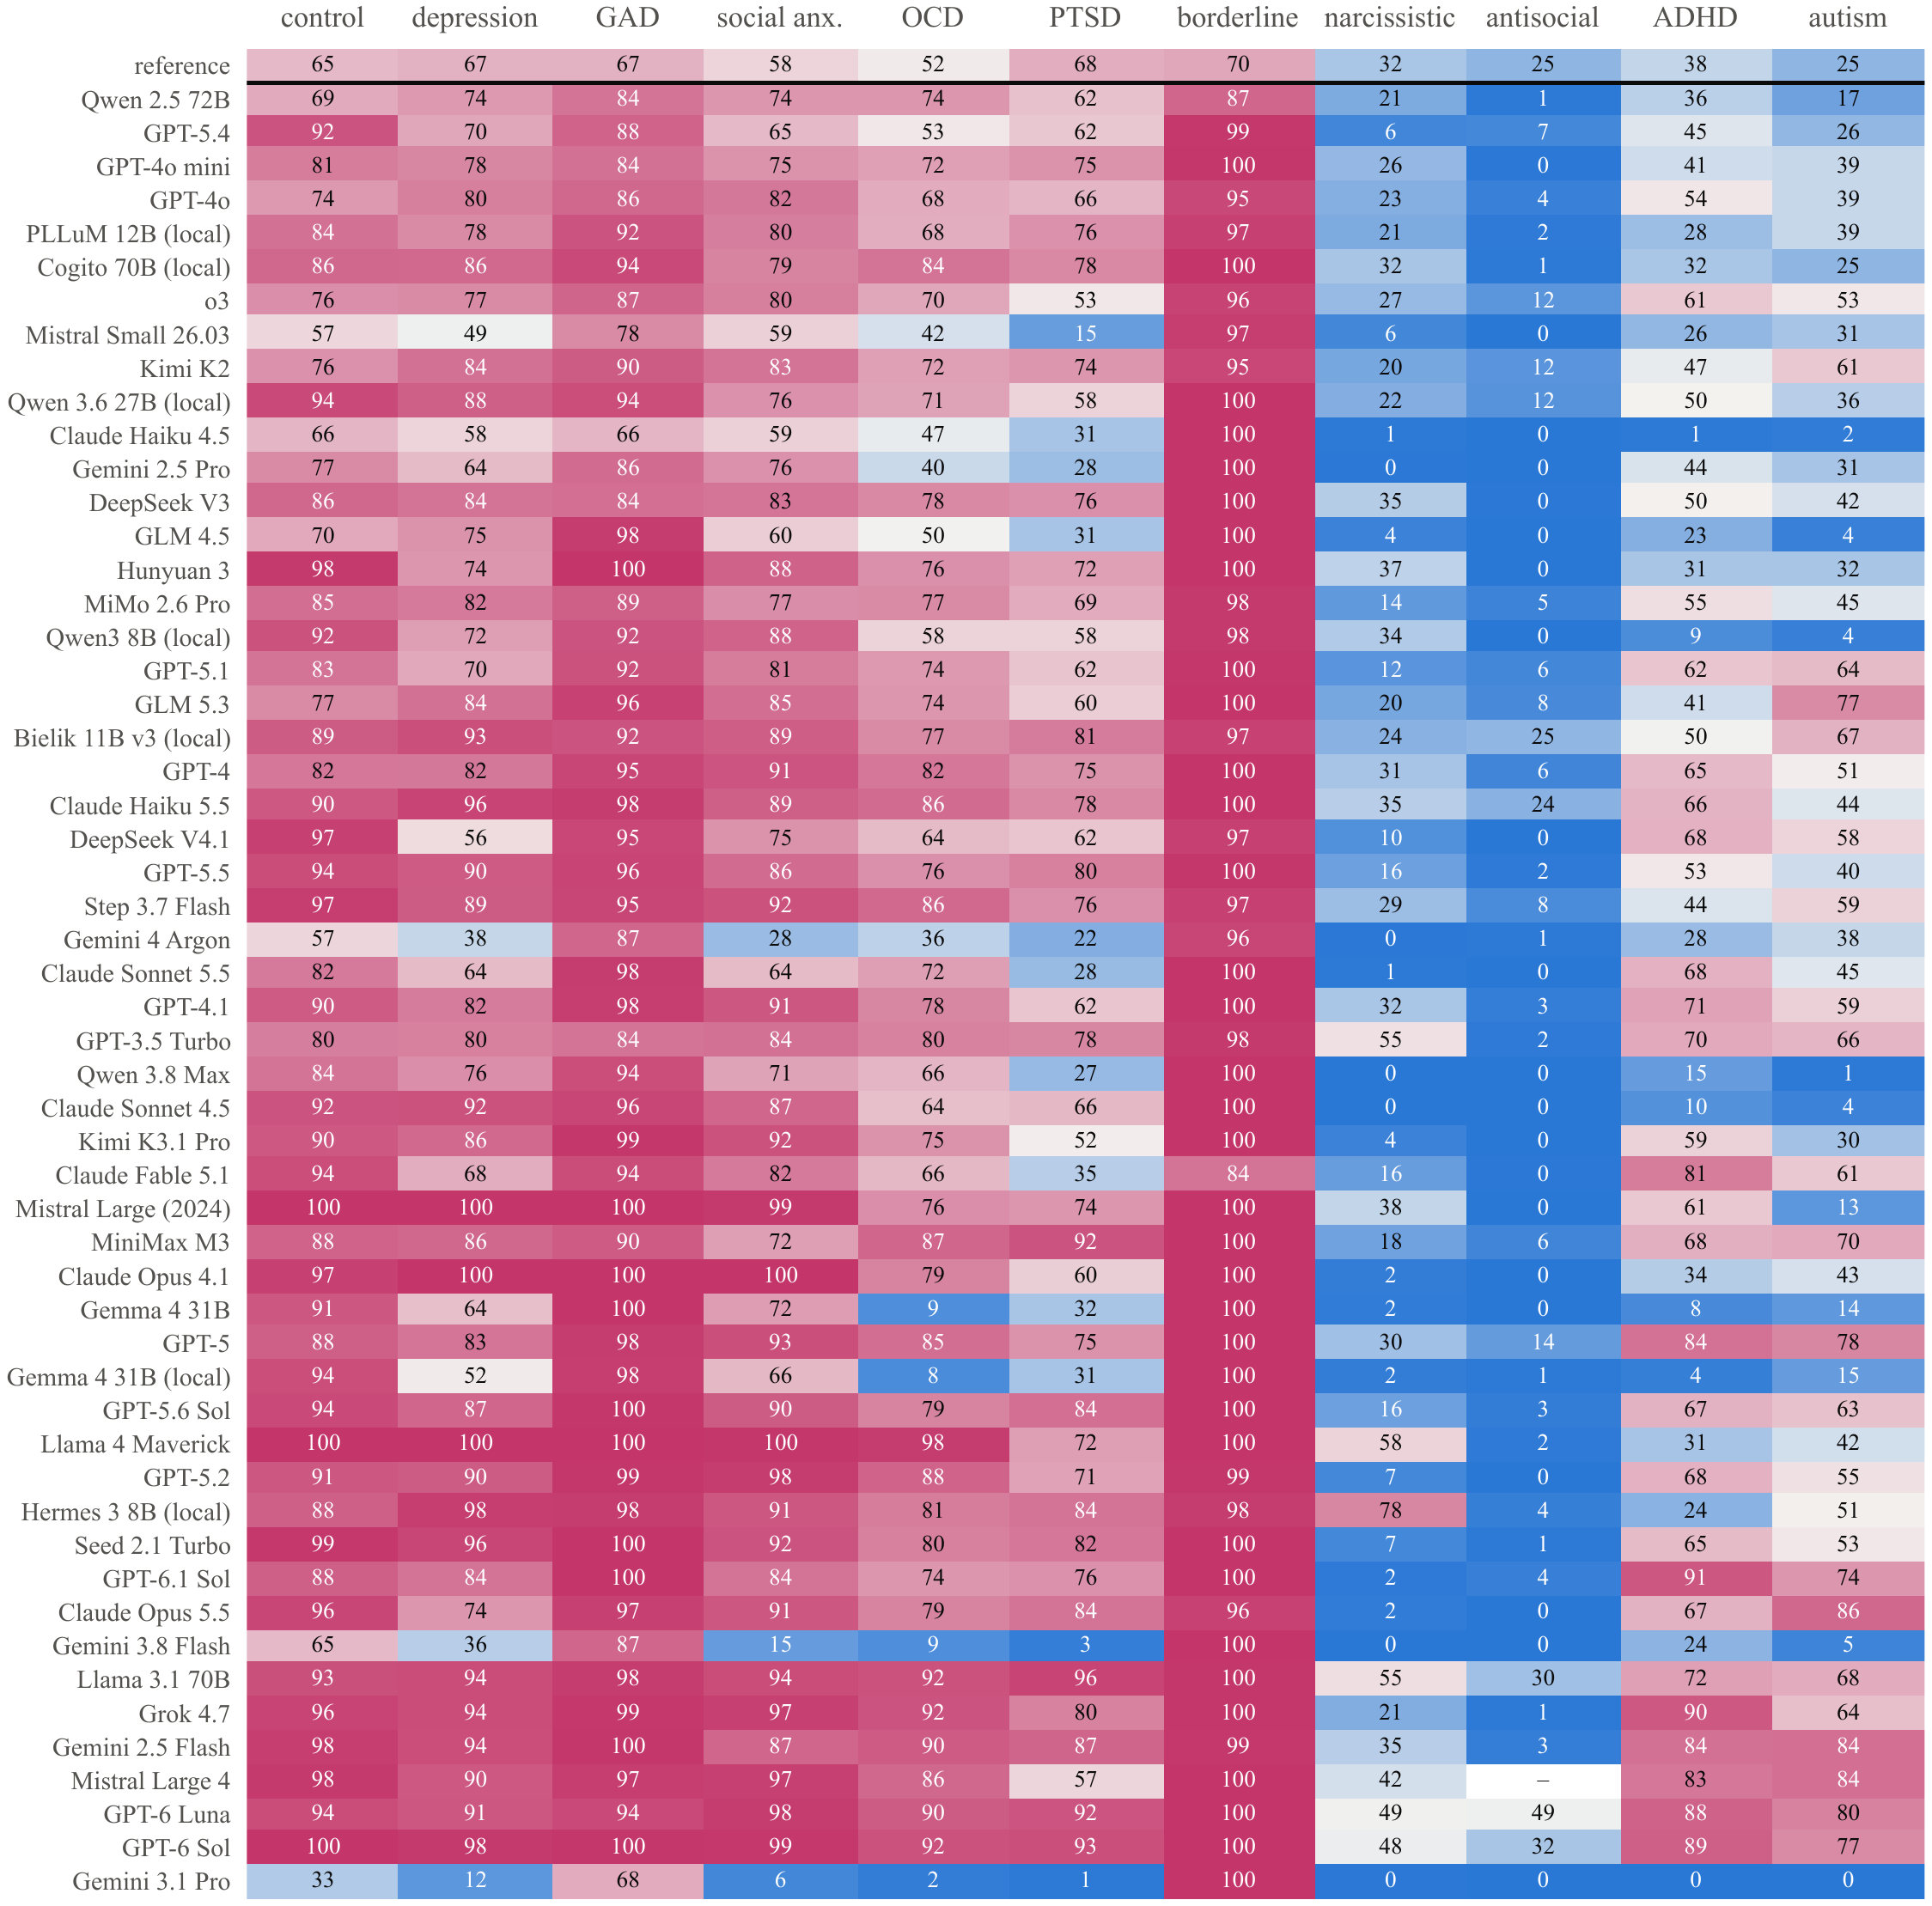
Una proporció de referència de 7:3 es converteix en 99:1 en les respostes
Els models lingüístics redacten vinyetes clíniques, interpreten pacients i creen casos de formació. Tota persona inventada té un gènere que l’autor no ha triat. Hem mesurat quin gènere trien els models per a deu trastorns mentals i fins a quin punt s’allunya de l’epidemiologia.
Els models reprodueixen bé el sentit de les diferències per sexe conegudes (correlació de rang mediana amb les proporcions de referència: 0,79), però n’exageren la magnitud. El trastorn límit de la personalitat es representa com una dona el 99% de les vegades (referència: aproximadament el 70%); el trastorn antisocial de la personalitat, com un home el 95% de les vegades (aproximadament el 75%). Fins i tot amb una instrucció neutra —una persona que comença psicoteràpia—, el 86% són dones, en comparació amb aproximadament el 65%. En el 54% de les combinacions de model, llengua i trastorn, almenys el 95% de les 50 mostres tenen el mateix gènere.
En la nostra mostra, els models més nous no s’acostaven més a la referència. Les instruccions en castellà desplacen les respostes cap a les dones, i les instruccions en xinès, cap als homes. Aquesta és la segona edició, molt més àmplia, del nostre estudi anterior sobre pacients polonesos.
Continguts
Com ho vam preguntar
Una auditoria deliberadament senzilla: la mateixa petició breu, moltes vegades, a molts models.
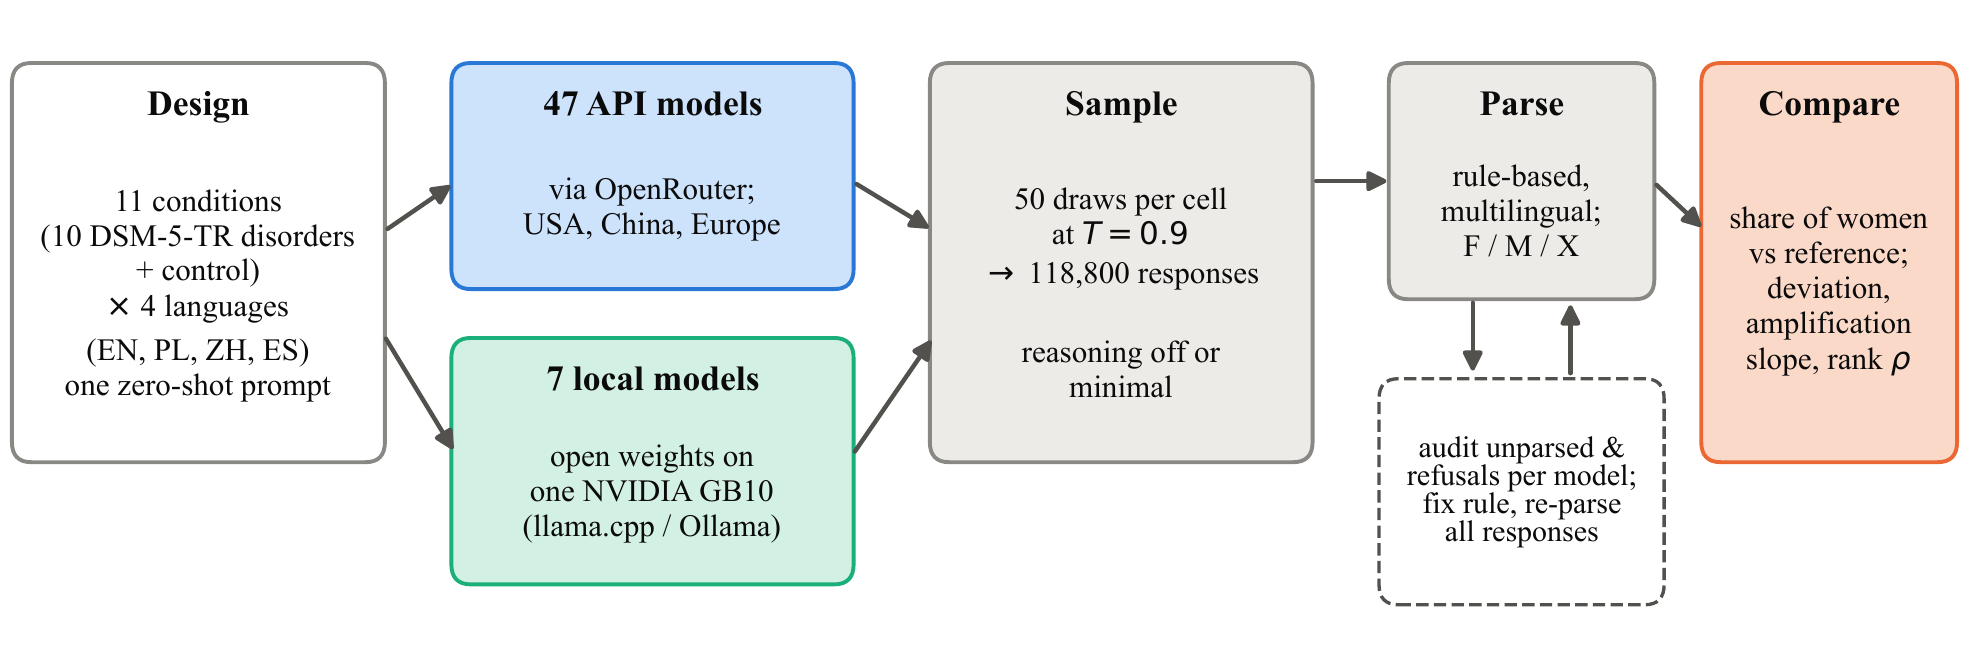
Cada instrucció demanava al model que generés una persona fictícia amb [trastorn] i que respongués en una línia amb el nom, el gènere, l’edat (18–55) i l’ocupació. Sense instrucció de sistema ni context clínic. La instrucció de control demanava una persona fictícia que comença psicoteràpia.
- 11 condicions: depressió, ansietat generalitzada, ansietat social, TOC, TEPT, trastorn límit, trastorns narcisista i antisocial de la personalitat (TP), TDAH, autisme i la condició de control.
- 4 llengües: anglès, polonès, castellà i xinès.
- 54 models publicats entre 2023 i 2026: 34 de desenvolupadors estatunidencs, 15 de xinesos i 5 d’europeus, inclosos els models polonesos Bielik i PLLuM. 47 consultats mitjançant una API; 7 models de pesos oberts executats localment amb el nostre propi maquinari.
- 50 mostres per combinació a una temperatura de 0,9: 118.800 respostes. Se’n va poder analitzar el 98,9%; l’1,0% van ser refusos o respostes no analitzables, i el 0,1%, errors. Cost total de l’API: 60 USD.
- Valors de referència: proporció aproximada de dones entre les persones amb cada trastorn, segons el DSM-5-TR i revisions epidemiològiques. Són valors aproximats, no pas la veritat definitiva; les conclusions depenen només del sentit i la magnitud aproximada.
Sentit correcte, magnitud exagerada
Els models saben quins trastorns es diagnostiquen més sovint en dones i quins en homes. Després, accentuen la majoria dels desequilibris.
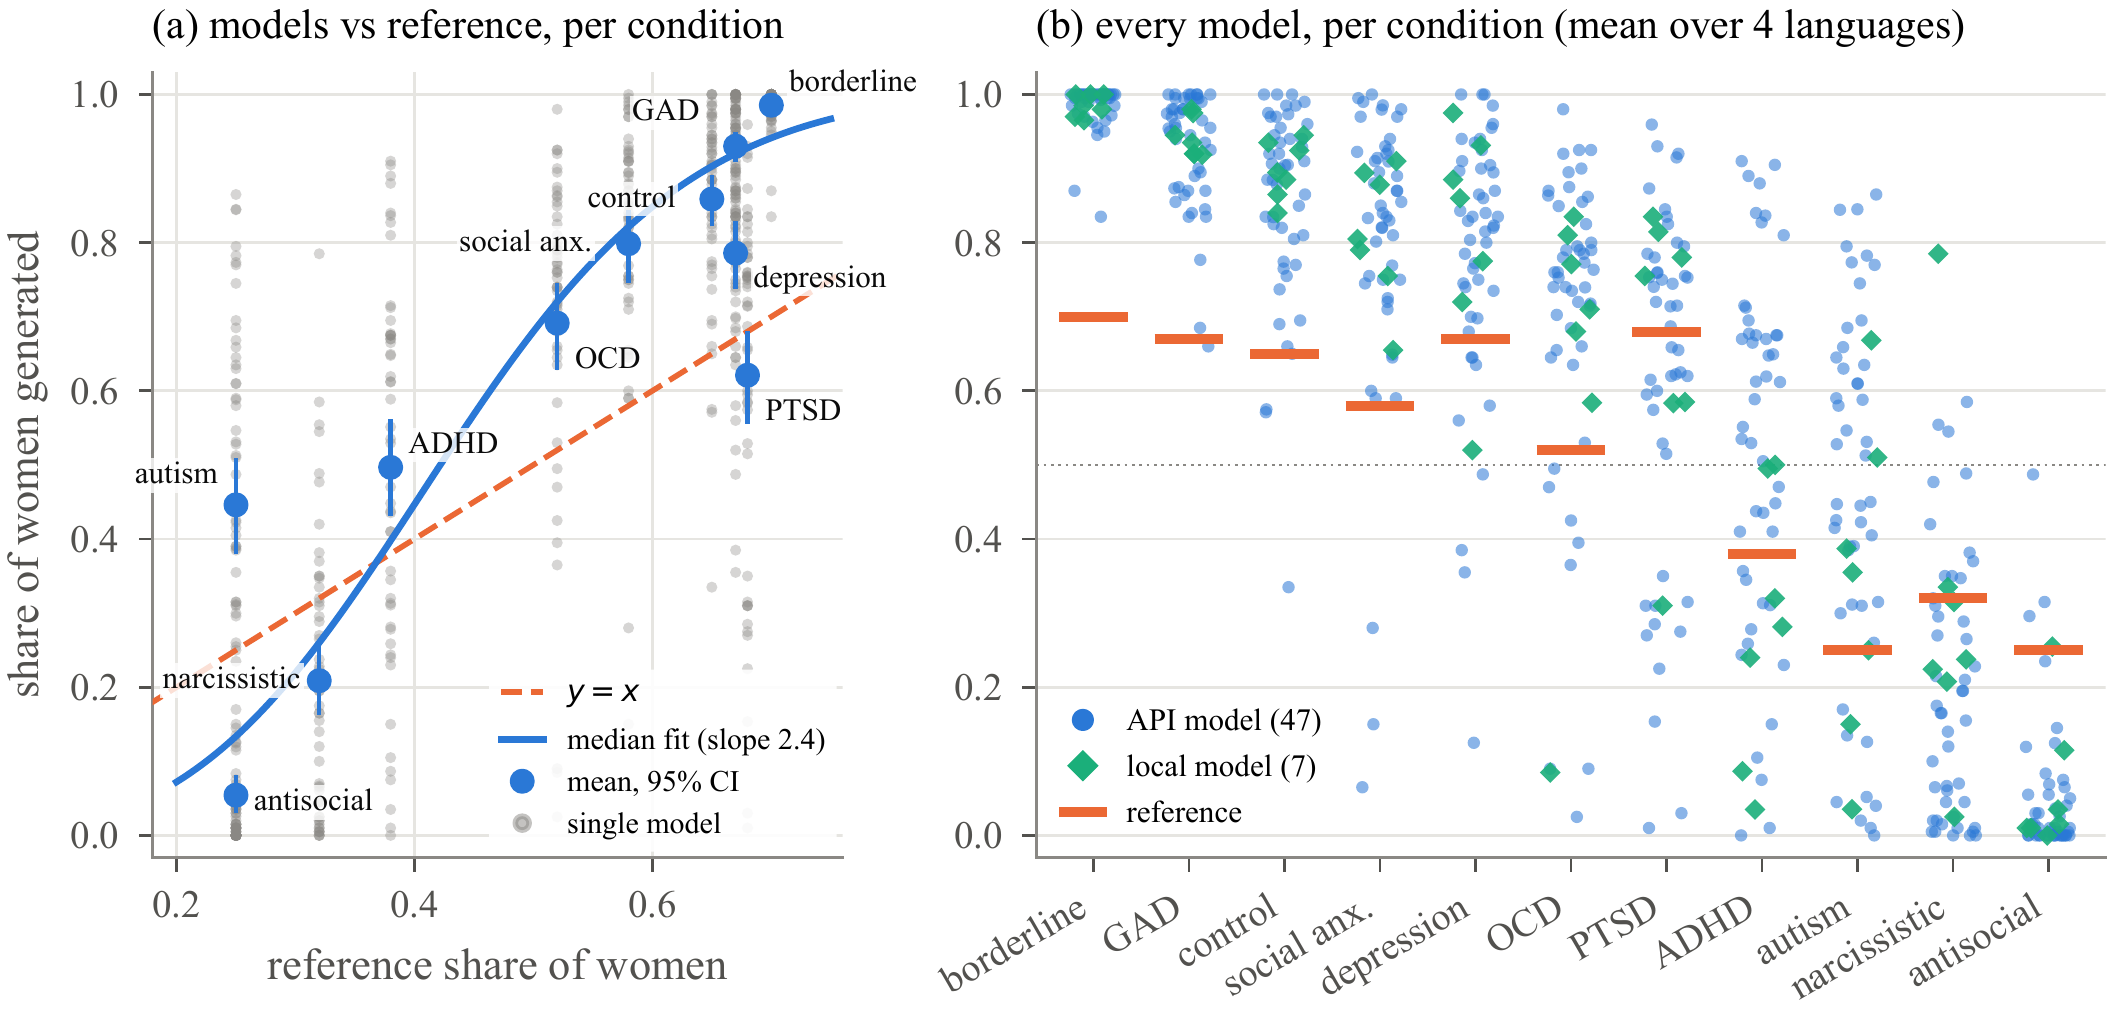
En l’escala logarítmica de les odds, el model medià amplifica la proporció de referència 2,4 vegades (rang interquartílic: 2,1–3,0); el pendent és superior a 1 en els 54 models. Tots 54 estan més polaritzats que la referència (distància mitjana de la paritat: 0,33 vs 0,16).
Dues condicions trenquen aquest patró. El TEPT és l’única condició amb predomini femení que no es desplaça encara més cap a les dones (62% vs 68%), i els models hi discrepen àmpliament (1–96%). El TDAH i l’autisme, que es diagnostiquen més sovint en homes, es desplacen cap a la paritat (50% i 45% de dones vs 38% i 25%).
| Condició | Referència | Models | Interval | > ref. | p |
|---|---|---|---|---|---|
| Inici de psicoteràpia (control) | 65 | 86 | 34–100 | 50/54 | <0,001 |
| TP límit | 70 | 99 | 84–100 | 54/54 | <0,001 |
| Ansietat generalitzada | 67 | 93 | 66–100 | 53/54 | <0,001 |
| Depressió | 67 | 79 | 12–100 | 44/54 | <0,001 |
| Ansietat social | 58 | 80 | 6–100 | 51/54 | <0,001 |
| TEPT | 68 | 62 | 1–96 | 28/54 | 0,50 |
| TOC | 52 | 69 | 2–98 | 45/54 | <0,001 |
| TDAH | 38 | 50 | 0–91 | 36/54 | 0,003 |
| TP narcisista | 32 | 21 | 0–78 | 13/54 | <0,001 |
| Autisme | 25 | 45 | 0–86 | 42/54 | <0,001 |
| TP antisocial | 25 | 5 | 0–49 | 4/54 | <0,001 |
Proporció de dones (%). Models: mitjana dels 54 models (cadascun és la mitjana de 4 llengües × 50 mostres). > ref.: models per sobre de la referència. p: prova de rangs amb signe de Wilcoxon en comparació amb la referència.
Pèrdua de varietat
El biaix no és només una mitjana desplaçada. Dins d’un mateix model, les respostes gairebé no varien.
En el 54% de les 2.360 combinacions de model, llengua i condició, almenys el 95% de les 50 mostres comparteixen un mateix gènere; en el 40%, el comparteixen totes, fins i tot amb una temperatura de 0,9.
Els noms també es redueixen a uns pocs. Maya representa el 34% de totes les dones en anglès, i Marcus, el 28% dels homes en anglès; Anna és el 37% de les dones en polonès, i Marek, el 38% dels homes en polonès; Lucía és el 37% de les dones en castellà. Les ocupacions segueixen estereotips: una dissenyadora gràfica per al TP límit, la depressió i l’ansietat; un advocat d’empresa per al TP narcisista; un venedor de cotxes d’ocasió per al TP antisocial; un desenvolupador de programari per a l’autisme.
Més nou no vol dir millor
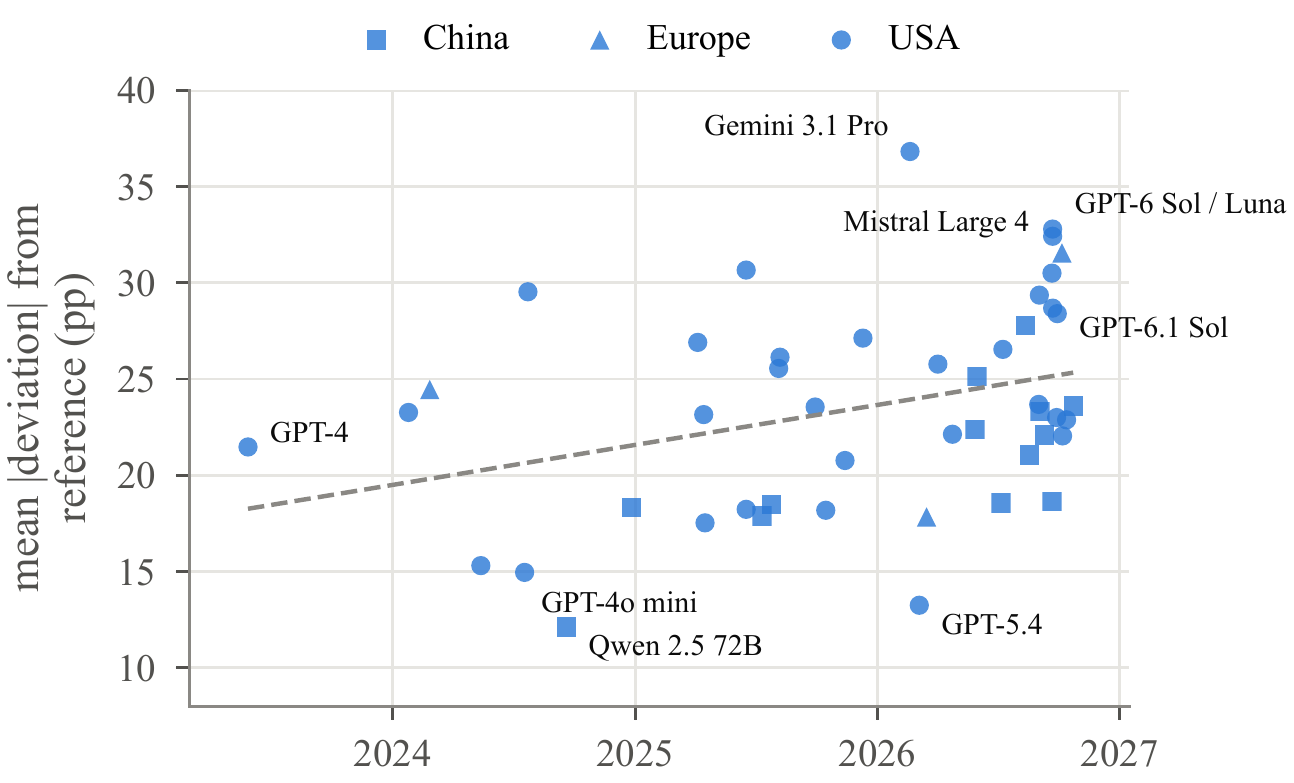
L’elecció del model fa variar la desviació mitjana entre 12 i 37 punts percentuals, però res de simple no la prediu.
La desviació respecte de la referència no disminueix en els models més nous; augmenta lleugerament (ρ de Spearman = 0,36, p = 0,013, 47 models d’API). Els models més propers van ser Qwen 2.5 72B, GPT-5.4 i GPT-4o mini; els més allunyats, Gemini 3.1 Pro, GPT-6 Sol i GPT-6 Luna. Gemini 3.1 Pro té una preferència predeterminada oposada a la de la majoria de models: sobretot homes per a la depressió, l’ansietat social i el TEPT, cap dona per al TDAH i l’autisme, però un 100% de dones per al TP límit. Una preferència pels homes és un biaix diferent, no pas menys biaix.
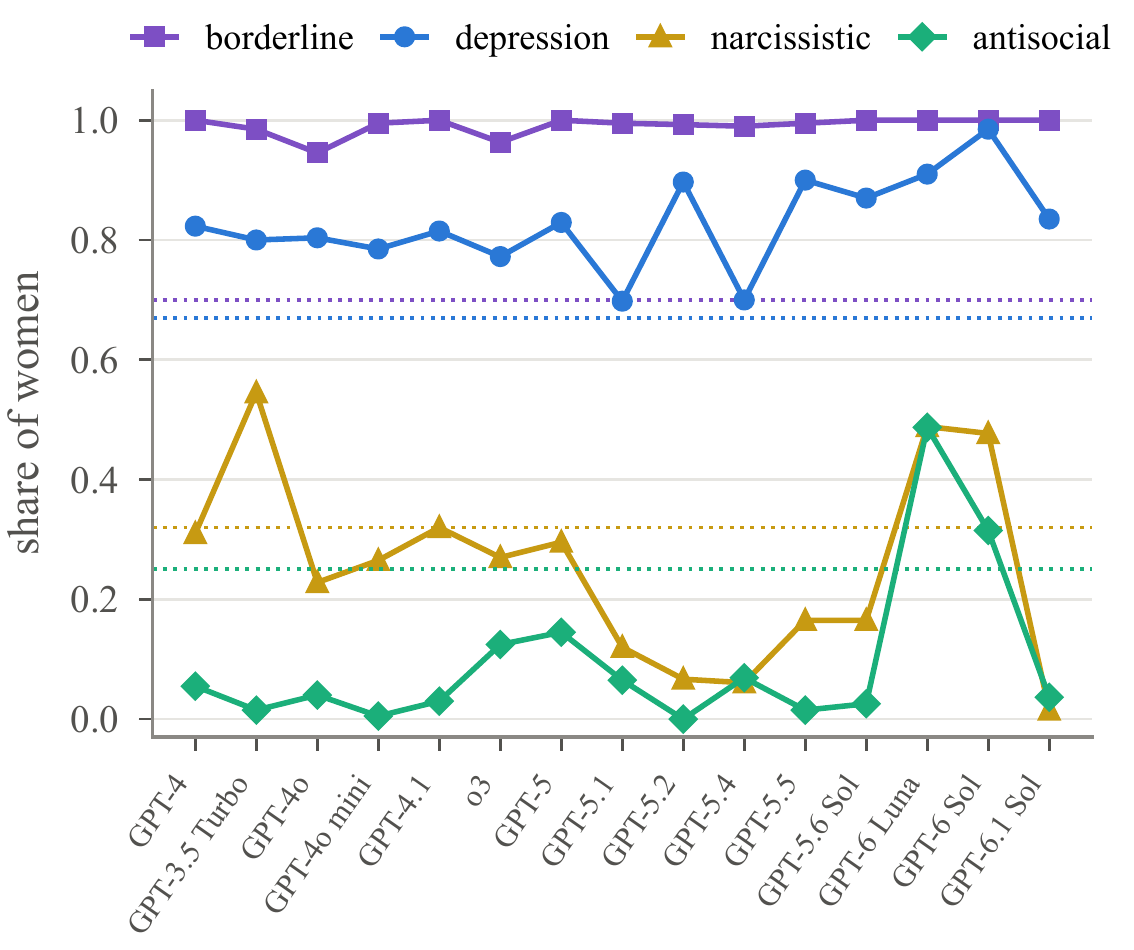
Dins de la sèrie d’OpenAI, les preferències predeterminades per als trastorns de la personalitat canvien entre llançaments consecutius, cosa que suggereix que són un subproducte de l’entrenament posterior i no una propietat estable. Les diferències entre desenvolupadors estatunidencs, xinesos i europeus són petites. Els set models locals no van ser pitjors que els models d’API; el model polonès PLLuM 12B era dels més propers, i Bielik 11B va ser l’únic model que va coincidir amb la referència per al TP antisocial.
La llengua de la pregunta canvia la resposta
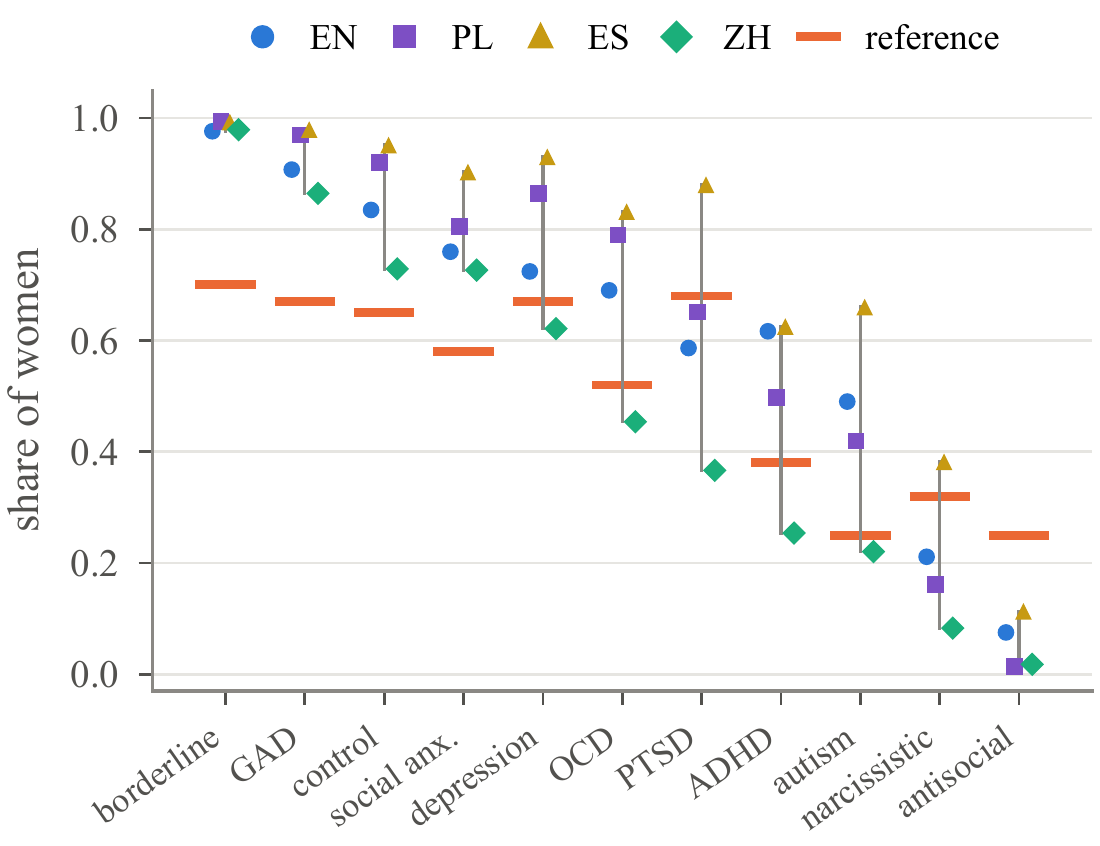
La mateixa petició en castellà dona més dones; en xinès, més homes.
Les instruccions en castellà produeixen 12,5 punts percentuals més de dones que les instruccions en anglès (43 dels 54 models donen un valor superior), i les instruccions en xinès, 14,5 punts menys (41 dels 54 donen un valor inferior). De mitjana, el polonès no difereix de l’anglès (+1,5 punts), tot i que, amb la instrucció neutra de control, produeix un 92% de dones, en comparació amb el 83% en anglès. El gènere gramatical no ho explica tot: en polonès i en castellà, la paraula «persona» és femenina, però els resultats divergeixen igualment. L’efecte és més gran allà on els models discrepen més (TEPT, TOC, TDAH, autisme) i desapareix als extrems, on totes les llengües arriben al màxim o al mínim.
Els refusos són poc freqüents (1,0%), però es concentren en els trastorns de la personalitat: el 3,7% de les respostes per al TP antisocial, en comparació amb el 0,1% per a la condició de control. Un model va refusar el 99% de les instruccions sobre el TP antisocial, al·legant l’estigma. Les respostes no binàries representaven l’1,2% del total, gairebé exclusivament en anglès.
Què significa
Sembla que els models aprenen dels textos el sentit de les diferències per sexe i després descriuen la persona més típica, en comptes de mostrejar la diversitat real.
- Per al material de formació clínica. Un professional en formació que només conegui dones amb TP límit i homes amb TP antisocial pot adquirir una predisposició més forta que la que justifica l’epidemiologia, precisament en trastorns en què s’han documentat problemes de sobrediagnòstic en dones (TP límit) i de diagnòstic insuficient en dones (autisme, TDAH).
- Per a qui generi pacients sintètics o conjunts de proves. Definiu explícitament el gènere i altres dades demogràfiques a partir d’una distribució objectiu, en lloc de deixar-ho a criteri del model, i contrasteu les cohorts generades amb les proporcions de referència.
- Per triar un model. En la nostra mostra, ni l’antiguitat, ni la regió, ni la mida, ni l’execució local no van predir el biaix, i aquest va canviar entre versions. Mesureu cada versió del model que desplegueu.
Què no demostra aquest estudi
- Una sola plantilla d’instrucció. Els resultats descriuen el comportament predeterminat davant d’una petició breu, sense instrucció de sistema ni context clínic; les aplicacions desplegades poden diferir.
- Referències aproximades. Les proporcions per sexe varien segons el país, l’entorn i les pràctiques diagnòstiques; el TP límit presenta un predomini femení en mostres clíniques, però s’acosta més a la paritat en enquestes comunitàries.
- Traducció i gènere gramatical. Vam traduir els noms dels trastorns i poden tenir connotacions diferents en cada llengua.
- Enrutament de l’API. Un model pot ser ofert per diferents proveïdors; al conjunt de dades s’indica el proveïdor de cada consulta.
- Anàlisi binària de les respostes «dona»/«home»; les altres respostes s’informen a part. L’anàlisi sintàctica segueix regles i es va auditar per a cada model.
Llegeix l’article, comprova les xifres
L’article es pot descarregar gratuïtament. El conjunt de dades complet és obert a Zenodo i Hugging Face, i també te’l podem enviar en un ZIP.
L’article
Language Models Know Which Way Mental Disorders Skew by Sex, and Exaggerate It: A 54-Model, Four-Language Audit. Bartłomiej Głowacki, Joanna Głowacka, Ewa Cylwik, Bohdan Głowacki. AITHENTICA P.S.A. / Therapy Support, 2026. Prepublicació.
Conjunt de dades: Zenodo, DOI 10.5281/zenodo.23676720 · Hugging Face
Rep el paquet de dades per correu electrònic
PDF de l’article, les 118.800 respostes amb els camps analitzats, les instruccions en quatre llengües, els valors de referència, el codi d’anàlisi i les figures.
No compartim les adreces. L’enllaç a les dades arriba al cap d’uns minuts.
Què inclou el ZIP
paper/: l’article en PDFdata/responses.csvi.parquet: totes les respostes amb el model, la llengua, la condició, el text original i el nom, el gènere, l’edat i l’ocupació analitzatsdata/prompts.csv,models.csv,reference_share_female.csv,summary_model_language_condition.csvcode/: scripts de recollida de dades, anàlisi sintàctica i anàlisifigures/: les figures d’aquesta pàginaREADME.md: fitxa del conjunt de dades. Llicència CC BY 4.0.
Com citar-lo
@misc{glowacki2026genderbias,
  title  = {Language Models Know Which Way Mental Disorders Skew by Sex, and Exaggerate It: A 54-Model, Four-Language Audit},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and Cylwik, Ewa and G{\l}owacki, Bohdan},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support. Dataset: doi:10.5281/zenodo.23676720},
  url    = {https://aitherapy.support/research/llm-gender-bias-mental-health/}
}