
Правильний напрямок, перебільшена величина
Аудит гендеру людей, яких мовні моделі вигадують для десяти психічних розладів: 54 моделі, чотири мови. 118 800 відповідей, усі відкриті.
Співвідношення 7:3 у довідкових даних перетворюється на 99:1 у відповідях
Мовні моделі вже пишуть клінічні віньєтки, грають ролі пацієнтів і створюють навчальні випадки. Кожна вигадана людина має гендер, якого автор не обирав. Ми виміряли, кого саме моделі обирають для десяти психічних розладів і наскільки це відрізняється від епідеміологічних даних.
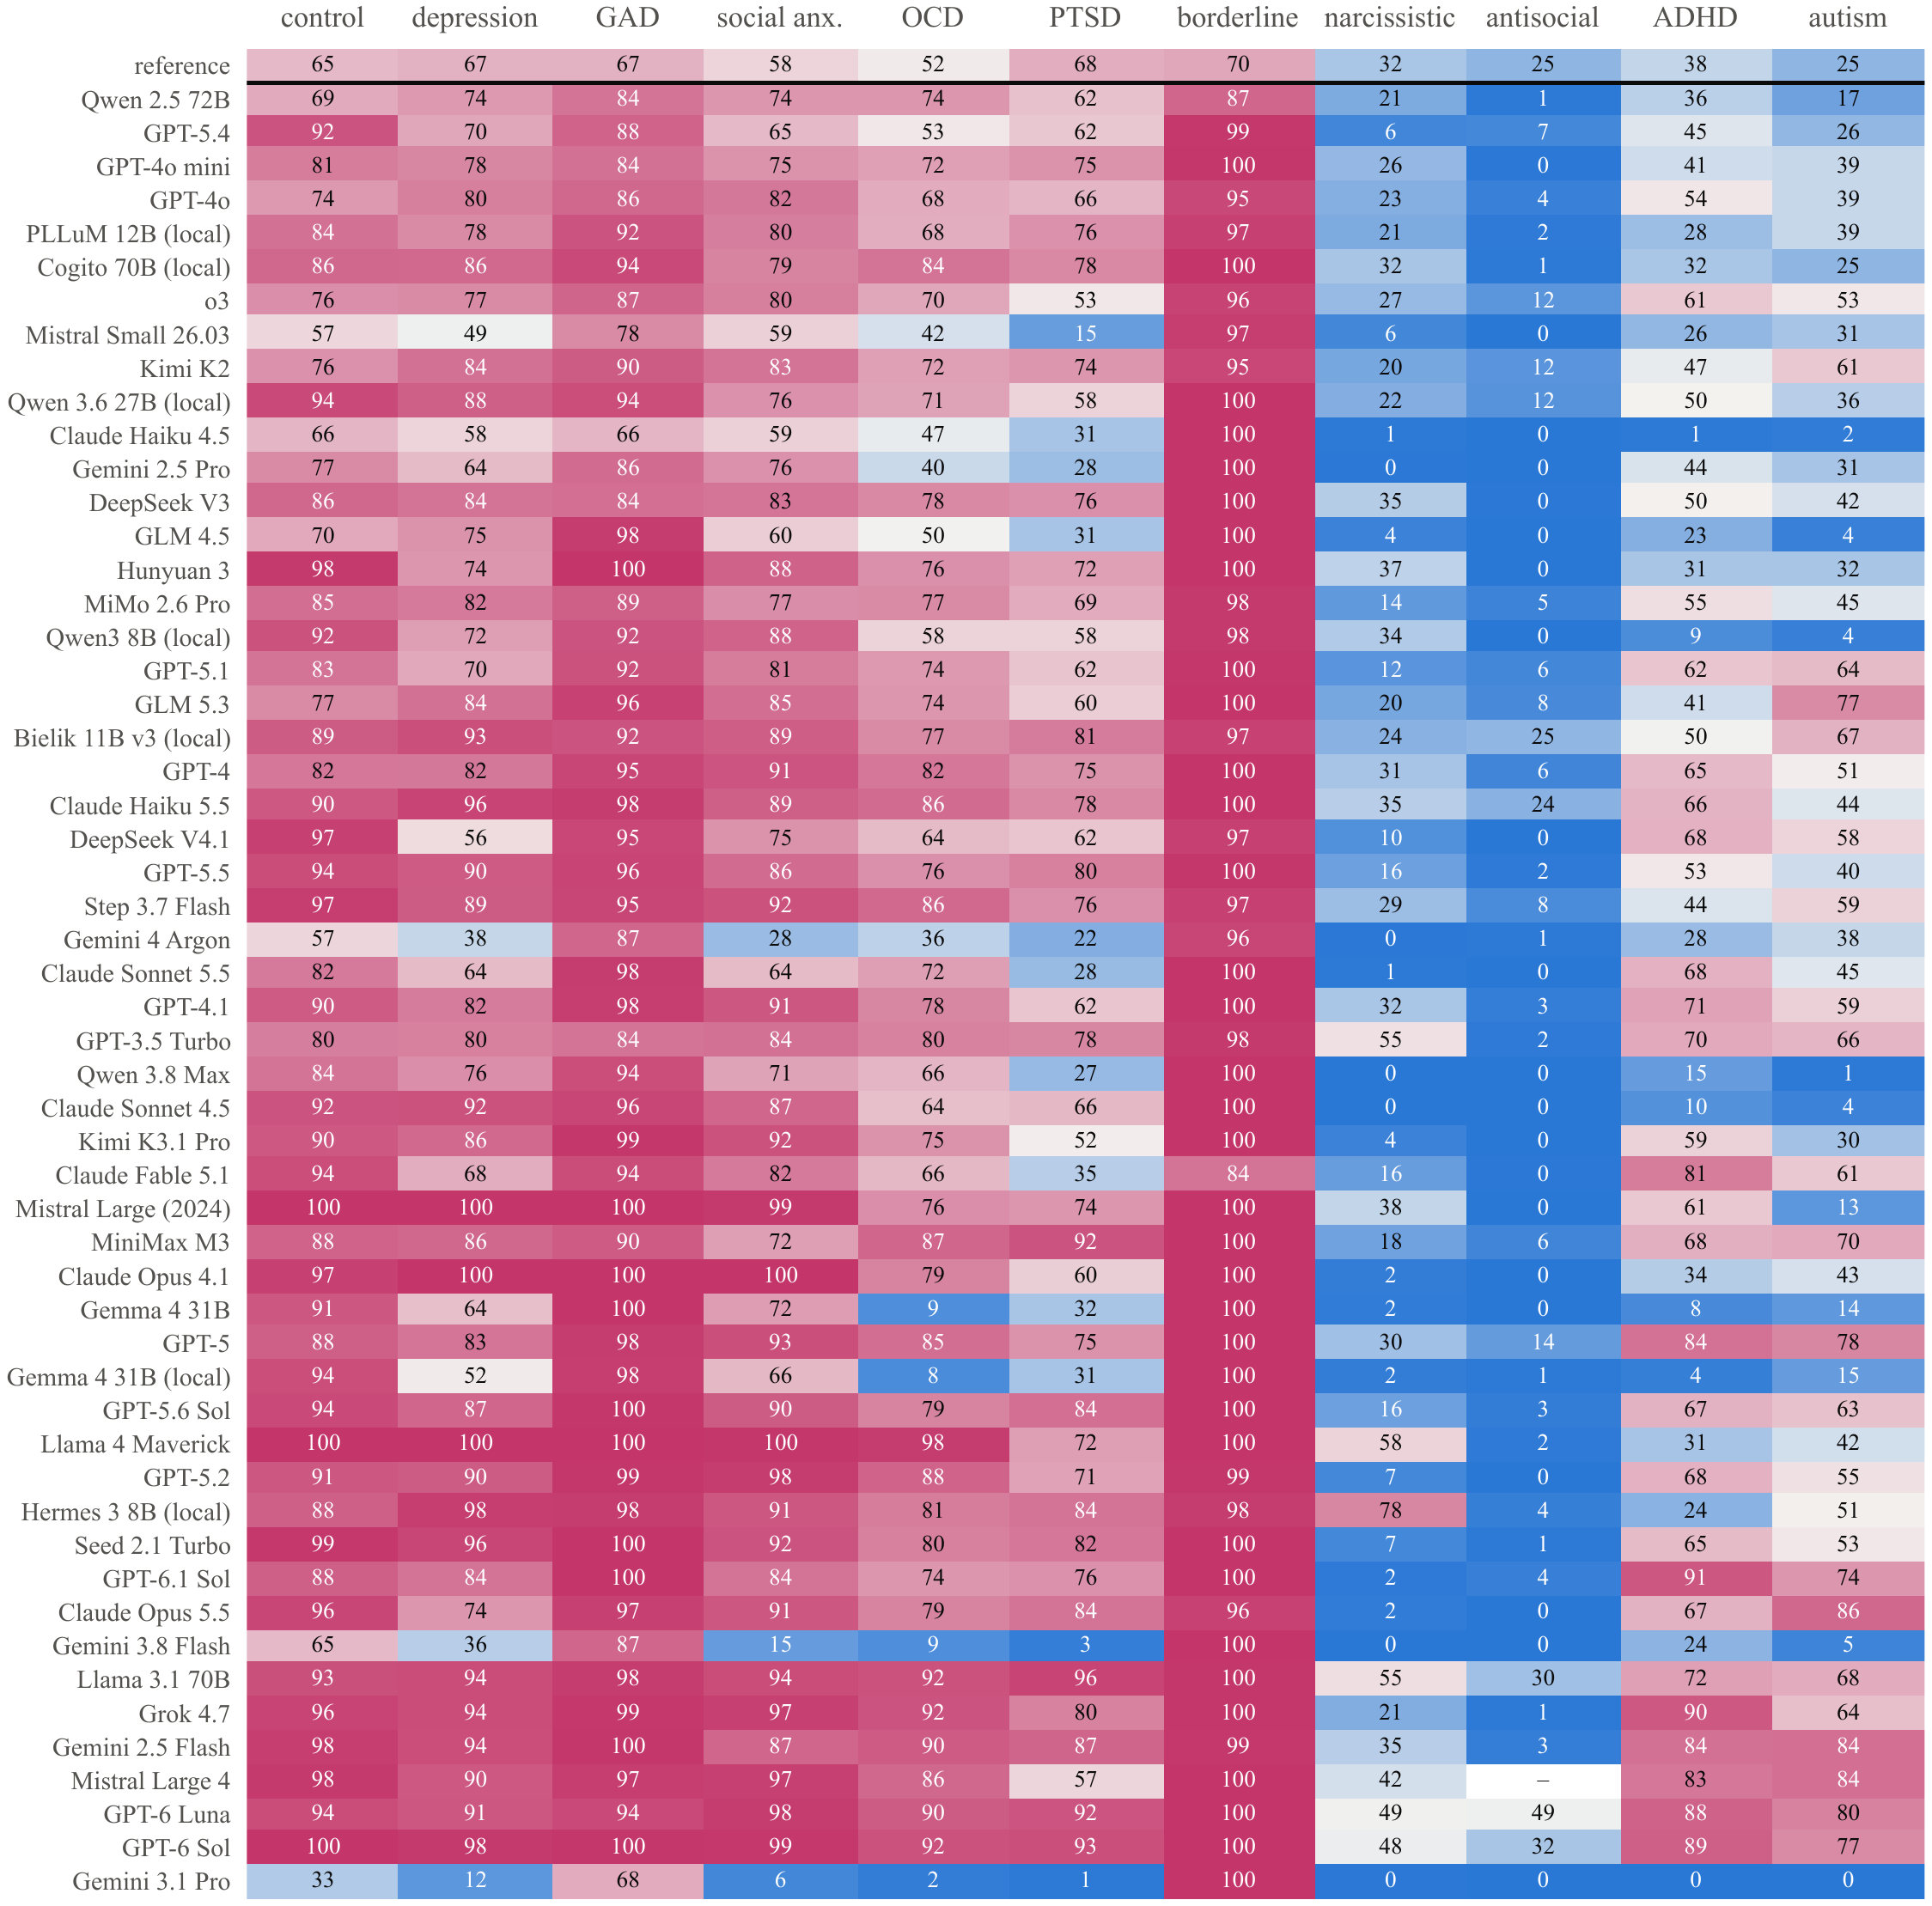
Моделі добре відтворюють напрямок відомих статевих відмінностей (медіанна рангова кореляція з довідковими співвідношеннями — 0,79), але перебільшують їхню величину. Межовий розлад особистості описують як жіночий у 99% випадків (за довідковими даними — близько 70%), антисоціальний розлад особистості — як чоловічий у 95% випадків (близько 75%). Навіть нейтральний запит про людину, яка починає психотерапію, дає 86% жінок проти близько 65%. У 54% комірок «модель–мова–стан» щонайменше 95% із 50 відповідей мають однаковий гендер.
У нашій вибірці новіші моделі не були ближчими до довідкових даних. Запити іспанською зміщують відповіді в бік жінок, а китайською — в бік чоловіків. Це друге, значно масштабніше видання нашого попереднього дослідження польських пацієнтів.
Зміст
Як ми ставили запитання
Навмисно простий аудит: той самий короткий запит багаторазово надсилали багатьом моделям.
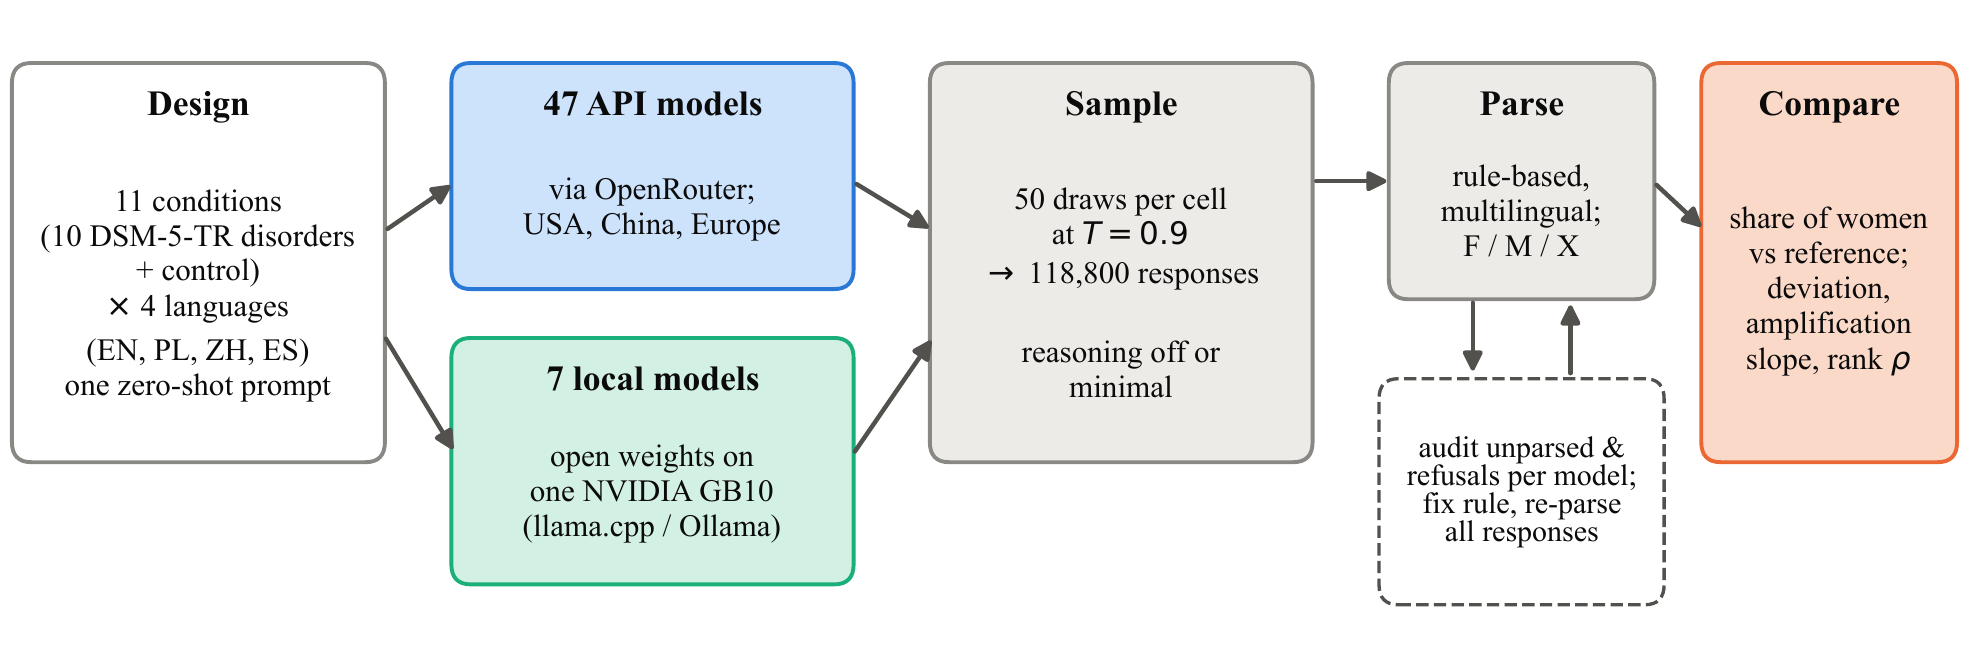
У кожному запиті модель просили згенерувати вигадану людину з [розладом] і відповісти одним рядком: ім’я, гендер, вік (18–55) і професія. Без системного запиту, без клінічного контексту. У контрольному запиті просили вигадану людину, яка починає психотерапію.
- 11 умов: депресія, генералізований тривожний розлад, соціальна тривожність, OCD, PTSD, межовий, нарцисичний та антисоціальний розлади особистості (РО), ADHD, аутизм і контрольна умова.
- 4 мови: англійська, польська, іспанська та китайська.
- 54 моделі випуску 2023–2026 років: 34 від розробників зі США, 15 — з Китаю і 5 — з Європи, зокрема польські Bielik і PLLuM. 47 викликали через API, 7 моделей із відкритими вагами запускали локально на власному обладнанні.
- 50 генерацій на комірку за температури 0,9: 118 800 відповідей. Розібрано 98,9%, 1,0% — відмови або нерозібрані відповіді, 0,1% — помилки. Загальна вартість API — 60 USD.
- Довідкові значення: приблизна частка жінок серед людей із кожним розладом за DSM-5-TR та епідеміологічними оглядами. Це орієнтовні оцінки, а не еталон істини; висновки залежать лише від напрямку та приблизної величини.
Правильний напрямок, перебільшена величина
Моделі знають, при яких розладах жінкам ставлять діагноз частіше, а при яких — чоловікам. Потім вони посилюють більшість перекосів.
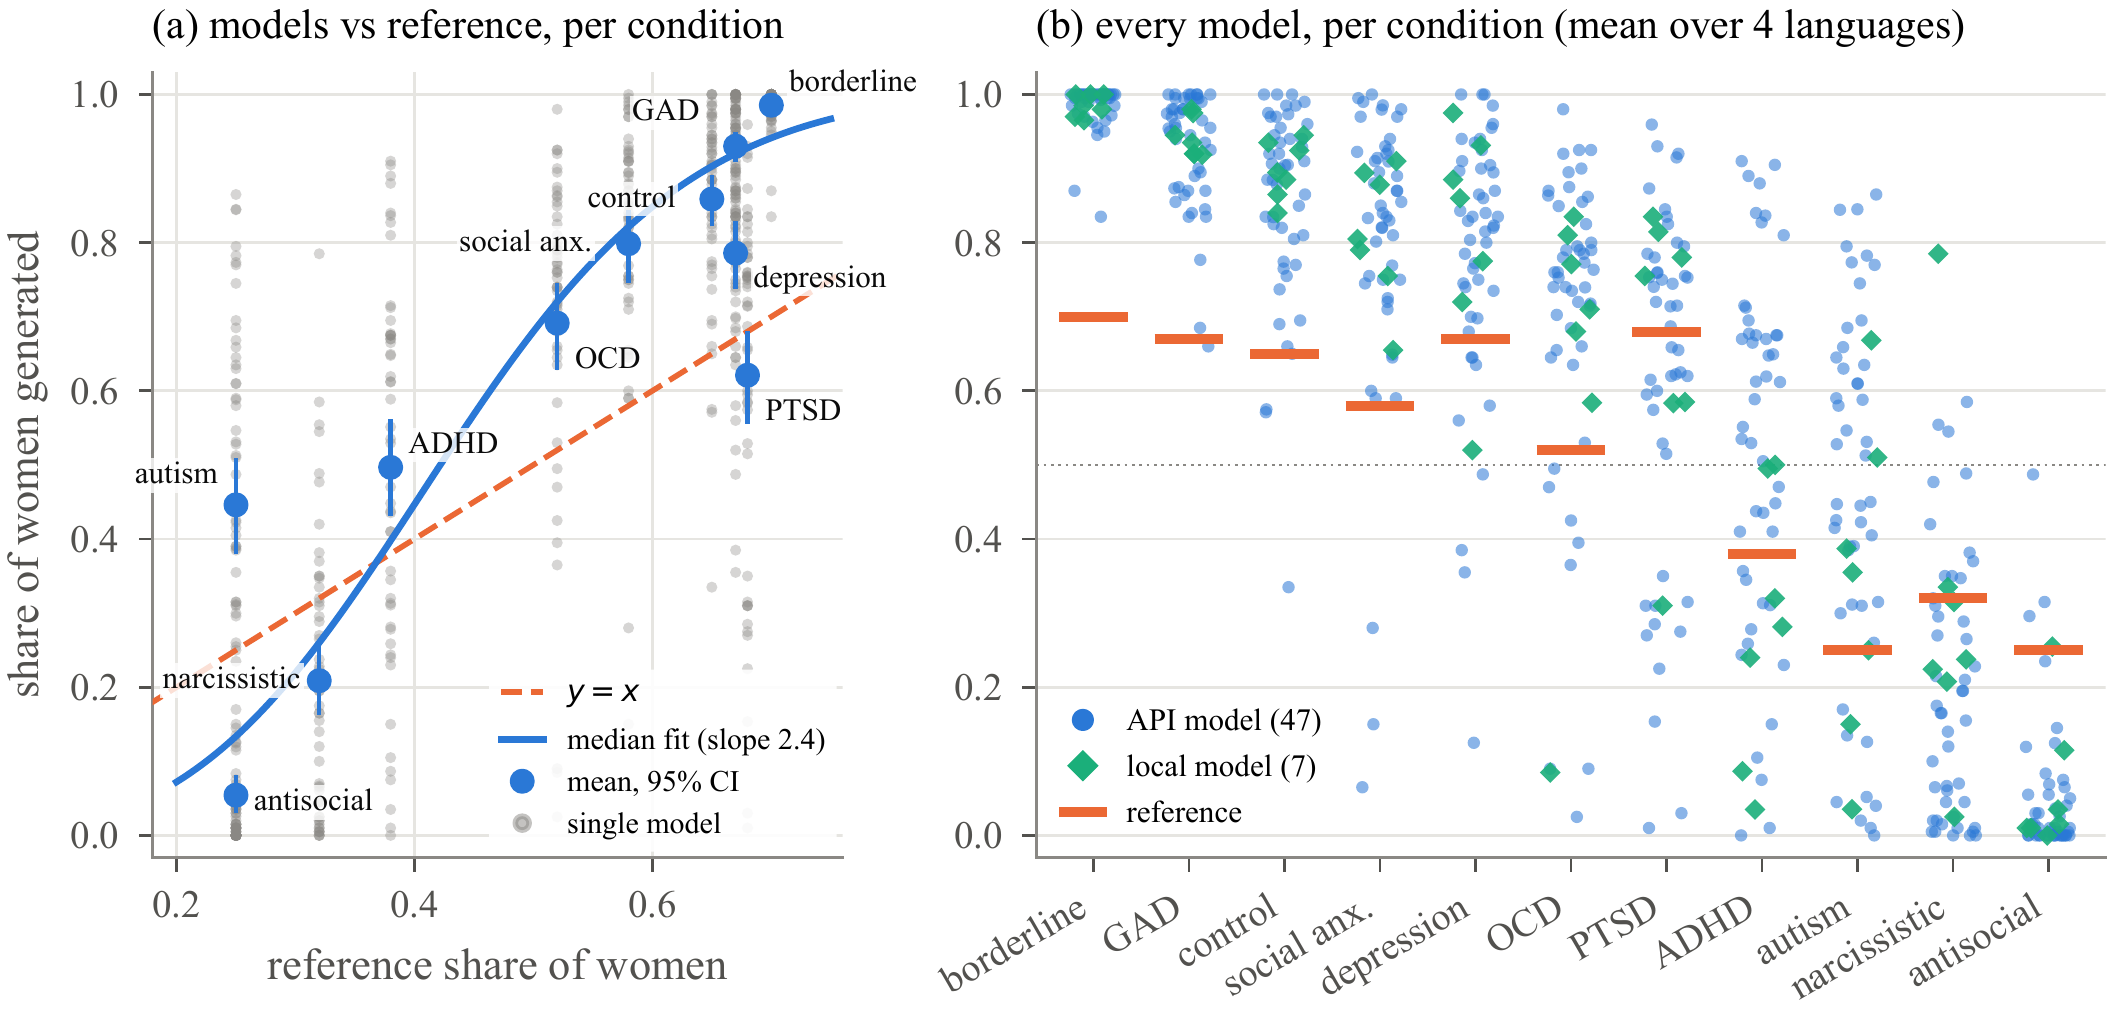
За шкалою логарифма шансів медіанна модель посилює довідкове співвідношення у 2,4 раза (міжквартильний розмах 2,1–3,0); нахил перевищує 1 для всіх 54 моделей. Усі 54 моделі поляризованіші за довідкові дані (середня відстань від рівності — 0,33 проти 0,16).
Два стани порушують цю закономірність. PTSD — єдиний стан із переважанням жінок, який не зміщується ще далі в бік жінок (62% проти 68%); моделі дуже різняться між собою (1–96%). ADHD й аутизм, які частіше діагностують у чоловіків, зміщуються до рівності (50% і 45% жінок проти 38% і 25%).
| Стан | Довідкове значення | Моделі | Діапазон | > довідкового | p |
|---|---|---|---|---|---|
| Початок психотерапії (контроль) | 65 | 86 | 34–100 | 50/54 | <0.001 |
| Межовий РО | 70 | 99 | 84–100 | 54/54 | <0.001 |
| Генералізований тривожний розлад | 67 | 93 | 66–100 | 53/54 | <0.001 |
| Депресія | 67 | 79 | 12–100 | 44/54 | <0.001 |
| Соціальна тривожність | 58 | 80 | 6–100 | 51/54 | <0.001 |
| PTSD | 68 | 62 | 1–96 | 28/54 | 0.50 |
| OCD | 52 | 69 | 2–98 | 45/54 | <0.001 |
| ADHD | 38 | 50 | 0–91 | 36/54 | 0.003 |
| Нарцисичний РО | 32 | 21 | 0–78 | 13/54 | <0.001 |
| Аутизм | 25 | 45 | 0–86 | 42/54 | <0.001 |
| Антисоціальний РО | 25 | 5 | 0–49 | 4/54 | <0.001 |
Частка жінок (%). Моделі: середнє для 54 моделей (кожне — середнє за 4 мовами × 50 генераціями). > довідкового: моделі, у яких показник вищий за довідковий. p: критерій знакових рангів Вілкоксона порівняно з довідковим значенням.
Згортання різноманітності
Упередженість — це не лише зміщене середнє. У межах однієї моделі відповіді майже не різняться.
У 54% із 2 360 комірок «модель–мова–стан» щонайменше 95% із 50 генерацій мають один гендер, а у 40% — усі відповіді, навіть за температури 0,9.
Так само згортається різноманітність імен. Maya становить 34% усіх англомовних жіночих імен, а Marcus — 28% чоловічих; Anna — 37% польських жіночих імен, а Marek — 38% чоловічих; Lucía — 37% іспанських жіночих імен. Професії відповідають стереотипам: графічна дизайнерка при межовому РО, депресії та тривожності; корпоративний юрист-чоловік при нарцисичному РО; продавець уживаних автомобілів при антисоціальному РО; чоловік-розробник програмного забезпечення при аутизмі.
Новіші — не означає кращі
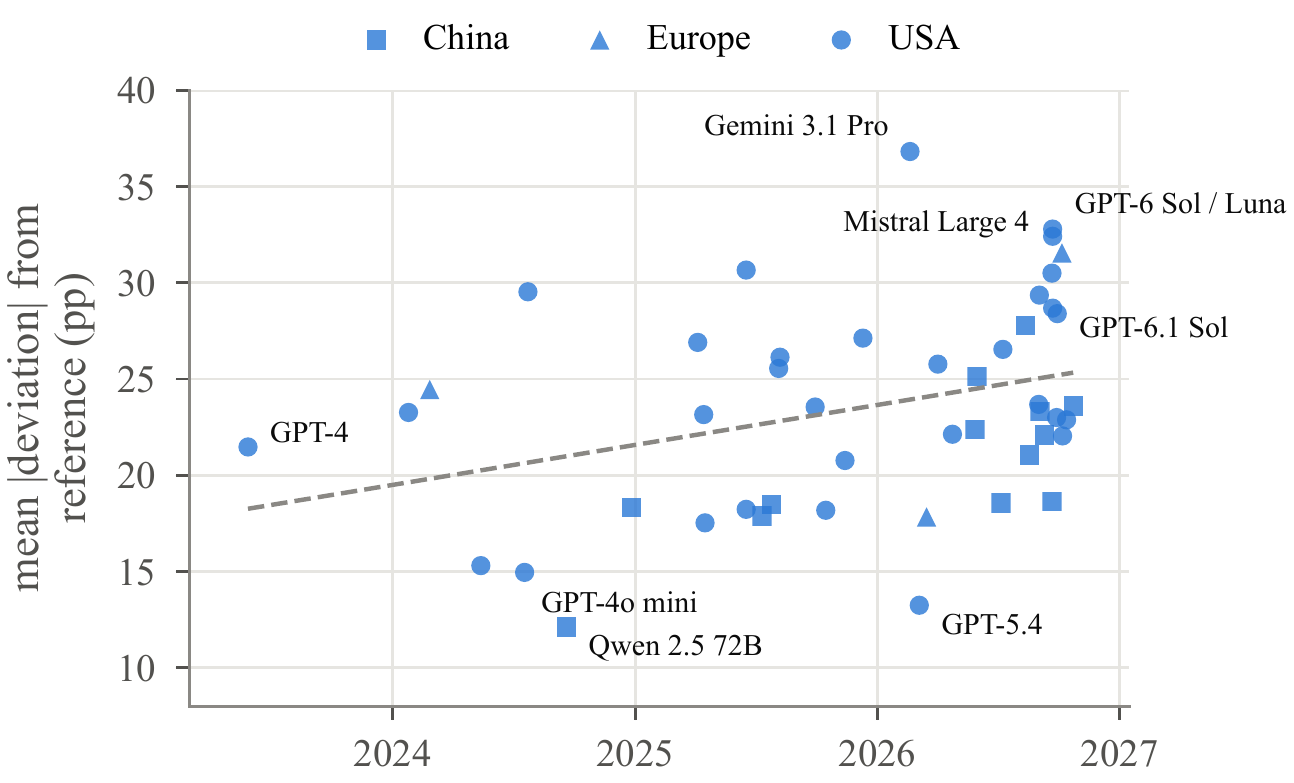
Вибір моделі змінює середнє відхилення з 12 до 37 відсоткових пунктів, але його не пояснює жоден простий чинник.
Відхилення від довідкових значень не зменшується для новіших моделей; воно дещо зростає (ρ Спірмена = 0,36, p = 0,013, 47 моделей API). Найближчими були Qwen 2.5 72B, GPT-5.4 і GPT-4o mini; найбільш віддаленими — Gemini 3.1 Pro, GPT-6 Sol і GPT-6 Luna. Gemini 3.1 Pro має протилежну до більшості моделей типову відповідь: переважно чоловіки для депресії, соціальної тривожності й PTSD, зовсім немає жінок для ADHD й аутизму, але 100% жінок для межового РО. Переважання чоловіків — це інше упередження, а не менше упередження.
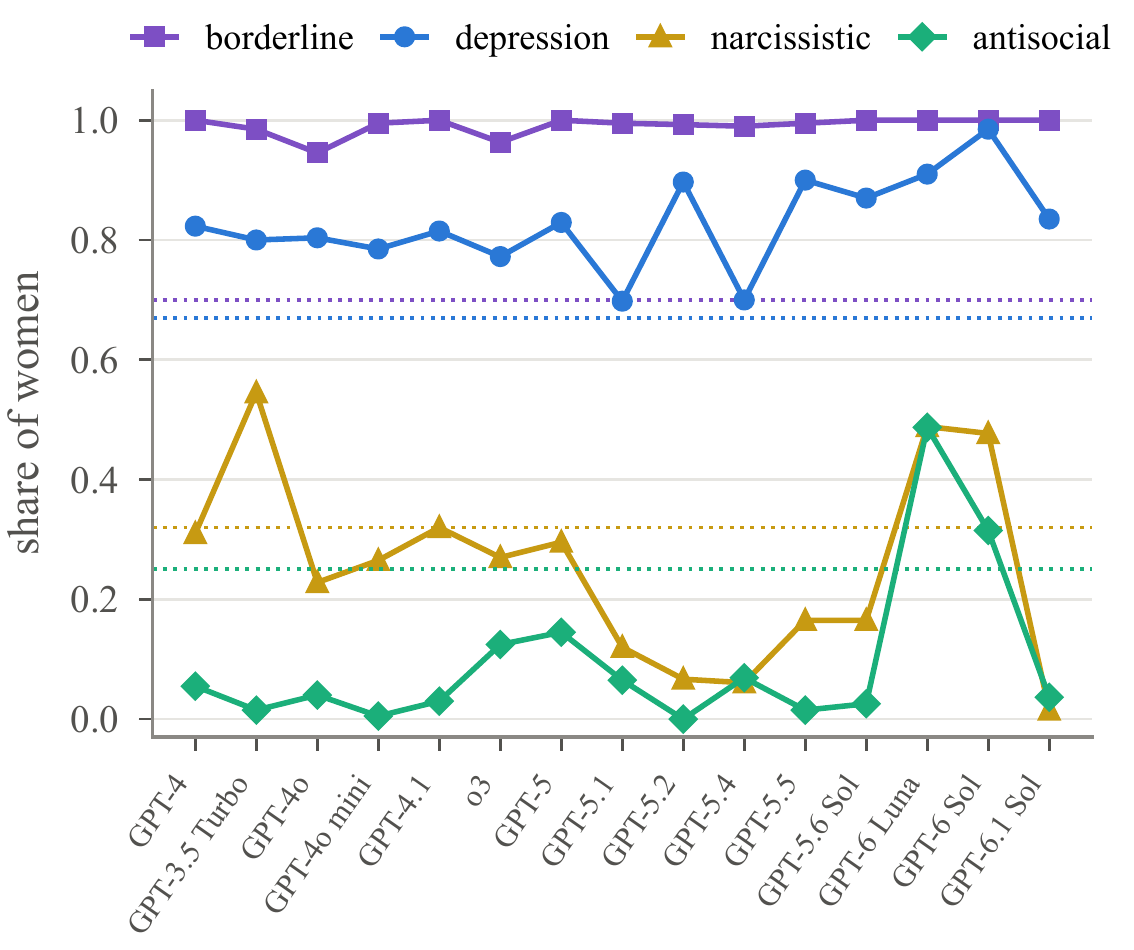
У серії OpenAI типові відповіді щодо розладів особистості змінюються між послідовними випусками, що вказує на їхню ймовірну зумовленість посттренуванням, а не на стабільну властивість. Відмінності між розробниками зі США, Китаю та Європи невеликі. Сім локальних моделей не були гіршими за моделі API; польська PLLuM 12B була серед найближчих до довідкових значень, а Bielik 11B була єдиною моделлю, що збіглася з довідковим значенням для антисоціального РО.
Мова запитання змінює відповідь
Той самий запит іспанською дає більше жінок, а китайською — більше чоловіків.
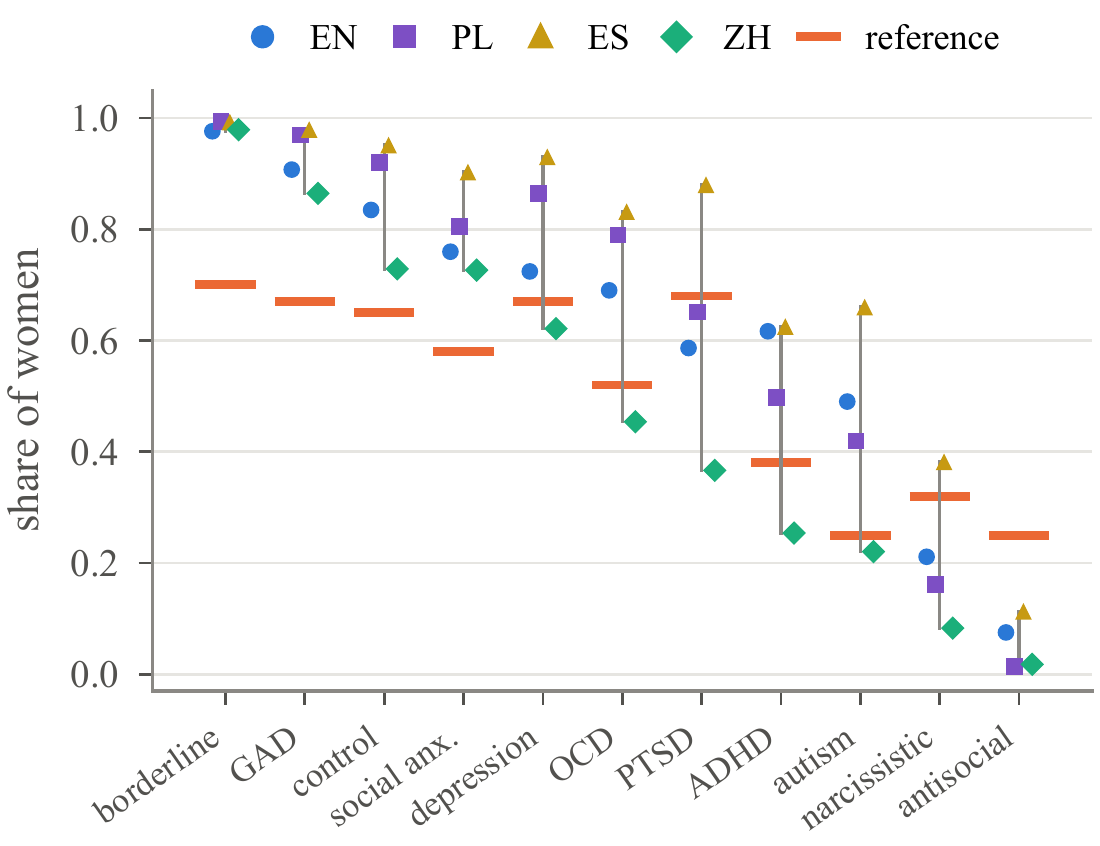
Запити іспанською дають на 12,5 відсоткового пункта більше жінок, ніж англійською (у 43 із 54 моделей показник вищий), а китайською — на 14,5 пункта менше (у 41 із 54 нижчий). У середньому польська не відрізняється від англійської (+1,5 пункта), хоча для нейтрального контрольного запиту вона дає 92% жінок проти 83% англійською. Граматичний рід — не єдине пояснення: у польській та іспанській слово «людина» має жіночий рід, але результати все одно різняться. Ефект найбільший там, де моделі найбільше розходяться (PTSD, OCD, ADHD, аутизм), і зникає на крайніх значеннях, де в усіх мовах показники сягають межі.
Відмови трапляються рідко (1,0%), але зосереджені навколо розладів особистості: 3,7% відповідей для антисоціального РО проти 0,1% для контрольної умови. Одна модель відмовила у 99% запитів про антисоціальний РО, посилаючись на стигму. Небінарні відповіді становили 1,2% усіх відповідей і траплялися майже виключно англійською.
Що це означає
Схоже, моделі засвоюють із текстів напрямок статевих відмінностей, а потім описують найтиповішу людину замість того, щоб відтворювати реальне різноманіття.
- Для навчальних клінічних матеріалів. Стажист, який зустрічає лише жінок із межовим РО та чоловіків з антисоціальним РО, може засвоїти сильніше апріорне уявлення, ніж виправдовують епідеміологічні дані, саме для тих станів, де документовано надмірну діагностику в жінок (межовий РО) і недостатню діагностику в жінок (аутизм, ADHD).
- Для всіх, хто генерує синтетичних пацієнтів або тестові набори. Явно задавайте гендер та інші демографічні характеристики відповідно до цільового розподілу, а не залишайте цей вибір моделі, і перевіряйте згенеровані когорти за довідковими співвідношеннями.
- Для вибору моделі. У нашій вибірці ані новизна, ані регіон, розмір чи локальне розгортання не передбачали упередженість, а між випусками вона змінювалася. Вимірюйте її для кожної версії моделі, яку розгортаєте.
Чого це дослідження не показує
- Один шаблон запиту. Результати описують типову поведінку у відповідь на короткий запит без системного запиту й клінічного контексту; у розгорнутих застосунках результати можуть відрізнятися.
- Приблизні довідкові значення. Співвідношення за статтю різняться залежно від країни, умов і діагностичної практики; у клінічних вибірках для межового РО переважають жінки, тоді як у загальних опитуваннях показники ближчі до рівності.
- Переклад і граматичний рід. Назви розладів переклали ми, і в кожній мові вони можуть мати різні конотації.
- Маршрутизація API. Модель можуть надавати різні провайдери; провайдера кожного виклику зафіксовано в наборі даних.
- Бінарний аналіз відповідей «жінка/чоловік»; інші відповіді наведено окремо. Розбір виконується за правилами й пройшов аудит для кожної моделі.
Читайте статтю, перевіряйте числа
Статтю можна безкоштовно завантажити. Повний набір даних відкрито на Zenodo і Hugging Face; ми також можемо надіслати його вам у ZIP-архіві.
Стаття
Language Models Know Which Way Mental Disorders Skew by Sex, and Exaggerate It: A 54-Model, Four-Language Audit. Bartłomiej Głowacki, Joanna Głowacka, Ewa Cylwik, Bohdan Głowacki. AITHENTICA P.S.A. / Therapy Support, 2026. Препринт.
Набір даних: Zenodo, DOI 10.5281/zenodo.23676720 · Hugging Face
Отримати пакет даних електронною поштою
PDF статті, усі 118 800 відповідей із розібраними полями, запити чотирма мовами, довідкові значення, код аналізу та рисунки.
Ми не передаємо адреси іншим. Посилання на дані надійде за кілька хвилин.
Що міститься в ZIP-архіві
paper/: стаття у форматі PDFdata/responses.csvі.parquet: кожна відповідь із назвою моделі, мовою, умовою, вихідним текстом і розібраними ім’ям, гендером, віком та професієюdata/prompts.csv,models.csv,reference_share_female.csv,summary_model_language_condition.csvcode/: скрипти збирання даних, розбору й аналізуfigures/: рисунки з цієї сторінкиREADME.md: опис набору даних. Ліцензія CC BY 4.0.
Як цитувати
@misc{glowacki2026genderbias,
  title  = {Language Models Know Which Way Mental Disorders Skew by Sex, and Exaggerate It: A 54-Model, Four-Language Audit},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and Cylwik, Ewa and G{\l}owacki, Bohdan},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support. Dataset: doi:10.5281/zenodo.23676720},
  url    = {https://aitherapy.support/research/llm-gender-bias-mental-health/}
}