
Pieni malli, huolellisesti suunniteltu putki
Autoresearch-menetelmä, jolla kurotaan umpeen kuilua frontier-LLM-malleihin pitkien, useista dokumenteista koostuvien tekstien tiivistämisessä. Testattu ennen istuntoa laadituilla yhteenvedoilla, jotka koottiin kahden synteettisen potilaan transkripteista.
Edullinen malli voi päästä lähelle, jos se tekee vähemmän
Frontier-kielimallit tiivistävät pitkiä, useista dokumenteista koostuvia aineistoja hyvin, mutta niiden käyttäminen ennen jokaista tuotosta käy kalliiksi. Pienet mallit ovat edullisia, mutta kadottavat tietoa pitkistä syötteistä. Selvitimme, miten pitkälle edullinen malli voi päästä, kun se toimii huolellisesti suunnitellun putken osana ja sitä parannetaan automatisoidulla silmukalla, joka arvioi jokaisen muutoksen muilla malleilla ilman ihmisarvioijia.
Yli 30 version ja 16 sokkoarviointikierroksen aikana pienen mallin tulos painotetulla kultaisella tarkistuslistalla nousi 0,647:stä arvoon 0,846 (0,879, kun viiteaineistoton verifioija valitsee parhaan kolmesta ajosta). Frontier-vertailutulos oli 0,782. LLM-valvojan tekemässä sokkoarvioinnissa näitä kahta ei voitu erottaa toisistaan tällä otoskoolla: parittaisten erojen keskiarvo oli +0,05 (SD 0,49). Sama, muuttumaton vertailuyhteenveto sai valvojalta 13 kierroksen aikana arvosanat 3,50–4,03, joten arvioijan oma kohina osoittautui itsessäänkin tulokseksi.
Sisällys
Pitkä syöte, kiinteä rakenne, rutiinikäyttö
Monilla käytännön tiivistystehtävillä on kolme yhteistä piirrettä: syöte on pitkä ja jakautuu useisiin dokumentteihin, tulos noudattaa kiinteää rakennetta ja sisältää lukumääriä, päivämääriä sekä sanatarkkaa näyttöä, ja tulos tuotetaan säännöllisesti, joten kustannuksilla on merkitystä.
Käytimme testialustana yhtä tällaista tehtävää: rakenteista yhteenvetoa, jonka kognitiivinen käyttäytymisterapeutti voi lukea noin kolmessa minuutissa ennen istuntoa. Siinä luetellaan keskeiset uskomukset istuntokohtaisine lukumäärineen, säännöt, toistuvat vääristymät, tyypilliset ABC-jaksot, testatut ennusteet, viimeisin istunto sekä asiat, jotka terapeutti voi haluta ottaa esiin tämän päivän istunnossa. Istuntoon 20 mennessä aineistoa on noin 130 000 sanaa.
Tehtävä soveltuu menetelmäkysymyksen tutkimiseen, koska sillä on tunnettu rakenne (Beckin kognitiivinen malli), luonteva todennettavan näytön muoto (potilaan sanatarkat ilmaukset) ja useita sudenkuoppia: terapeutin alun perin muotoilema uskomus tai vertaus, joka ei ole kuolemaa koskeva väite.
Kaksi synteettistä potilasta
Molemmat potilaat luotiin kerroksellisella synteettisen potilaan menetelmällämme (ensin profiililomake, terapeuttinen kaari, istuntosuunnitelma ja äänenkäyttöohje, minkä jälkeen istunnot tuotettiin yksi kerrallaan ASR-tyylisinä transkripteina). Anita: 20 istuntoa, 131 498 sanaa, J. Beckin tyylinen kognitiivinen käyttäytymisterapia. Markus: 12 istuntoa, 83 978 sanaa; terapeutti käyttää osittain skeematerapiaa, joten yhteenvedossa aineisto on muunnettava takaisin kognitiivisen käyttäytymisterapian käsitteiksi. Kummallekin potilaalle laadittiin kultainen vertailuyhteenveto itsenäisesti transkriptien kokonaisvaltaisen lukemisen perusteella. Oikeiden potilaiden tietoja ei käytetty.
Työnjako
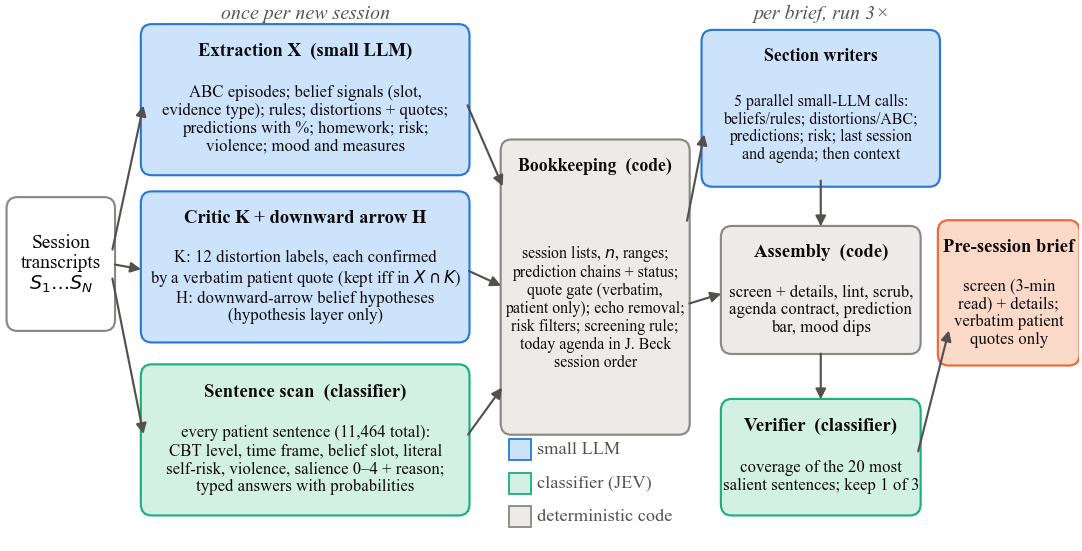
Ratkaisevat muutokset eivät liittyneet parempiin kehotteisiin vaan vastuiden uudelleenjakoon. Kukin komponentti tekee vain sen, missä se on hyvä.
Deterministinen koodi
Kaikki, mikä voidaan laskea, järjestää tai tarkistaa
Istuntoluettelot, uskomuskohtaiset lukumäärät ja vaihteluvälit; istuntojen yli linkitetyt ennusteketjut; sanatarkkojen lainausten tarkistus, joka hylkää kaikki lainaukset, joita ei löydy potilaan omista puheenvuoroista; terapeutin kaikujen poistaminen; ja versiosta 28 alkaen tämän päivän istunnossa ehdotettujen aiheiden järjestys. Kun tästä koodista löydetään virhe, se korjataan pysyvästi.
Lauseluokitin
Arviot, jotka eivät edellytä tekstin tuottamista
Jokainen potilaan lause (yhteensä 11 464) luokitellaan kerran: kognitiivisen käyttäytymisterapian taso (automaattinen ajatus, sääntö, uskomus, tunne, käyttäytyminen…), aikajänne (nykyinen tai muisteltu), kirjaimellinen tai kuvaannollinen ilmaisu sekä se, miten olennainen lause saattaa olla seuraavassa istunnossa; kaikille annetaan todennäköisyys. Sama luokitin toimii myöhemmin viiteaineistottomana verifioijana ja tarkistuslistan arvioijana.
Pieni kielimalli
Lyhyttä kirjoittamista valmistellun aineiston pohjalta
Pieni malli poimii jokaisesta istunnosta rakenteen, vahvistaa vääristymät sanatarkkojen lainausten avulla ja ehdottaa hypoteeseja (ne tallennetaan hypoteeseina, ei koskaan näyttönä). Kunkin yhteenvedon viisi osion kirjoittajaa toimivat rinnakkain; kukin näkee vain oman osionsa istuntonumeroilla merkityt tiedot, ja niitä ohjeistetaan olemaan keksimättä istuntunumeroita tai lainauksia.
Paras kolmesta ilman vastauksen näkemistä
Yhden version ajokertojen väliset erot olivat usein suurempia kuin versioiden väliset erot. Siksi yhteenvetotason putki suorittaa kolme ajoa, joista verifioija valitsee yhden: se poimii 20 olennaisinta potilaan lausetta ja pyytää luokitinta arvioimaan, näkyykö kukin niistä yhteenvedossa. Verifioija ei näe kultaista vertailuaineistoa eikä tarkistuslistaa.
Autoresearch-silmukka
Automaattinen kehityssilmukka noudattaa tuoreen automaattista kokeilua käsittelevän tutkimuksen henkeä: ehdota yhtä muutosta, suorita se ja säilytä se vain, jos kaksi riippumatonta mittaria tukevat sitä.
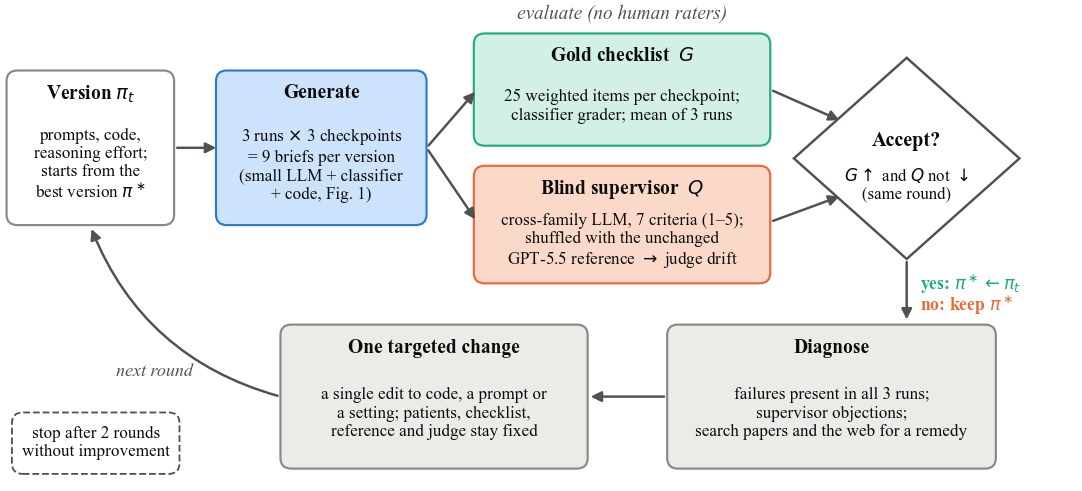
- Kaksi mittaria. Kunkin tarkistuspisteen 25 painotettua väitettä sisältävä kultainen tarkistuslista, jonka luokitin pisteyttää, sekä eri malliperheen LLM-valvojan tekemä sokkoarviointi, jossa pisteytetään seitsemän kriteeriä asteikolla 1–5.
- Kiinteä ankkuri. Valvoja näkee aina myös yhden muuttumattoman frontier-vertailuyhteenvedon satunnaisen kirjaimen alla, jolloin arvioijan oma ajautuminen mitataan kullakin kierroksella.
- Yksi muutos kerrallaan. Kaikissa kolmessa ajossa esiintyvät virheet ja valvojan huomautukset ohjaavat kirjallisuushakuun perustuvaa, kunkin kierroksen yhtä kohdennettua muutosta.
- Kiinteä pysäytyssääntö. Kaksi peräkkäistä kierrosta ilman parannusta päättää silmukan. Se pysähtyi versioon v28.
- Kiinteä kustannusraja. Putkessa ei saa käyttää mallia, joka on pienempää mallia tai luokitinta kalliimpi.
Mitä havaitsimme
Kuvailevat tunnusluvut kolmessa tarkistuspisteessä (Anita ennen istuntoja 13 ja 20, Markus ennen istuntoa 12) ja kolme ajoa versiota kohden.
Sisällön kattavuus: kultainen tarkistuslista
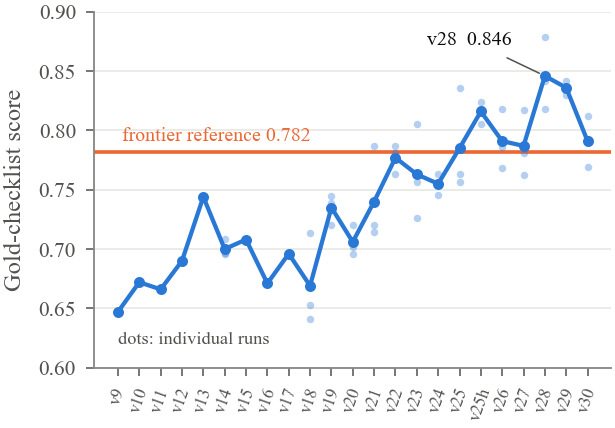
Pieni malli aloitti selvästi vertailumallia heikommalla tuloksella (0,647 vs. 0,782), ohitti sen versiossa v25 ja saavutti arvon 0,846 versiossa v28. Kaikki kolme v28-ajoa (0,818, 0,842, 0,879) ylittävät vertailutuloksen. Kaksi myöhempää versiota eivät parantaneet v28:n tulosta, ja silmukka pysähtyi.
| Anita, ennen istuntoa S13 | Anita, ennen istuntoa S20 | Markus, ennen istuntoa S12 | |
|---|---|---|---|
| v28, 3 ajon keskiarvo | 0,963 | 0,800 | 0,776 |
| v28, paras kolmesta (verifioija) | 0,963 | 0,836 | 0,836 |
| GPT-5.5-vertailu (1 ajo) | 0,963 | 0,655 | 0,727 |
Keskiarvot tarkistuspisteissä: v28 0,846 · paras kolmesta 0,879 · vertailu 0,782.
Sokkoarviointi: arvioijan kohinan rajoissa
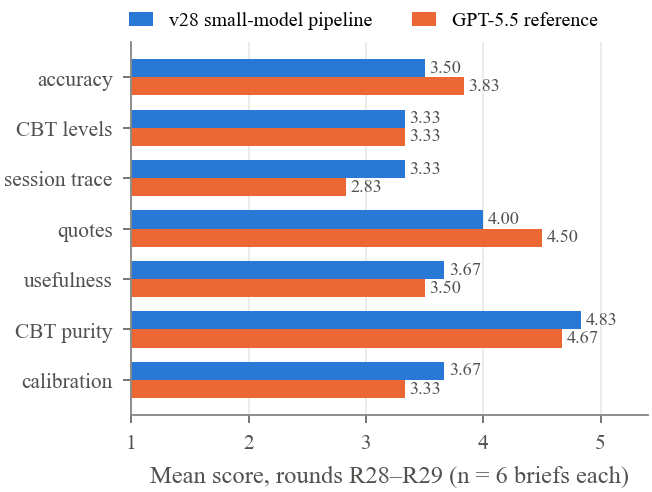
Loppukierroksilla parhaan pienen mallin version ja vertailumallin pisteet olivat 3,77 vs. 3,87 (R28) ja 3,77 vs. 3,57 (R29). Kuudessa saman kierroksen parissa erot olivat −0,4, +0,2, −0,1, −0,5, +0,9 ja +0,2: keskiarvo +0,05, SD 0,49. Kumpikaan järjestelmä ei saavuttanut valvojan tavoitekeskiarvoa 4,0. Kriteereittäin v28 oli parempi istuntojen jäljitettävyydessä ja kalibroinnissa, heikompi tarkkuudessa (yhtäpitävyys kultaisen vertailuaineiston kanssa) ja lainauksissa sekä samalla tasolla kognitiivisen käyttäytymisterapian tasoissa.
Kustannukset
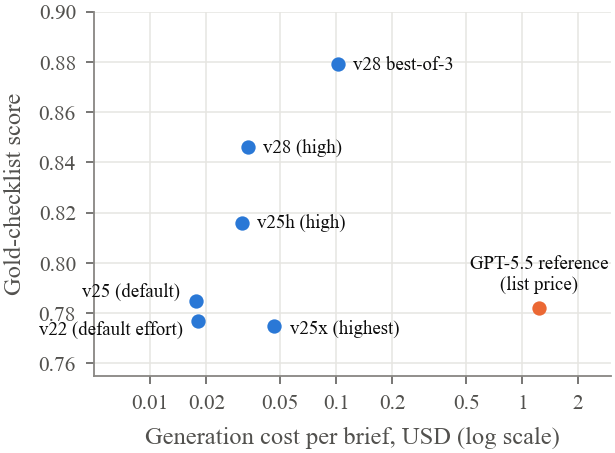
Yksi v28-yhteenveto maksaa osioiden kirjoittamisessa noin 0,03 USD ja kestää 2,5–3 minuuttia; paras kolmesta -yhteenveto noin 0,11 USD. Uuden istunnon käsittely lisää kustannuksia noin 0,07 USD, pääasiassa luokittimen jokaiselle lauseelle tekemän käsittelyn vuoksi. Listahinnoilla frontier-vertailuyhteenveto maksaa noin 19 kertaa yhden v28-yhteenvedon verran. Koko projektiin kului pienen mallin tokeneihin 5,57 USD.
Mikä auttoi ja mikä ei
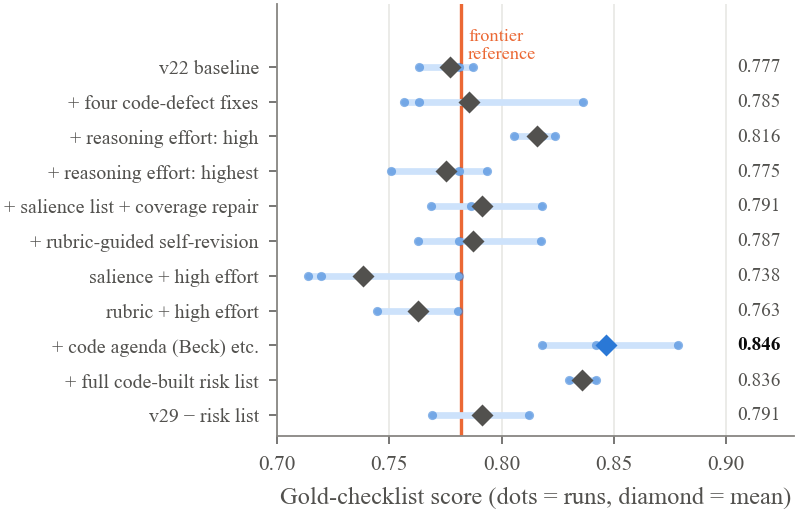
Kolme asiaa auttoi: valvojan löytämien deterministisen koodin virheiden korjaaminen, osion kirjoittajille asetettu korkea päättelypanostus (korkein asetus maksoi enemmän ja tuotti heikomman tuloksen) sekä ehdotetun asialistan, ennustekoon ja viimeisimmän riskiaiheisen lausuman siirtäminen koodiin. Useat uskottavilta vaikuttaneet lisäykset heikensivät tulosta: kolmen luonnoksen yhdistäminen, koodin määräämä uskomusten aikajana, olennaisuutta koskevat vihjeet yhdistettynä kattavuuden korjausvaiheeseen sekä kriteeristöohjattu itsekorjaus. Kukin niistä lisäsi generointivaiheen, jossa pieni malli voi kadottaa tai vääristää tietoa. Kaikki muutokset, jotka vähensivät mallin tekemää työtä tai valitsivat tuotoksista kirjoittamatta niitä uudelleen, olivat turvallisia.
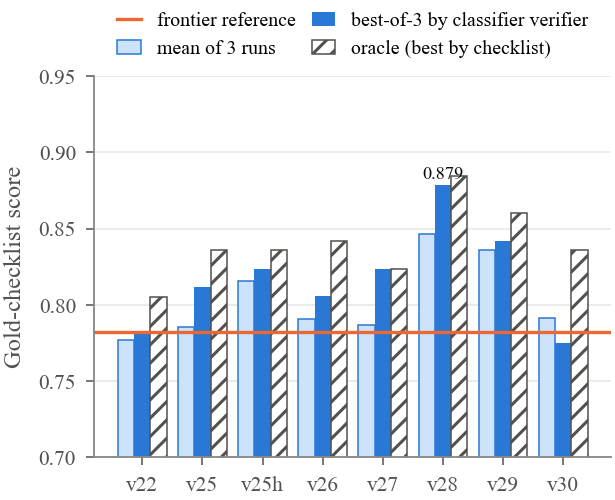
Verifioijan tekemä valinta paransi tarkistuslistatulosta kahdeksasta versiosta seitsemässä; versiossa v28 tulos nousi arvosta 0,846 arvoon 0,879, lähelle oraakkelin tulosta (0,885). Koska verifioija ja tarkistuslistan arvioija ovat sama luokitin, osa parannuksesta saattaa heijastaa niiden yhteisiä preferenssejä.
Mikä jäi vaikeaksi
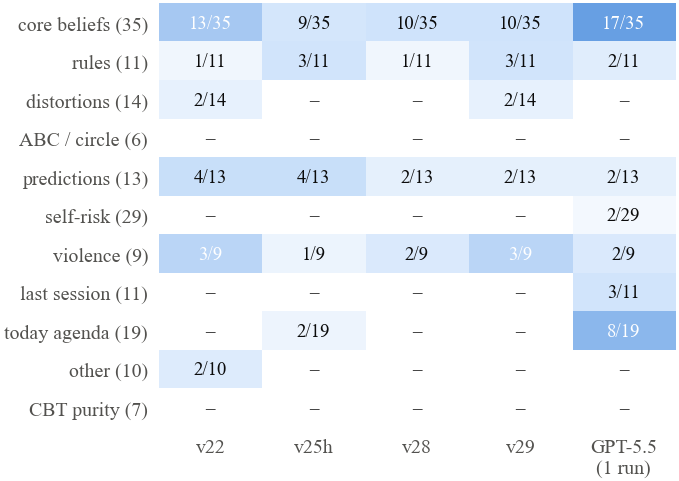
Toistuvat virheet vähenivät 25:stä 15:een 164 painotusyksiköstä versioiden v22 ja v28 välillä. Jäljelle jäävät kognitiivisen mallin hienovaraisimmat tulkinnat: uskomuksen tila sen aktivoitumisen jälkeen, uskomusten vaihteluvälit, jotka päättyvät ennen uusinta aineistoa, sekä soveltamisalan rajaukset. Riskiaiheiset ilmaukset olivat vaikein osa-alue: sekä tuoreen lausuman puuttuminen että vertauksen, harjoituksen tai tunnearvion tulkitseminen signaaliksi johti pistevähennykseen. Parhaassa ratkaisussa säilytettiin vain viimeisin kirjaimellinen lausuma ja istunto, jossa terapeutti oli viimeksi kysynyt asiasta suoraan, ja kaikki tulkinnat jätettiin terapeutille.
Arvioija on osa koetta
Koska vertailuyhteenveto ei koskaan muuttunut, sen pisteet mittaavat ainoastaan valvojaa.
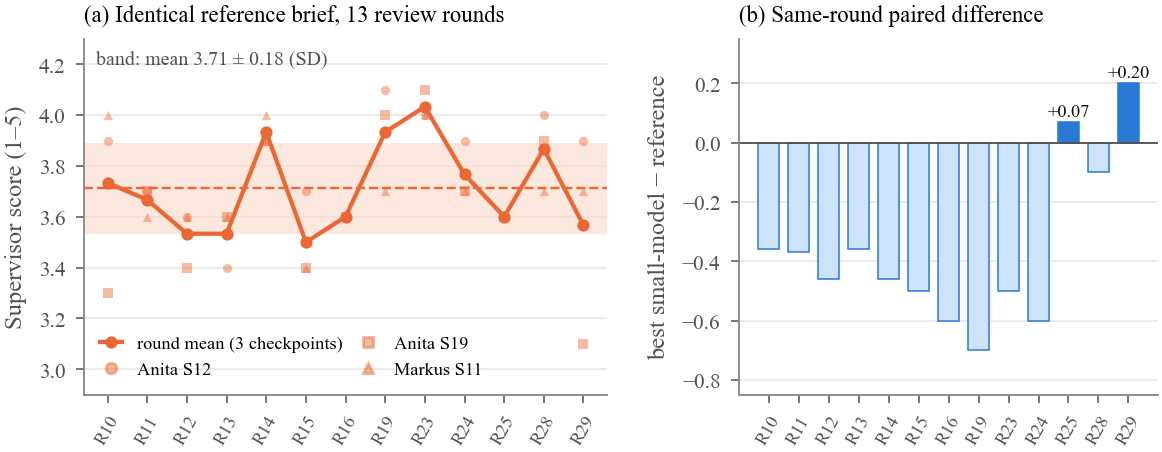
13 kierroksen aikana saman vertailuyhteenvedon kierroskohtainen keskiarvo oli 3,71, SD 0,18 ja vaihteluväli 3,50–4,03 asteikolla 1–5. Yksittäisissä kriteereissä SD oli jopa 0,46; tämä koski myös skriptillä varmennettuja lainauksia, jotka olivat joka kerta identtisiä. Kohinan suuruus on suunnilleen sama kuin koko silmukan samalla asteikolla tuottama parannus.
Mitä tämä tutkimus ei osoita
- Vain synteettistä aineistoa. Kaksi synteettistä potilasta, kolme tarkistuspistettä ja kolme ajoa versiota kohden. Vain kuvailevia tunnuslukuja, ei merkitsevyystestejä. Tulosten sovellettavuudesta muihin tehtäviin ja todelliseen aineistoon esitetään perusteluja, mutta sitä ei osoiteta.
- Arviointi perustui ainoastaan malleihin. Tutkimukseen ei osallistunut kliinikkoja eikä muita ihmisarvioijia, tarkoituksella. Pisteet kuvaavat yhtäpitävyyttä kultaisen tarkistuslistan ja LLM-valvojan arvion kanssa, eivät kliinistä laatua, turvallisuutta tai mitään vaikutusta terapiaan.
- Arviointiaineistoon viritetty. Kaikki versiot kehitettiin samoilla tarkistuspisteillä ja arvioijilla, joten lopulliset pisteet ovat optimistisia. Asianmukainen testi edellyttäisi erillään pidettyä potilasta.
- Erottamattomuus ei tarkoita paremmuutta. Sokkoarvioinnissa pientä mallia ja frontier-vertailua ei voitu erottaa toisistaan tällä otoskoolla; erot jäävät arvioijan oman kohinan rajoihin.
- Sama luokitin. Tarkistuslistan arvioija, lauseskanneri ja verifioija ovat sama malli.
- Vaatimaton vertailukohta. Frontier-vertailu on yksi aiempi, optimoimaton putkiajo, joka suoritettiin kerran GPT-5.5:llä, ei samalla silmukalla viritetty frontier-putki.
Lue artikkeli ja tarkista luvut
Koko artikkelin voi ladata maksutta. Tarkistuslistat, pisteet ja esimerkkitiivistelmät sisältävä aineistopaketti toimitetaan sähköpostitse.
Artikkeli
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Esijulkaisu, 13 sivua, 9 kuvaa.
Lataa aineistopaketti
Artikkelin PDF, kaikki yhdeksän kuvaa, kolme kultaista tarkistuslistaa, kaikkien versioiden tarkistuslista- ja verifioijapisteet, loppukierrosten sokkoarvioinnit kirjainavaimineen sekä kolme lopullista esimerkkitiivistelmää. README-tiedosto selittää kaikki kentät.
Emme jaa sähköpostiosoitteita. Linkki aineistoon saapuu muutamassa minuutissa.
ZIP-tiedoston sisältö
paper/: artikkeli PDF-muodossafigures/: yhdeksän kuvaa sekä niiden taustalla olevat luvutscores/gold_checklists.json: 3 × 25 painotettua väitettäscores/checklist_results.json: kohdekohtaiset todennäköisyydet 198 arvioidulle yhteenvedollescores/blind_review_R28.json,R29: seitsemän kriteeriä, arviot ja huomautukset sekä kirjainavaimetexample-briefs/: kolme lopullista v28-yhteenvetoa (puolaksi, kuten transkriptit)
Ei sisällä: synteettisiä transkripteja, kehotteita eikä koodia. Niitä voi pyytää kirjoittajilta tutkimuskäyttöön.
Viittausohje
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}