
Modello piccolo, pipeline accurata
Un metodo di autoresearch per ridurre il divario rispetto agli LLM di frontiera nella sintesi lunga di più documenti. Testato su briefing pre-sessione creati a partire dalle trascrizioni di due pazienti sintetici.
Un modello economico può avvicinarsi, se fa meno
I modelli linguistici di frontiera sintetizzano bene materiali lunghi e composti da più documenti, ma usarne uno prima di ogni output diventa costoso. I modelli piccoli costano poco, ma perdono informazioni quando gli input sono lunghi. Ci siamo chiesti fin dove possa arrivare un modello a basso costo se inserito in una pipeline progettata con cura e migliorato da un ciclo automatizzato che valuta ogni modifica con altri modelli, senza valutatori umani.
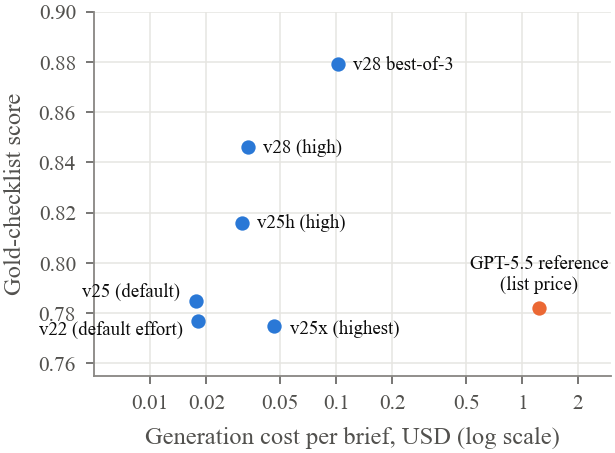
In oltre 30 versioni e 16 cicli di revisione in cieco, il modello piccolo è passato da 0.647 a 0.846 su una checklist di riferimento ponderata (0.879 selezionando la migliore di tre esecuzioni con un verificatore senza riferimento). Il riferimento di frontiera ha ottenuto 0.782. Nella revisione in cieco da parte di un supervisore LLM, a questa numerosità campionaria non è stato possibile distinguere i due sistemi: la differenza media appaiata era +0.05 (DS 0.49). Lo stesso briefing di riferimento, rimasto invariato, ha ricevuto dal supervisore punteggi compresi tra 3.50 e 4.03 in 13 cicli, perciò il rumore del valutatore si è rivelato a sua volta un risultato.
Indice
Input lungo, struttura fissa, uso ricorrente
Molte attività pratiche di sintesi hanno tre caratteristiche in comune: l'input è lungo e distribuito su numerosi documenti, l'output segue una struttura fissa con conteggi, date e prove testuali, e viene prodotto regolarmente, quindi il costo è importante.
Abbiamo usato come banco di prova un'attività di questo tipo: un briefing strutturato che un terapeuta CBT può leggere in circa tre minuti prima di una seduta. Elenca le convinzioni di base con il numero di sedute, le regole, le distorsioni ricorrenti, gli episodi ABC tipici, le previsioni verificate, l'ultima seduta e gli aspetti che il terapeuta potrebbe voler affrontare nella seduta di oggi. Alla seduta 20 il materiale è di circa 130,000 parole.
Questa attività è adatta a una domanda metodologica perché ha una struttura nota (il modello cognitivo di Beck), una nozione naturale di prova verificabile (le parole testuali del paziente) e diverse insidie: una convinzione formulata inizialmente dal terapeuta oppure una metafora che non costituisce un'affermazione sulla morte.
Due pazienti sintetici
Entrambi i pazienti sono stati generati con il nostro metodo stratificato per pazienti sintetici (prima una scheda del profilo, un percorso terapeutico, un piano delle sedute e una guida alla voce; poi le sedute sono state generate una alla volta come trascrizioni in stile ASR). Anita: 20 sedute, 131,498 parole, CBT in stile J. Beck. Markus: 12 sedute, 83,978 parole, con un terapeuta che lavora in parte con la terapia degli schemi, per cui il briefing deve tradurre il materiale nei termini della CBT. Per ciascun paziente è stato redatto in modo indipendente un riferimento gold sulla base della lettura integrale delle trascrizioni. Non sono stati usati dati di pazienti reali.
Divisione del lavoro
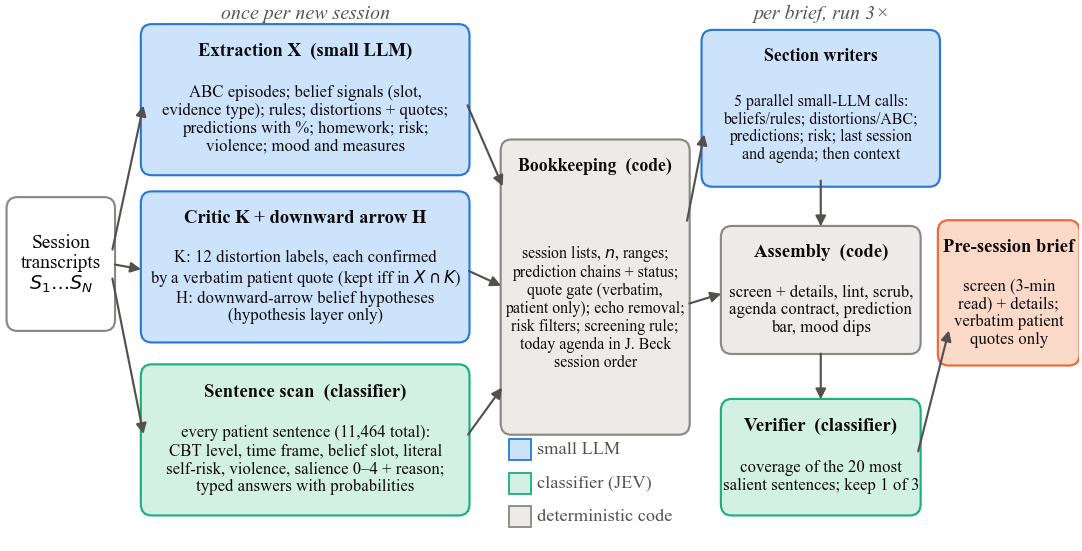
Le modifiche decisive non sono state prompt migliori, ma una riassegnazione delle responsabilità. Ogni componente fa soltanto ciò che sa fare bene.
Codice deterministico
Tutto ciò che si può contare, ordinare o verificare
Elenchi di sedute, conteggi e intervalli per ogni convinzione; catene di previsioni collegate tra le sedute; un filtro per le citazioni testuali che scarta ogni citazione non presente nelle parole del paziente; rimozione delle ripetizioni del terapeuta; e, dalla versione 28, l'ordine dei punti suggeriti per la seduta di oggi. Una volta individuato un difetto in questo codice, viene corretto in modo permanente.
Un classificatore di frasi
Valutazioni che non richiedono generazione di testo
Ogni frase del paziente (11,464 in totale) viene etichettata una volta: livello CBT (pensiero automatico, regola, convinzione, emozione, comportamento…), arco temporale (attuale o ricordato), formulazione letterale o figurata e possibile rilevanza della frase per la seduta successiva, ciascuno con una probabilità. Lo stesso classificatore viene poi usato come verificatore senza riferimento e come valutatore della checklist.
Un modello linguistico piccolo
Scrittura breve a partire da materiale preparato
Per ogni seduta, il modello piccolo estrae la struttura, conferma le distorsioni con citazioni testuali e propone ipotesi (registrate come ipotesi, mai come prove). Per ogni briefing, cinque redattori di sezione operano in parallelo; ciascuno vede solo i dati numerati per seduta della propria sezione e ha l'istruzione di non inventare numeri di seduta o citazioni.
La migliore di tre, senza guardare la risposta
Le differenze tra le esecuzioni della stessa versione erano spesso maggiori delle differenze tra versioni. Perciò la pipeline a livello di briefing viene eseguita tre volte e un verificatore ne seleziona una: prende le 20 frasi del paziente più rilevanti e chiede al classificatore se ciascuna è rispecchiata nel briefing. Il verificatore non vede il riferimento gold né la checklist.
Il ciclo di autoresearch
Un ciclo di sviluppo automatizzato nello spirito dei recenti lavori sulla sperimentazione automatizzata: proporre una modifica, eseguirla e mantenerla solo se due metriche indipendenti concordano.
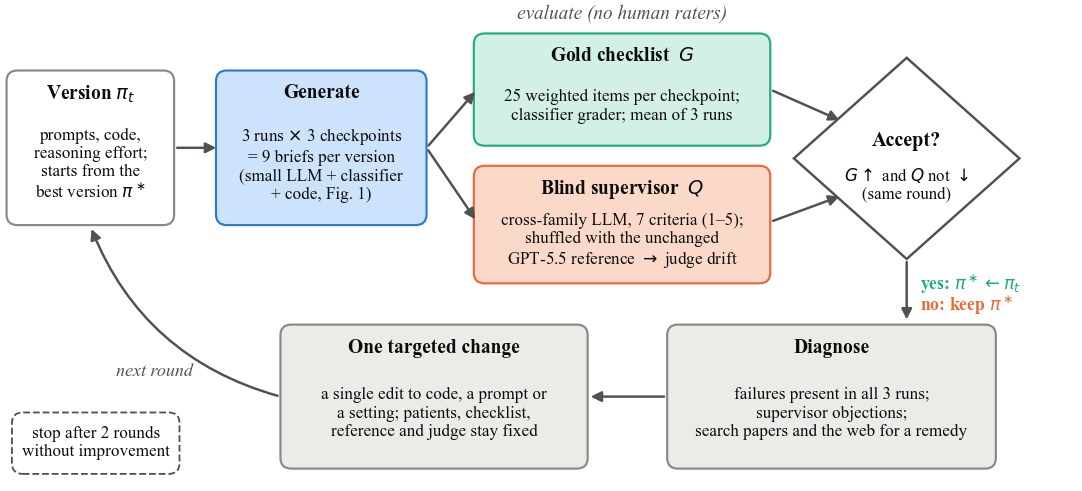
- Due metriche. Una checklist gold con 25 affermazioni ponderate per punto di controllo, valutate dal classificatore, e una revisione in cieco da parte di un supervisore LLM appartenente a una famiglia di modelli diversa, che assegna un punteggio a sette criteri su una scala da 1 a 5.
- Un riferimento fisso. Il supervisore vede sempre anche un briefing di riferimento di frontiera invariato, identificato da una lettera casuale, così da misurare la deriva del valutatore in ogni ciclo.
- Una modifica per volta. I problemi presenti in tutte e tre le esecuzioni e le obiezioni del supervisore determinano una modifica mirata per ciclo, informata da una ricerca bibliografica.
- Una regola di arresto fissa. Due cicli consecutivi senza miglioramenti interrompono il ciclo. Si è fermato a v28.
- Un tetto di spesa fisso. Nella pipeline non si può usare alcun modello più costoso del modello piccolo o del classificatore.
Cosa abbiamo osservato
Statistiche descrittive su tre punti di controllo (Anita prima delle sedute 13 e 20, Markus prima della seduta 12) e tre esecuzioni per versione.
Copertura dei contenuti: la checklist gold
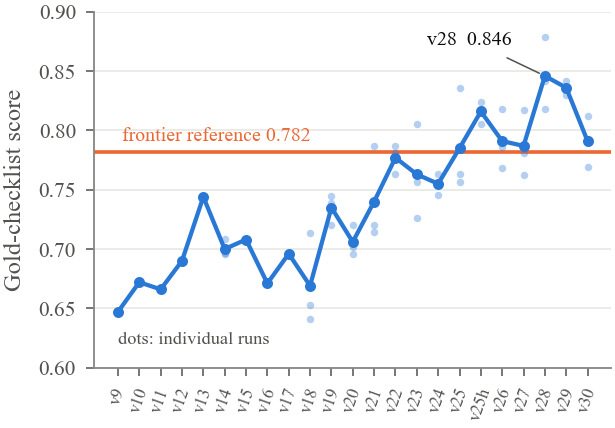
Il modello piccolo è partito ben al di sotto del riferimento (0.647 contro 0.782), lo ha superato a v25 e ha raggiunto 0.846 a v28. Tutte e tre le esecuzioni di v28 (0.818, 0.842, 0.879) sono superiori al riferimento. Due versioni successive non hanno migliorato v28 e il ciclo si è fermato.
| Anita, prima di S13 | Anita, prima di S20 | Markus, prima di S12 | |
|---|---|---|---|
| v28, media di 3 esecuzioni | 0.963 | 0.800 | 0.776 |
| v28, best-of-3 (verificatore) | 0.963 | 0.836 | 0.836 |
| Riferimento GPT-5.5 (1 esecuzione) | 0.963 | 0.655 | 0.727 |
Medie sui punti di controllo: v28 0.846 · best-of-3 0.879 · riferimento 0.782.
Revisione in cieco: entro il rumore del valutatore
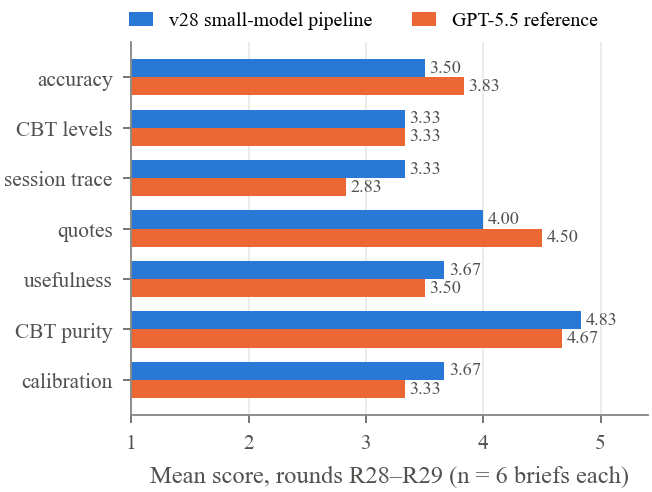
Nei cicli finali, la migliore versione del modello piccolo e il riferimento hanno ottenuto 3.77 contro 3.87 (R28) e 3.77 contro 3.57 (R29). Sulle sei coppie dello stesso ciclo, la differenza è stata −0.4, +0.2, −0.1, −0.5, +0.9, +0.2: media +0.05, DS 0.49. Nessuno dei due sistemi ha raggiunto la media obiettivo di 4.0 del supervisore. Per criterio, v28 era avanti nella tracciabilità delle sedute e nella calibrazione, indietro nell'accuratezza (concordanza con il riferimento gold) e nelle citazioni, e alla pari per i livelli CBT.
Costi
Un briefing v28 costa circa 0,03 USD per la redazione delle sezioni e richiede 2.5–3 minuti; un briefing best-of-3 costa circa 0,11 USD. L'elaborazione di una nuova seduta aggiunge circa 0,07 USD, soprattutto per il passaggio del classificatore su ogni frase. Ai prezzi di listino, il briefing di riferimento di frontiera costa circa 19 volte un singolo briefing v28. L'intero progetto ha utilizzato token del modello piccolo per un valore di 5,57 USD.
Cosa ha aiutato e cosa no
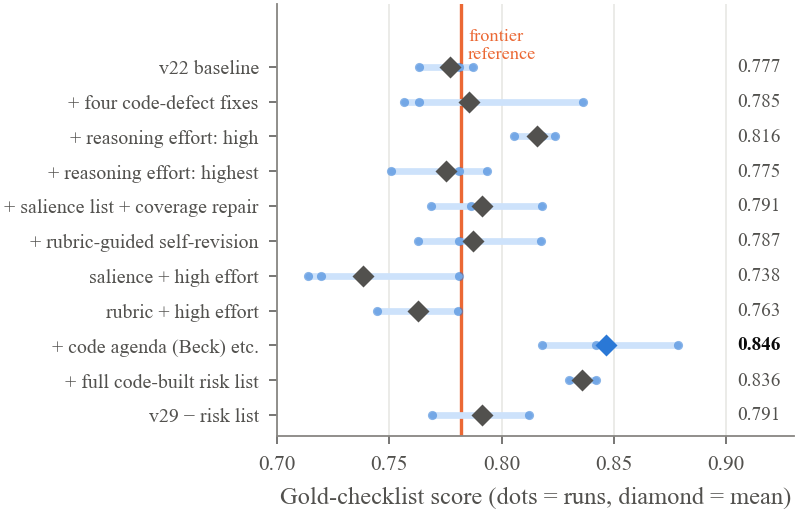
Tre elementi sono stati utili: correggere difetti nel codice deterministico individuati dal supervisore, un'impostazione alta dello sforzo di ragionamento per i redattori di sezione (l'impostazione più alta costava di più e otteneva punteggi inferiori) e spostare nel codice l'agenda suggerita, la barra delle previsioni e l'affermazione più recente relativa al rischio. Diverse aggiunte plausibili hanno peggiorato i risultati: fondere tre bozze, una cronologia delle convinzioni imposta dal codice, indicazioni sulla rilevanza con un passaggio di correzione della copertura e l'autorevisione guidata da rubriche. Ognuna aggiungeva un passaggio di generazione in cui un modello piccolo può perdere o distorcere informazioni. Tutte le modifiche che sottraevano lavoro al modello o selezionavano tra gli output senza riscriverli si sono dimostrate sicure.
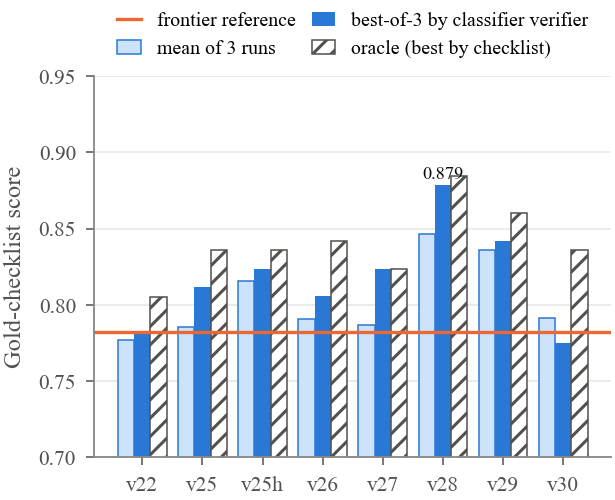
La selezione del verificatore ha migliorato il punteggio della checklist in sette versioni su otto; per v28, da 0.846 a 0.879, vicino all'oracolo (0.885). Poiché il verificatore e il valutatore della checklist sono lo stesso classificatore, parte di questo miglioramento potrebbe riflettere preferenze condivise.
Cosa è rimasto difficile
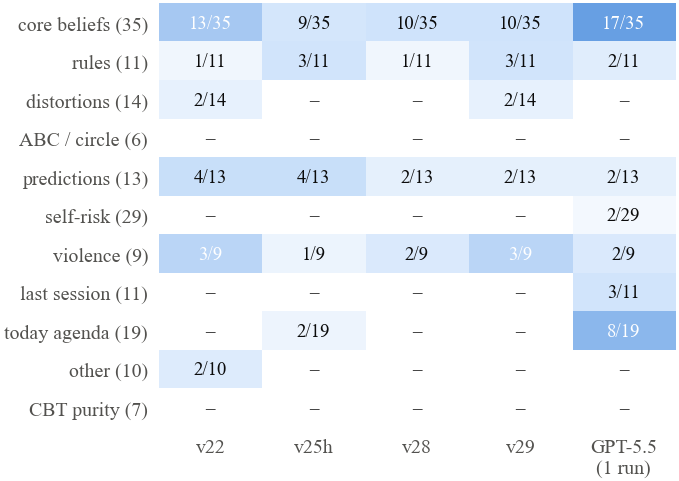
I problemi persistenti sono scesi da 25 a 15 unità di peso su 164 tra v22 e v28. Restano le valutazioni più sottili del modello cognitivo: lo stato di una convinzione dopo la sua riattivazione, gli intervalli delle convinzioni che si fermano prima del materiale più recente e le precisazioni sull'ambito. Le frasi relative al rischio sono state la componente più difficile: sono state penalizzate sia l'omissione di un'affermazione recente sia l'interpretazione di una metafora, di un esercizio o di una valutazione emotiva come segnale. Il progetto migliore conservava soltanto l'affermazione letterale più recente e la seduta in cui il terapeuta aveva posto la domanda direttamente l'ultima volta, lasciando ogni interpretazione al terapeuta.
Il valutatore fa parte dell'esperimento
Poiché il briefing di riferimento non è mai cambiato, i suoi punteggi misurano il solo supervisore.
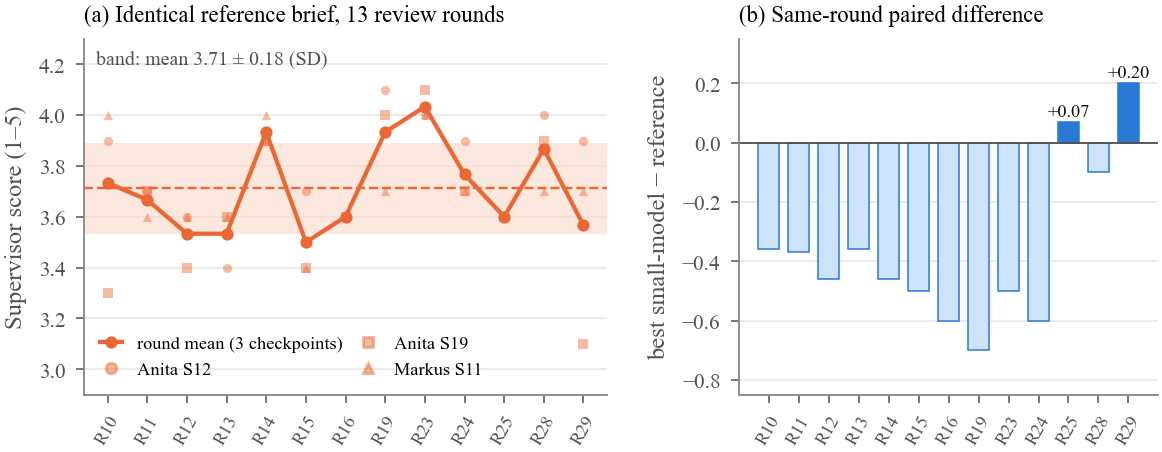
In 13 cicli, lo stesso briefing di riferimento ha ricevuto una media di ciclo di 3.71, con DS 0.18 e un intervallo di 3.50–4.03 su una scala da 1 a 5. Per i singoli criteri, la DS ha raggiunto 0.46, anche per le citazioni verificate tramite script e identiche ogni volta. Questo rumore è all'incirca pari all'intero miglioramento prodotto dal ciclo sulla stessa scala.
Cosa non dimostra questo studio
- Solo dati sintetici. Due pazienti sintetici, tre punti di controllo, tre esecuzioni per versione. Solo statistiche descrittive, nessun test di significatività. Il trasferimento ad altri compiti e a materiale reale è argomentato, non dimostrato.
- Solo valutazione basata su modelli. Per scelta, non hanno partecipato clinici né altri valutatori umani. I punteggi descrivono la concordanza con una checklist gold e il giudizio di un supervisore LLM, non la qualità clinica, la sicurezza o eventuali effetti sulla terapia.
- Ottimizzato sul set di valutazione. Tutte le versioni sono state sviluppate sugli stessi punti di controllo e con gli stessi valutatori, quindi i punteggi finali sono ottimistici. La prova appropriata sarebbe usare un paziente tenuto fuori dal set.
- Indistinguibile non significa migliore. Nella revisione in cieco, a questa numerosità campionaria non è stato possibile distinguere il modello piccolo dal riferimento di frontiera; le differenze rientrano nel rumore del valutatore stesso.
- Classificatore condiviso. Il valutatore della checklist, lo scanner delle frasi e il verificatore sono lo stesso modello.
- Un riferimento modesto. Il riferimento di frontiera è una singola esecuzione precedente e non ottimizzata della pipeline con GPT-5.5, non una pipeline di frontiera ottimizzata con lo stesso ciclo.
Leggi l'articolo, verifica i numeri
L'articolo completo si può scaricare gratuitamente. Il pacchetto dati con checklist, punteggi e briefing di esempio è inviato via email.
L'articolo
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Preprint, 13 pagine, 9 figure.
Scarica il pacchetto dati
PDF dell'articolo, tutte e nove le figure, le tre checklist gold, i punteggi della checklist e del verificatore per ogni versione, le revisioni in cieco dei cicli finali con le rispettive chiavi delle lettere e tre briefing finali di esempio. Un README descrive ogni campo.
Non condividiamo gli indirizzi. Il link ai dati arriva entro pochi minuti.
Contenuto dello ZIP
paper/: l'articolo in PDFfigures/: nove figure e i relativi dati numericiscores/gold_checklists.json: 3 × 25 affermazioni ponderatescores/checklist_results.json: probabilità per elemento per 198 briefing valutatiscores/blind_review_R28.json,R29: sette criteri, verdetti e obiezioni, con le chiavi delle lettereexample-briefs/: tre briefing finali v28 (in polacco, come le trascrizioni)
Non inclusi: trascrizioni sintetiche, prompt e codice. Sono disponibili dagli autori su richiesta per uso di ricerca.
Come citare
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}