
Modelo pequeño, pipeline cuidadoso
Un método de autoresearch para reducir la brecha con los LLM de frontera en la síntesis de documentos largos y múltiples. Probado con resúmenes previos a las sesiones elaborados a partir de las transcripciones de dos pacientes sintéticos.
Un modelo barato puede acercarse si hace menos
Los modelos lingüísticos de frontera resumen bien material extenso y compuesto por múltiples documentos, pero ejecutar uno antes de cada resultado resulta caro. Los modelos pequeños son baratos, pero pierden información con entradas largas. Nos preguntamos hasta dónde puede llegar un modelo de bajo coste integrado en un pipeline diseñado cuidadosamente y mejorado mediante un ciclo automatizado que evalúa cada cambio con otros modelos, sin evaluadores humanos.
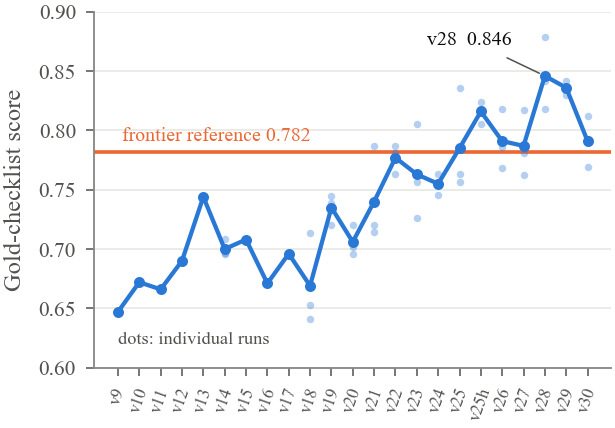
En más de 30 versiones y 16 rondas de revisión a ciegas, el modelo pequeño pasó de 0.647 a 0.846 en una lista de verificación de referencia ponderada (0.879 cuando un verificador sin referencia selecciona la mejor de tres ejecuciones). La referencia de frontera obtuvo 0.782. En una revisión a ciegas realizada por un supervisor LLM, no se pudieron distinguir ambos modelos con este tamaño de muestra: la diferencia media emparejada fue de +0.05 (DE 0.49). El mismo resumen de referencia, sin cambios, recibió puntuaciones de entre 3.50 y 4.03 de ese supervisor a lo largo de 13 rondas; por tanto, el propio ruido del evaluador resultó ser un hallazgo en sí mismo.
Contenido
Entrada extensa, estructura fija, uso habitual
Muchas tareas prácticas de síntesis comparten tres características: la entrada es extensa y está repartida entre numerosos documentos; el resultado sigue una estructura fija con recuentos, fechas y pruebas textuales literales; y se genera habitualmente, por lo que el coste importa.
Usamos una tarea de este tipo como banco de pruebas: un resumen estructurado que un terapeuta de TCC puede leer en unos tres minutos antes de una sesión. Enumera las creencias fundamentales con el número de sesiones, las reglas, las distorsiones recurrentes, los episodios ABC típicos, las predicciones puestas a prueba, la última sesión y los temas que el terapeuta quizá quiera abordar en la sesión de hoy. Para la sesión 20, el material alcanza unas 130,000 palabras.
La tarea resulta adecuada para una pregunta metodológica porque tiene una estructura conocida (el modelo cognitivo de Beck), una noción natural de evidencia verificable (las palabras textuales del paciente) y varias trampas: una creencia formulada inicialmente por el terapeuta o una metáfora que no constituye una afirmación sobre la muerte.
Dos pacientes sintéticos
Ambos pacientes se generaron mediante nuestro método por capas de pacientes sintéticos (primero, una ficha de perfil, un arco terapéutico, un plan de sesiones y una guía de voz; después, sesiones generadas una a una como transcripciones al estilo ASR). Anita: 20 sesiones, 131,498 palabras, TCC al estilo de J. Beck. Markus: 12 sesiones, 83,978 palabras, con un terapeuta que trabaja en parte con terapia de esquemas, por lo que el resumen debe traducir el material de nuevo a términos de TCC. Para cada paciente, se redactó una referencia de referencia de forma independiente, tras leer íntegramente las transcripciones. No se utilizaron datos de pacientes reales.
División del trabajo
Los cambios decisivos no consistieron en mejorar los prompts, sino en reasignar responsabilidades. Cada componente hace únicamente aquello para lo que está capacitado.
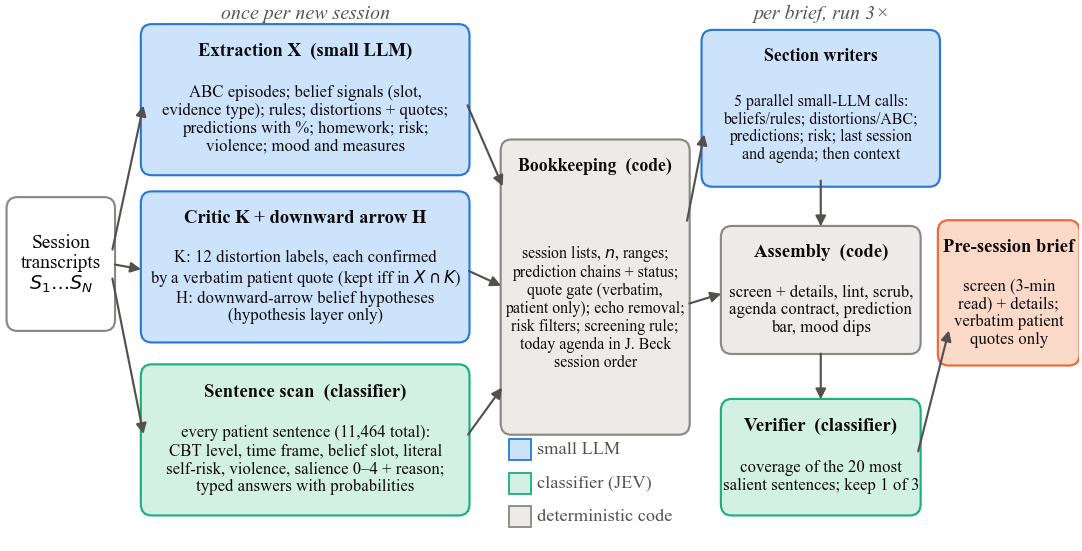
Código determinista
Todo lo que se puede contar, ordenar o verificar
Listas de sesiones, recuentos y rangos para cada creencia; cadenas de predicciones enlazadas entre sesiones; un filtro de citas textuales que descarta toda cita que no aparezca en las propias intervenciones del paciente; eliminación de ecos del terapeuta y, desde la versión 28, el orden de los temas sugeridos para la sesión de hoy. Una vez detectado un defecto en este código, queda corregido.
Un clasificador de frases
Evaluaciones que no requieren generar texto
Cada frase del paciente (11,464 en total) se etiqueta una vez: nivel de TCC (pensamiento automático, regla, creencia, emoción, conducta…), marco temporal (actual o recordado), formulación literal o figurada y relevancia potencial de la frase para la próxima sesión, cada uno con una probabilidad. Más adelante, el mismo clasificador sirve como verificador sin referencia y como evaluador de la lista de verificación.
Un modelo lingüístico pequeño
Redacción breve a partir de material preparado
Para cada sesión, el modelo pequeño extrae la estructura, confirma las distorsiones con citas textuales y propone hipótesis (que se almacenan como hipótesis, nunca como evidencia). Para cada resumen, cinco redactores de secciones se ejecutan en paralelo; cada uno solo ve los datos numerados por sesión de su propia sección y tiene instrucciones de no inventar números de sesión ni citas.
La mejor de tres, sin consultar la respuesta
Las diferencias entre ejecuciones de una misma versión solían ser mayores que las diferencias entre versiones. Por ello, el pipeline a nivel de resumen se ejecuta tres veces y un verificador elige una: toma las 20 frases más relevantes del paciente y pregunta al clasificador si cada una está reflejada en el resumen. El verificador nunca ve la referencia de referencia ni la lista de verificación.
El ciclo de autoresearch
Un ciclo de desarrollo automatizado inspirado en trabajos recientes de experimentación automatizada: proponer un cambio, ejecutarlo y conservarlo solo si coinciden dos métricas independientes.
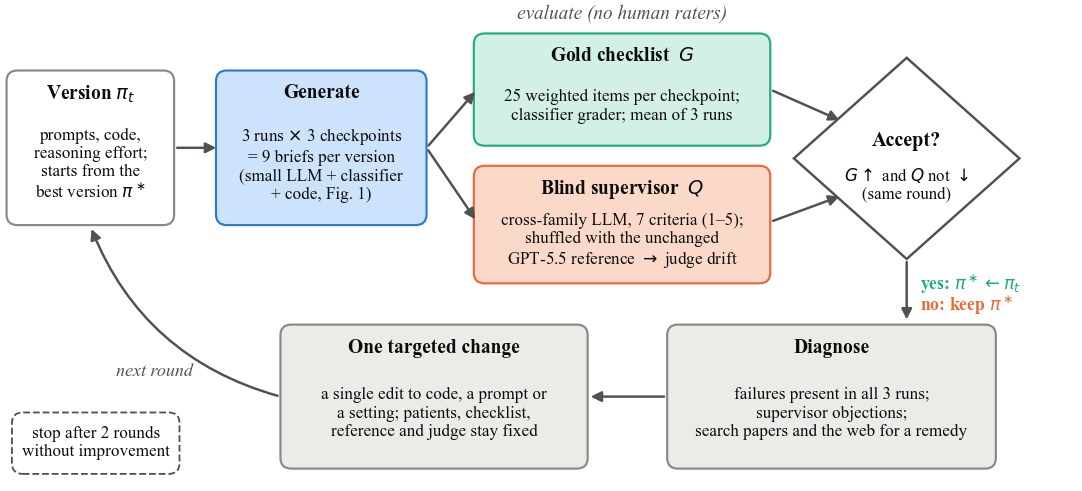
- Dos métricas. Una lista de verificación de referencia con 25 afirmaciones ponderadas por punto de control, evaluada por el clasificador, y una revisión a ciegas a cargo de un supervisor LLM de otra familia de modelos, que puntúa siete criterios en una escala de 1 a 5.
- Un ancla fija. El supervisor también ve siempre un resumen de referencia de frontera sin cambios, identificado con una letra aleatoria, para medir en cada ronda la deriva del propio evaluador.
- Un cambio cada vez. Los fallos presentes en las tres ejecuciones y las objeciones del supervisor orientan un cambio específico por ronda, informado por una búsqueda bibliográfica.
- Una regla de parada fija. Dos rondas consecutivas sin mejora ponen fin al ciclo. Se detuvo en v28.
- Un límite de coste fijo. Dentro del pipeline no se puede utilizar ningún modelo más caro que el modelo pequeño o el clasificador.
Lo que observamos
Estadísticas descriptivas en tres puntos de control (Anita antes de las sesiones 13 y 20, Markus antes de la sesión 12) y tres ejecuciones por versión.
Cobertura de contenido: la lista de verificación de referencia
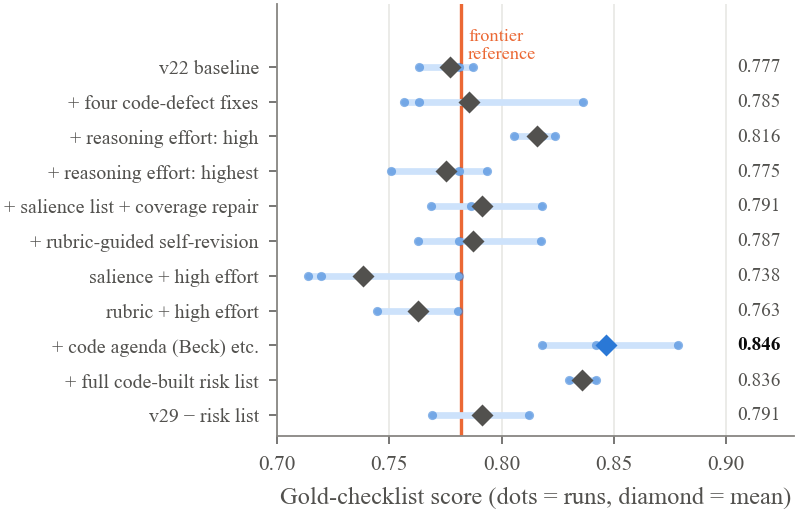
El modelo pequeño partió bastante por debajo de la referencia (0.647 frente a 0.782), la superó en v25 y alcanzó 0.846 en v28. Las tres ejecuciones de v28 (0.818, 0.842, 0.879) superan la referencia. Dos versiones posteriores no mejoraron los resultados de v28 y el ciclo se detuvo.
| Anita, antes de S13 | Anita, antes de S20 | Markus, antes de S12 | |
|---|---|---|---|
| v28, media de 3 ejecuciones | 0.963 | 0.800 | 0.776 |
| v28, best-of-3 (verificador) | 0.963 | 0.836 | 0.836 |
| referencia GPT-5.5 (1 ejecución) | 0.963 | 0.655 | 0.727 |
Medias entre puntos de control: v28 0.846 · best-of-3 0.879 · referencia 0.782.
Revisión a ciegas: dentro del ruido del evaluador
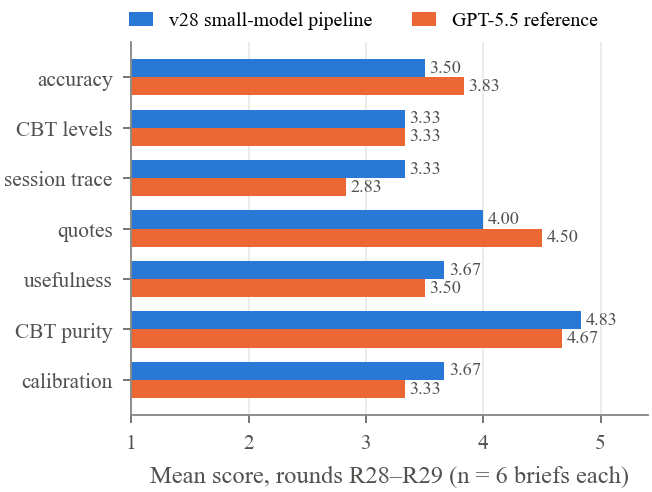
En las rondas finales, la mejor versión del modelo pequeño y la referencia obtuvieron 3.77 frente a 3.87 (R28) y 3.77 frente a 3.57 (R29). En seis pares de la misma ronda, las diferencias fueron −0.4, +0.2, −0.1, −0.5, +0.9, +0.2: media +0.05, DE 0.49. Ninguno de los sistemas alcanzó el promedio objetivo del supervisor de 4.0. Por criterio, v28 aventajó a la referencia en seguimiento de las sesiones y calibración, quedó por detrás en precisión (concordancia con la referencia de referencia) y citas, y estuvo al mismo nivel en los niveles de TCC.
Coste
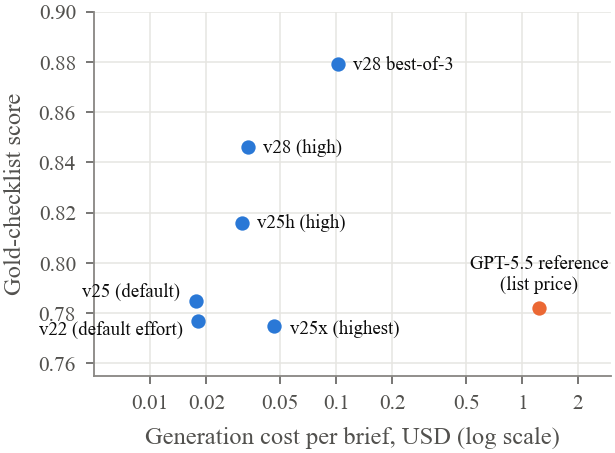
Generar un resumen con v28 cuesta aproximadamente USD 0.03 en redacción de secciones y tarda entre 2.5 y 3 minutos; un resumen best-of-3 cuesta aproximadamente USD 0.11. Procesar una sesión nueva añade unos USD 0.07, principalmente por el paso del clasificador aplicado a cada frase. A los precios de lista, el resumen de referencia de frontera cuesta unas 19 veces más que un único resumen de v28. El proyecto entero utilizó USD 5.57 en tokens del modelo pequeño.
Qué ayudó y qué no
Tres aspectos ayudaron: corregir defectos del código determinista detectados por el supervisor, utilizar un nivel alto de esfuerzo de razonamiento para los redactores de secciones (el nivel más alto costó más y obtuvo una puntuación inferior) y trasladar al código la agenda sugerida, la barra de predicciones y la afirmación más reciente relacionada con el riesgo. Varias adiciones plausibles perjudicaron los resultados: fusionar tres borradores, imponer mediante código una cronología de creencias, añadir indicaciones de relevancia con un paso de reparación de cobertura y realizar una autorrevisión guiada por rúbricas. Cada una añadió un paso de generación en el que un modelo pequeño puede perder o distorsionar información. Todos los cambios que redujeron el trabajo del modelo o seleccionaron entre resultados sin reescribirlos fueron seguros.
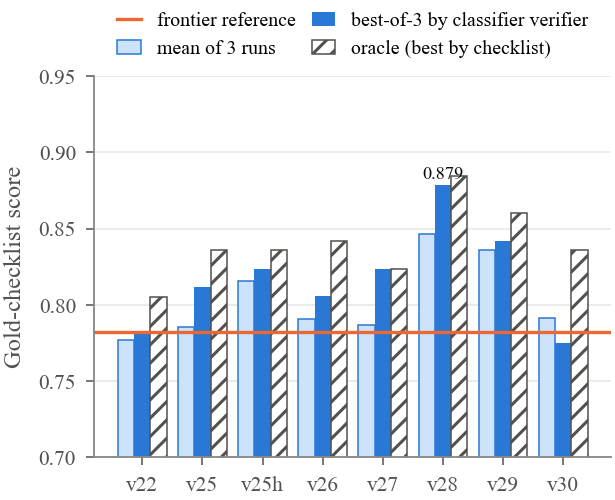
La selección del verificador mejoró la puntuación de la lista de verificación en siete de las ocho versiones; en v28, pasó de 0.846 a 0.879, cerca del oráculo (0.885). Puesto que el verificador y el evaluador de la lista de verificación son el mismo clasificador, parte de esta mejora puede reflejar preferencias compartidas.
Qué siguió siendo difícil
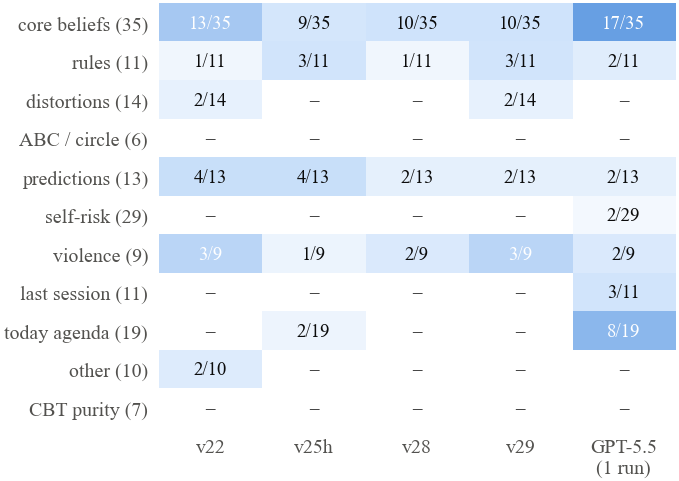
Los fallos persistentes bajaron de 25 a 15 de las 164 unidades de peso entre v22 y v28. Lo que queda son los juicios más sutiles del modelo cognitivo: el estado de una creencia después de reactivarse, los rangos de creencias que terminan antes del material más reciente y las precisiones sobre su alcance. Las afirmaciones sobre el riesgo fueron el componente más difícil: se penalizó tanto omitir una afirmación reciente como convertir una metáfora, un ejercicio o una valoración de emociones en una señal. El mejor diseño conservó únicamente la afirmación literal más reciente y la sesión en la que el terapeuta preguntó directamente por última vez, y dejó toda interpretación en manos del terapeuta.
El evaluador forma parte del experimento
Como el resumen de referencia nunca cambió, sus puntuaciones miden únicamente al supervisor.
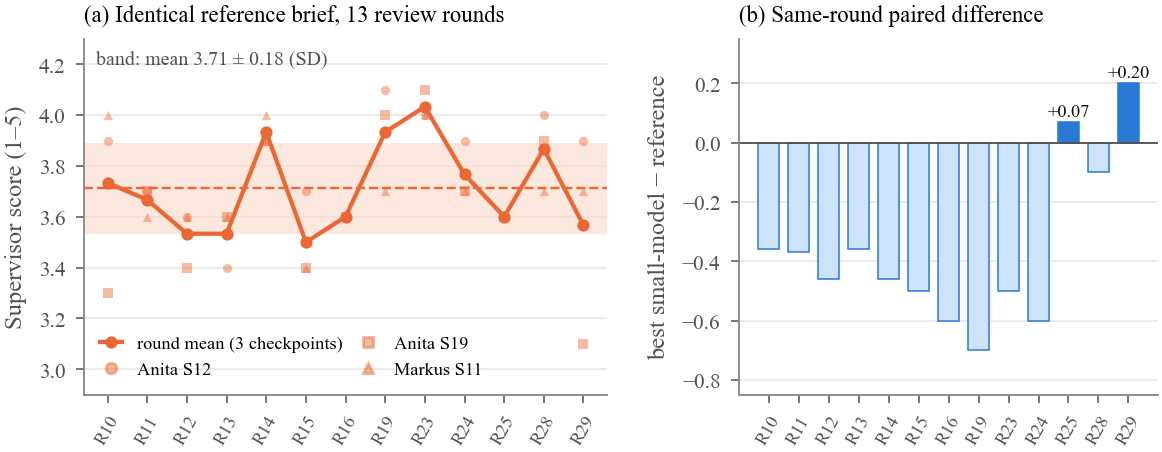
A lo largo de 13 rondas, el resumen de referencia idéntico recibió una media por ronda de 3.71, con DE 0.18 y un rango de 3.50–4.03 en una escala de 1 a 5. En criterios individuales, la DE llegó a 0.46, incluso para las citas verificadas mediante código, idénticas en todas las ocasiones. Ese ruido es aproximadamente tan grande como la mejora total que produjo el ciclo en la misma escala.
Qué no demuestra este estudio
- Solo datos sintéticos. Dos pacientes sintéticos, tres puntos de control y tres ejecuciones por versión. Solo estadísticas descriptivas, sin pruebas de significación. Se argumenta, pero no se demuestra, la transferencia a otras tareas y a material real.
- Solo evaluación basada en modelos. No participaron clínicos ni otros evaluadores humanos, por diseño. Las puntuaciones describen la concordancia con una lista de verificación de referencia y el juicio de un supervisor LLM, no la calidad clínica, la seguridad ni ningún efecto sobre la terapia.
- Ajuste en el conjunto de evaluación. Todas las versiones se desarrollaron usando los mismos puntos de control y evaluadores, por lo que las puntuaciones finales son optimistas. La prueba adecuada sería con un paciente reservado.
- Que sean indistinguibles no significa que uno sea mejor. En la revisión a ciegas no se pudieron distinguir el modelo pequeño y la referencia de frontera con este tamaño de muestra; las diferencias están dentro del propio ruido del evaluador.
- Clasificador compartido. El evaluador de la lista de verificación, el analizador de frases y el verificador son el mismo modelo.
- Una referencia modesta. La referencia de frontera es una única ejecución anterior, sin optimizar, de un pipeline con GPT-5.5; no es un pipeline de frontera ajustado con el mismo ciclo.
Lea el artículo, compruebe las cifras
El artículo completo se puede descargar gratuitamente. El paquete de datos, con listas de verificación, puntuaciones y ejemplos de resúmenes, se envía por correo electrónico.
El artículo
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Prepublicación, 13 páginas, 9 figuras.
Descargar el paquete de datos
PDF del artículo, las nueve figuras, las tres listas de verificación de referencia, las puntuaciones de la lista de verificación y del verificador de cada versión, las revisiones a ciegas de las rondas finales con sus claves de letras y tres ejemplos de resúmenes finales. Un archivo README explica todos los campos.
No compartimos las direcciones. El enlace a los datos llega en unos minutos.
Contenido del ZIP
paper/: el artículo en formato PDFfigures/: nueve figuras y las cifras que las respaldanscores/gold_checklists.json: 3 × 25 afirmaciones ponderadasscores/checklist_results.json: probabilidades por elemento para 198 resúmenes evaluadosscores/blind_review_R28.json,R29: siete criterios, veredictos y objeciones, con claves de letrasexample-briefs/: tres resúmenes finales de v28 (en polaco, como las transcripciones)
No incluidos: transcripciones sintéticas, prompts y código. Los autores los facilitan previa solicitud para uso de investigación.
Cómo citar
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}