
Mažas modelis, kruopščiai suprojektuotas procesas
Autotyrimų metodas, skirtas sumažinti atotrūkį nuo pažangiausių LLM ilgo, kelių dokumentų apibendrinimo užduotyje. Išbandytas rengiant prieš sesiją pateikiamas santraukas pagal dviejų sintetinių pacientų transkriptus.
Nebrangus modelis gali priartėti, jei daro mažiau
Pažangiausi kalbos modeliai gerai apibendrina ilgą, kelių dokumentų medžiagą, tačiau naudoti tokį modelį prieš kiekvieną rezultatą brangu. Maži modeliai nebrangūs, bet ilguose įvesties tekstuose praranda informaciją. Klausėme, kiek gali pasiekti nebrangus modelis, kai jis veikia kruopščiai suprojektuotame procese ir tobulinamas automatizuotu ciklu, kuris kiekvieną pakeitimą vertina kitais modeliais, be žmonių vertintojų.
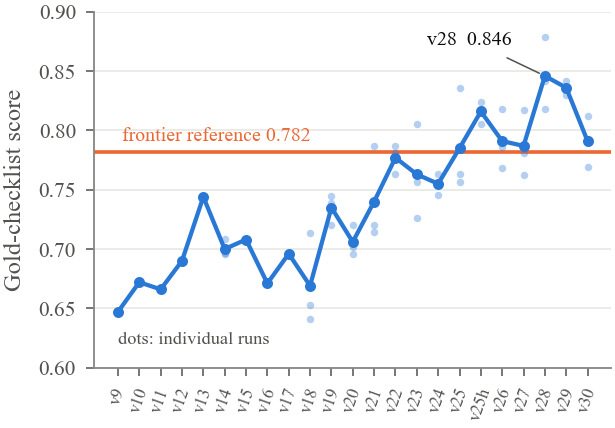
Per 30 versijų ir 16 aklųjų vertinimo etapų mažo modelio įvertis pagal svertinį aukso etalono kontrolinį sąrašą pakilo nuo 0,647 iki 0,846 (0,879, kai iš trijų paleidimų pasirenkamas geriausias, naudojant nuo etalono nepriklausomą tikrintuvą). Pažangiausio modelio atskaitos įvertis buvo 0,782. Aklajame LLM prižiūrėtojo vertinime šių dviejų rezultatų nepavyko atskirti, atsižvelgiant į šios imties dydį: vidutinis suporuotas skirtumas buvo +0,05 (SD 0,49). Ta pati, nepakeista atskaitos santrauka per 13 etapų iš šio prižiūrėtojo gavo nuo 3,50 iki 4,03 balo, tad paties vertintojo triukšmas tapo atskiru tyrimo rezultatu.
Turinys
Ilga įvestis, fiksuota struktūra, įprastas naudojimas
Daugeliui praktinių apibendrinimo užduočių būdingos trys savybės: įvestis ilga ir apima daug dokumentų, rezultatas pateikiamas fiksuota struktūra su skaičiais, datomis ir pažodiniais įrodymais, o pats rezultatas rengiamas reguliariai, todėl svarbi kaina.
Kaip bandymų aplinką pasirinkome vieną tokią užduotį: struktūruotą santrauką, kurią KET terapeutas gali perskaityti likus maždaug trims minutėms iki sesijos. Joje išvardijami pagrindiniai įsitikinimai ir jų aptarimo sesijose skaičius, taisyklės, pasikartojantys iškraipymai, tipiški ABC epizodai, tikrintos prognozės, paskutinė sesija ir klausimai, kuriuos terapeutas galėtų aptarti šios dienos sesijoje. Iki 20-osios sesijos medžiaga sudaro apie 130 000 žodžių.
Ši užduotis tinka metodologiniam klausimui nagrinėti, nes turi žinomą struktūrą (Becko kognityvinį modelį), natūraliai patikrinamus įrodymus (pažodinius paciento žodžius) ir keletą spąstų: įsitikinimą, kurį pirmiausia suformulavo terapeutas, arba metaforą, kuri nėra teiginys apie mirtį.
Du sintetiniai pacientai
Abu pacientai sugeneruoti taikant mūsų sluoksniuotą sintetinių pacientų metodą (pirmiausia parengiamas profilio lapas, terapijos eiga, sesijų planas ir kalbėsenos gairės, o tada sesijos generuojamos po vieną kaip ASR tipo transkriptai). Anita: 20 sesijų, 131 498 žodžiai, J. Becko krypties KET. Markus: 12 sesijų, 83 978 žodžiai; jo terapeutas iš dalies taiko schemų terapiją, todėl santraukoje medžiagą reikia perkelti į KET sąvokas. Kiekvienam pacientui etaloninė santrauka buvo parengta nepriklausomai, perskaičius visus transkriptus. Tikrų pacientų duomenys nebuvo naudojami.
Darbo pasidalijimas
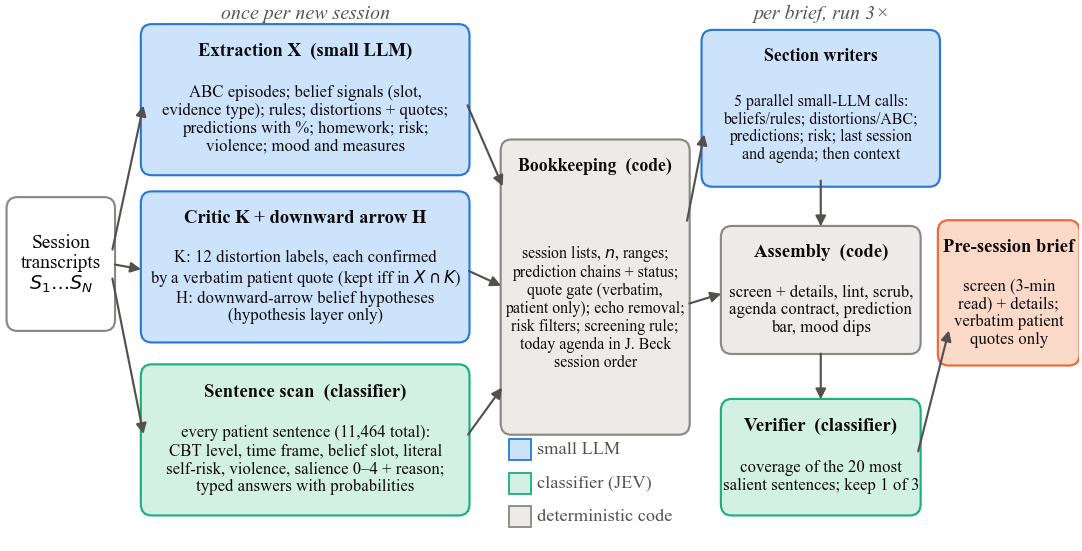
Svarbiausi pakeitimai buvo ne geresnės užklausos, o atsakomybių perskirstymas. Kiekvienas komponentas atlieka tik tai, ką moka geriausiai.
Deterministinis kodas
Viskas, ką galima suskaičiuoti, surikiuoti ar patikrinti
Sesijų sąrašai, kiekvieno įsitikinimo skaičiai ir intervalai; per sesijas susietos prognozių grandinės; pažodinių citatų filtras, atmetantis visas citatas, kurių nėra paties paciento pasisakymuose; terapeuto atkartotų žodžių pašalinimas; o nuo 28 versijos – pasiūlymų šios dienos sesijai eiliškumas. Aptikus šio kodo trūkumą, jis ištaisomas visam laikui.
Sakinių klasifikatorius
Vertinimai, kuriems nereikia generuoti teksto
Kiekvienam paciento sakiniui (iš viso 11 464) priskiriamos žymos: KET lygmuo (automatinė mintis, taisyklė, įsitikinimas, emocija, elgesys…), laiko perspektyva (dabartis arba prisiminimas), pažodinė ar perkeltinė formuluotė ir galimas sakinio reikšmingumas kitai sesijai; kiekvienai žymai priskiriama tikimybė. Vėliau tas pats klasifikatorius naudojamas ir kaip nuo etalono nepriklausantis tikrintuvas, ir kaip kontrolinio sąrašo vertintojas.
Mažas kalbos modelis
Trumpas tekstas pagal parengtą medžiagą
Kiekvienai sesijai mažas modelis išskiria struktūrą, patvirtina iškraipymus pažodinėmis citatomis ir pasiūlo hipotezes (jos išsaugomos kaip hipotezės, niekada ne kaip įrodymai). Kiekvienai santraukai penki skyrių rengimo moduliai veikia lygiagrečiai; kiekvienas mato tik savo skyriui skirtus duomenis, suskirstytus pagal sesijų numerius, ir gauna nurodymą neišgalvoti sesijų numerių ar citatų.
Geriausias iš trijų, nematant atsakymo
Vienos versijos paleidimų skirtumai dažnai buvo didesni nei skirtingų versijų skirtumai. Todėl santraukos rengimo procesas vykdomas tris kartus, o tikrintuvas pasirenka vieną rezultatą: jis paima 20 reikšmingiausių paciento sakinių ir klasifikatoriaus klausia, ar kiekvienas iš jų atsispindi santraukoje. Tikrintuvas nemato nei etaloninės santraukos, nei kontrolinio sąrašo.
Autotyrimų ciklas
Automatizuotas kūrimo ciklas, atitinkantis naujausių automatizuotų eksperimentų krypčių dvasią: pasiūlyti vieną pakeitimą, jį išbandyti ir palikti tik tada, jei sutampa dviejų nepriklausomų metrikų vertinimai.
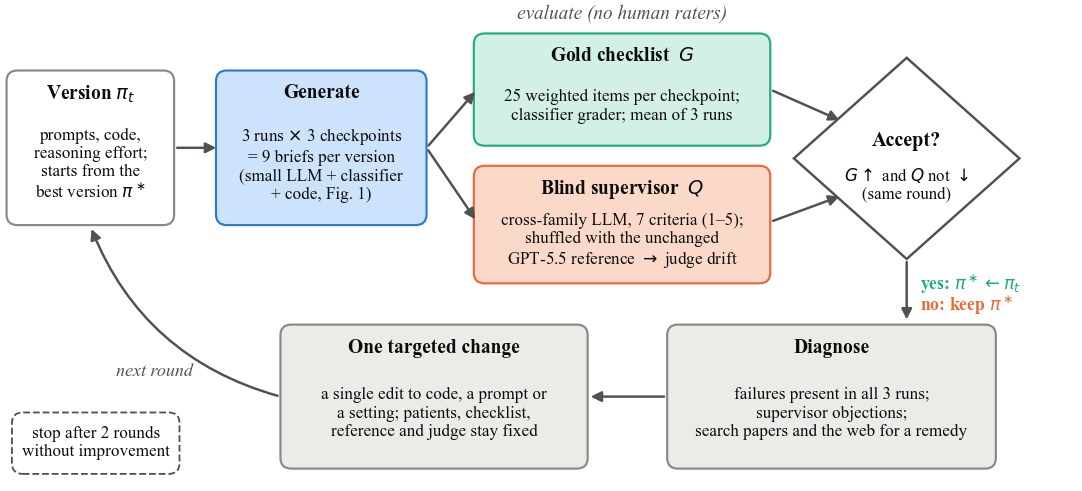
- Dvi metrikos. Kiekviename kontroliniame taške klasifikatorius vertina 25 svertinius teiginius sudarantį aukso etalono kontrolinį sąrašą, o kitos modelių šeimos LLM prižiūrėtojas aklai įvertina septynis kriterijus 1–5 balų skalėje.
- Fiksuotas atskaitos taškas. Prižiūrėtojui visada pateikiama ir viena nepakeista pažangiausio modelio atskaitos santrauka, pažymėta atsitiktine raide, todėl paties vertintojo svyravimai matuojami kiekviename etape.
- Po vieną pakeitimą. Trijose versijose pasikartojantys trūkumai ir prižiūrėtojo pastabos lemia vieną tikslinį pakeitimą per etapą, remiantis literatūros paieška.
- Fiksuota stabdymo taisyklė. Du etapai iš eilės be pagerėjimo užbaigia ciklą. Jis sustojo ties v28.
- Fiksuota išlaidų riba. Procese negalima naudoti modelio, kuris būtų brangesnis už mažąjį modelį ar klasifikatorių.
Ką stebėjome
Aprašomoji statistika trijuose kontroliniuose taškuose (Anitos atvejis – prieš 13-ąją ir 20-ąją sesijas, Markuso – prieš 12-ąją) ir po tris kiekvienos versijos paleidimus.
Turinio aprėptis: aukso etalono kontrolinis sąrašas
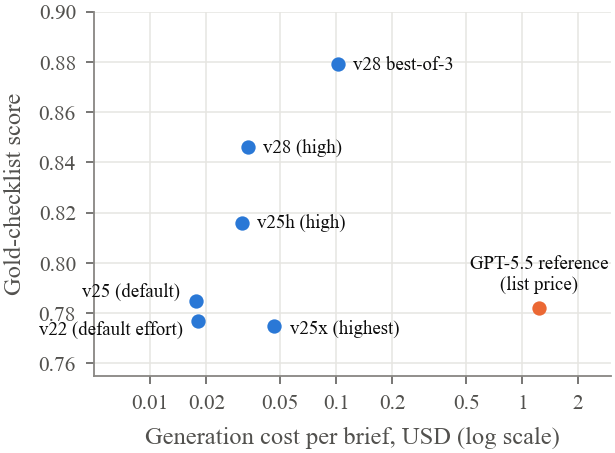
Mažo modelio pradinis įvertis buvo gerokai mažesnis už atskaitos įvertį (0,647, palyginti su 0,782), ties v25 jį aplenkė ir ties v28 pasiekė 0,846. Visi trys v28 paleidimai (0,818, 0,842, 0,879) viršijo atskaitos įvertį. Dvi vėlesnės versijos v28 nepagerino, todėl ciklas buvo sustabdytas.
| Anita, prieš S13 | Anita, prieš S20 | Markus, prieš S12 | |
|---|---|---|---|
| v28, 3 paleidimų vidurkis | 0,963 | 0,800 | 0,776 |
| v28, geriausias iš 3 (tikrintuvas) | 0,963 | 0,836 | 0,836 |
| GPT-5.5 etalonas (1 paleidimas) | 0,963 | 0,655 | 0,727 |
Kontrolinių taškų vidurkiai: v28 0,846 · geriausias iš 3 0,879 · etalonas 0,782.
Aklasis vertinimas: vertintojo triukšmo ribose
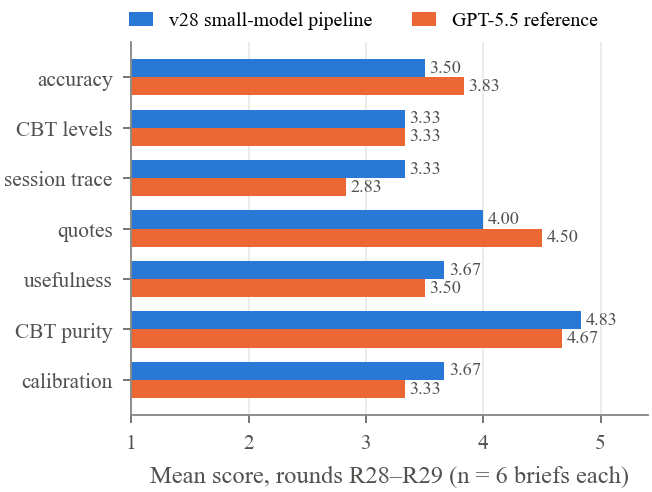
Paskutiniuose etapuose geriausia mažojo modelio versija ir etalonas gavo 3,77 ir 3,87 balo (R28) bei 3,77 ir 3,57 balo (R29). Šešiose to paties etapo porose skirtumai buvo −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: vidurkis +0,05, SD 0,49. Nė viena sistema nepasiekė prižiūrėtojo tikslinio 4,0 balo vidurkio. Pagal kriterijus v28 pirmavo sesijų atsekamumo ir kalibravimo srityse, atsiliko tikslumo (atitikties aukso etalonui) ir citatų srityse, o pagal KET lygmenis rezultatai buvo vienodi.
Kaina
Vienos v28 santraukos skyrių rengimas kainuoja apie USD 0,03 ir trunka 2,5–3 minutes; geriausios iš 3 santraukos – apie USD 0,11. Apdorojant naują sesiją, papildomai kainuoja apie USD 0,07; didžioji šių išlaidų dalis tenka klasifikatoriaus atliekamam kiekvieno sakinio vertinimui. Pagal katalogines kainas pažangiausio modelio atskaitos santrauka kainuoja apie 19 kartų daugiau nei viena v28 santrauka. Visame projekte mažojo modelio žetonams išleista USD 5,57.
Kas padėjo, o kas ne
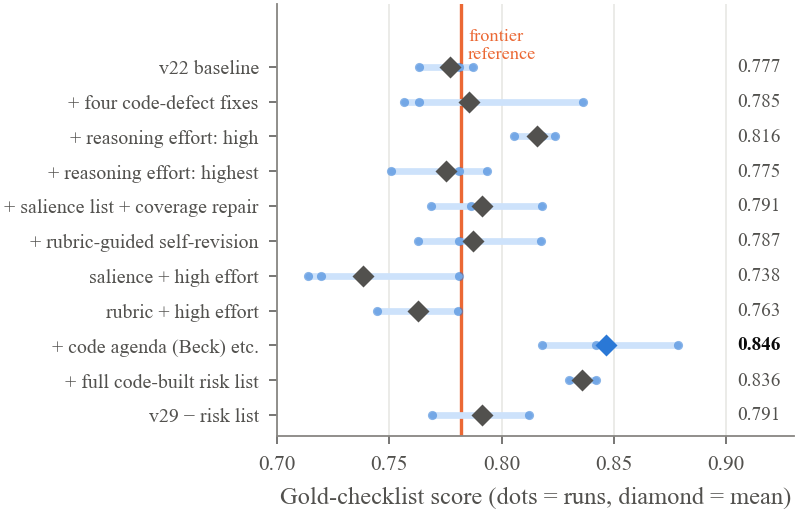
Padėjo trys dalykai: deterministinio kodo trūkumų, kuriuos aptiko prižiūrėtojas, taisymas; didelio samprotavimo intensyvumo nustatymas skyrių rengimo moduliams (didžiausio intensyvumo nustatymas kainavo daugiau ir davė mažesnį įvertį); ir pasiūlytos darbotvarkės, prognozių juostos bei naujausio su rizika susijusio teiginio perkėlimas į kodą. Keli iš pirmo žvilgsnio pagrįsti papildymai pakenkė: trijų juodraščių suliejimas, kodu nustatoma įsitikinimų laiko juosta, reikšmingumo užuominos su aprėpties taisymo etapu ir pagal rubriką atliekama savirevizija. Kiekvienas jų pridėjo generavimo etapą, per kurį mažas modelis gali prarasti ar iškraipyti informaciją. Saugūs buvo visi pakeitimai, kurie sumažino modeliui tenkantį darbą arba atrinko rezultatus jų neperrašydami.
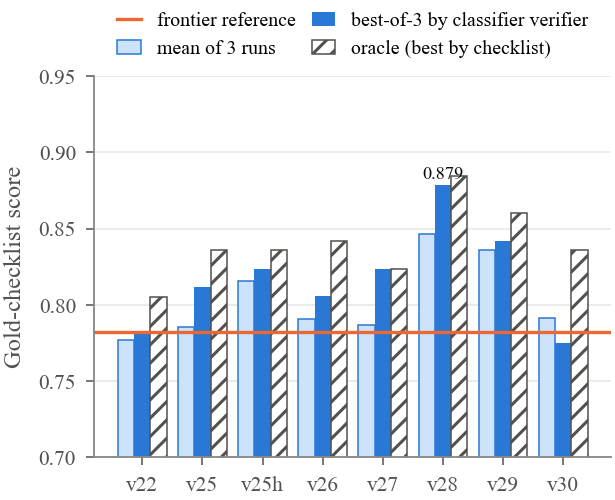
Tikrintuvo atranka pagerino kontrolinio sąrašo įvertį septyniose iš aštuonių versijų; v28 atveju – nuo 0,846 iki 0,879, netoli orakulo įverčio (0,885). Kadangi tikrintuvas ir kontrolinio sąrašo vertintojas yra tas pats klasifikatorius, dalį šio prieaugio gali lemti jų bendri prioritetai.
Kas išliko sudėtinga
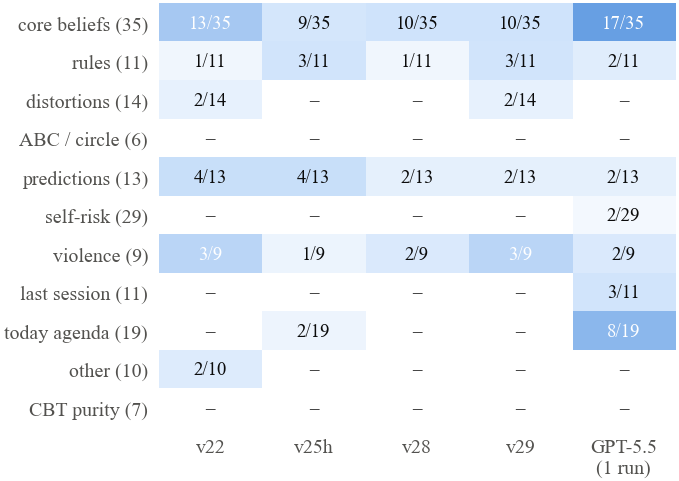
Pasikartojančių trūkumų sumažėjo nuo 25 iki 15 iš 164 svertinių vienetų tarp v22 ir v28. Išliko subtiliausi kognityvinio modelio vertinimai: įsitikinimo būsena jį vėl suaktyvinus, įsitikinimų intervalai, pasibaigiantys anksčiau nei naujausia medžiaga, ir taikymo srities išlygos. Sunkiausiai sekėsi vertinti teiginius apie riziką: buvo baudžiama ir už naujausio teiginio praleidimą, ir už metaforos, pratimo ar emocijos įverčio palaikymą rizikos signalu. Geriausiame sprendime paliktas tik naujausias pažodinis teiginys ir sesija, kurioje terapeutas paskutinį kartą apie tai tiesiogiai paklausė, o visos interpretacijos paliktos terapeutui.
Vertintojas yra eksperimento dalis
Kadangi atskaitos santrauka niekada nesikeitė, jos įverčiai matuoja tik prižiūrėtoją.
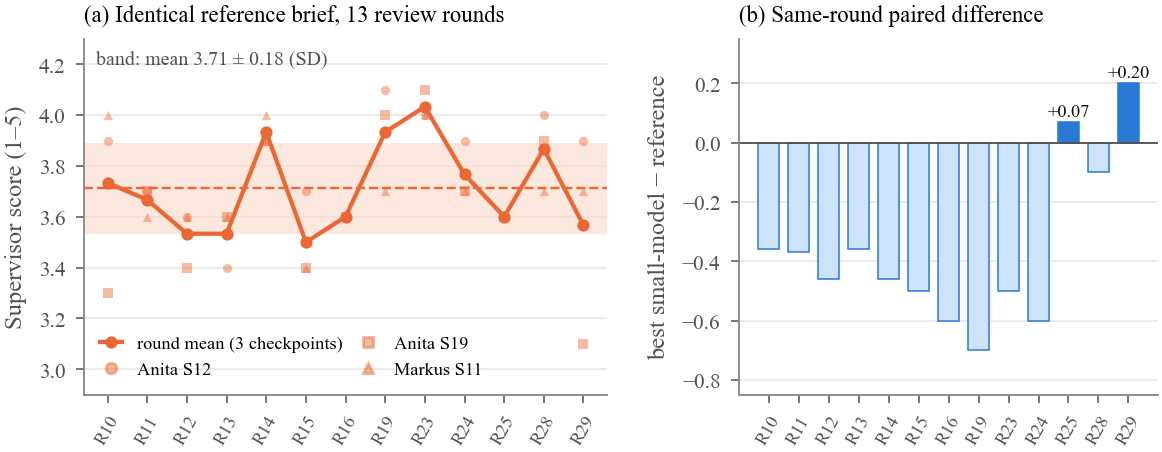
Per 13 etapų tapati atskaitos santrauka gavo 3,71 etapo vidurkį (SD 0,18), o įverčiai 1–5 balų skalėje svyravo nuo 3,50 iki 4,03. Atskirų kriterijų SD siekė 0,46; taip buvo ir vertinant citatas, kurios kiekvieną kartą buvo patikrintos skriptu ir liko identiškos. Šis triukšmas prilygsta visam ciklo pasiektam pagerėjimui toje pačioje skalėje.
Ko šis tyrimas neparodo
- Tik sintetiniai duomenys. Du sintetiniai pacientai, trys kontroliniai taškai, po tris kiekvienos versijos paleidimus. Tik aprašomoji statistika, reikšmingumo testų nėra. Perkeliamumas kitoms užduotims ir tikrai medžiagai aptariamas, bet neparodomas.
- Vertinimas tik modeliais. Pagal tyrimo sumanymą nedalyvavo nei gydytojai, nei kiti žmonės vertintojai. Įverčiai apibūdina atitiktį aukso etalono kontroliniam sąrašui ir LLM prižiūrėtojo vertinimą, o ne klinikinę kokybę, saugumą ar kokį nors poveikį terapijai.
- Tobulinta pagal vertinimo rinkinį. Visos versijos kurtos naudojant tuos pačius kontrolinius taškus ir vertintojus, todėl galutiniai įverčiai yra optimistiniai. Tinkamas bandymas būtų naudojant atidėtą pacientą.
- Neatskiriama nereiškia geresnė. Aklajame vertinime šios imties dydžiui esant nepavyko atskirti mažojo modelio ir pažangiausio modelio etalono; skirtumai telpa į paties vertintojo triukšmą.
- Bendras klasifikatorius. Kontrolinio sąrašo vertintojas, sakinių skaitytuvas ir tikrintuvas yra tas pats modelis.
- Kuklus etalonas. Pažangiausio modelio etalonas – tai vienas ankstesnio, neoptimizuoto proceso paleidimas naudojant GPT-5.5, o ne pažangiausias procesas, optimizuotas tuo pačiu ciklu.
Skaitykite straipsnį, patikrinkite skaičius
Visą straipsnį galima nemokamai atsisiųsti. Duomenų paketas su kontroliniais sąrašais, įverčiais ir pavyzdinėmis santraukomis atsiunčiamas el. paštu.
Straipsnis
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Išankstinė publikacija, 13 puslapių, 9 iliustracijos.
Atsisiųsti duomenų paketą
Straipsnio PDF, visos devynios iliustracijos, trys aukso etalono kontroliniai sąrašai, kiekvienos versijos kontrolinio sąrašo ir tikrintuvo įverčiai, galutinių etapų aklieji vertinimai su raidžių raktais ir trys galutinės pavyzdinės santraukos. README faile paaiškintas kiekvienas laukas.
El. pašto adresais nesidalijame. Nuoroda į duomenis atsiunčiama per kelias minutes.
Kas yra ZIP faile
paper/: straipsnis PDF formatufigures/: devynios iliustracijos ir jas pagrindžiantys skaičiaiscores/gold_checklists.json: 3 × 25 svertiniai teiginiaiscores/checklist_results.json: kiekvieno elemento tikimybės 198 įvertintoms santraukomsscores/blind_review_R28.json,R29: septyni kriterijai, verdiktai ir pastabos su raidžių raktaisexample-briefs/: trys galutinės v28 santraukos (lenkų kalba, kaip ir transkriptai)
Neįtraukta: sintetiniai transkriptai, užklausos ir kodas. Tyrimo tikslais jų galima paprašyti autorių.
Kaip cituoti
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}