
Küçük model, dikkatli pipeline
Uzun ve çok belgeli özetlemede frontier LLM’lerle aradaki farkı kapatmaya yönelik bir autoresearch yöntemi. İki sentetik hastanın transkriptlerinden oluşturulan seans öncesi özetler üzerinde test edildi.
Küçük bir model, daha az iş yaparsa iyi sonuç verebilir
Frontier dil modelleri uzun, çok belgeli materyalleri iyi özetler; ancak her çıktıdan önce böyle bir model çalıştırmak pahalıya mal olur. Küçük modeller ucuzdur ama uzun girdilerde bilgi kaybeder. İnsan değerlendiriciler olmadan, her değişikliği başka modellerle değerlendiren otomatik bir döngü aracılığıyla geliştirilen, özenle tasarlanmış bir pipeline içindeki düşük maliyetli bir modelin ne kadar ileri gidebileceğini araştırdık.
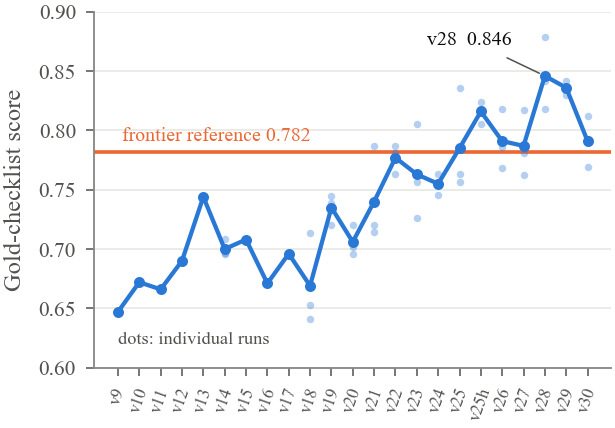
30’dan fazla sürüm ve 16 kör değerlendirme turu boyunca küçük model, ağırlıklı bir altın kontrol listesindeki puanını 0.647’den 0.846’ya yükseltti (başvuru metni gerektirmeyen bir doğrulayıcı üç çalıştırmadan en iyisini seçtiğinde 0.879). Frontier referansının puanı 0.782 oldu. Bir LLM denetçisinin yaptığı kör değerlendirmede, bu örneklem büyüklüğünde iki modeli birbirinden ayırt etmek mümkün olmadı: eşleştirilmiş ortalama fark +0.05’ti (SD 0.49). Aynı, değişmeden kalan referans özet, 13 tur boyunca aynı denetçiden 3.50 ile 4.03 arasında puan aldı; dolayısıyla değerlendiricinin kendi gürültüsü başlı başına bir bulgu oldu.
İçindekiler
Uzun girdi, sabit yapı, rutin kullanım
Uygulamadaki pek çok özetleme görevi üç özelliği paylaşır: girdi uzundur ve birçok belgeye yayılır; çıktı, sayımlar, tarihler ve kelimesi kelimesine kanıtlarla sabit bir yapıya sahiptir; ayrıca çıktı rutin olarak üretildiğinden maliyet önemlidir.
Bir seans öncesinde BDT terapistinin yaklaşık üç dakikada okuyabileceği yapılandırılmış bir özeti test ortamı olarak kullandık. Özet; temel inançları seans sayılarıyla birlikte, kuralları, yinelenen çarpıtmaları, tipik ABC örüntülerini, test edilmiş öngörüleri, son seansı ve terapistin bugünkü seansta ele almak isteyebileceği noktaları listeler. 20. seansa gelindiğinde materyal yaklaşık 130.000 kelimeye ulaşır.
Bu görev yöntemsel bir araştırma sorusuna uygundur; çünkü bilinen bir yapıya (Beck’in bilişsel modeli), doğrulanabilir kanıtın doğal bir biçimine (hastanın kelimesi kelimesine ifadeleri) ve çeşitli tuzaklara sahiptir: ilk kez terapist tarafından ifade edilmiş bir inanç ya da ölümle ilgili bir ifade olmayan bir metafor.
İki sentetik hasta
Her iki hasta da katmanlı sentetik hasta yöntemimizle oluşturuldu (önce profil sayfası, terapi süreci, seans planı ve ses kılavuzu; ardından ASR tarzı transkriptler olarak seanslar tek tek üretildi). Anita: 20 seans, 131.498 kelime, J. Beck tarzı BDT. Markus: 12 seans, 83.978 kelime; kısmen şema terapisi uygulayan bir terapistle çalışıyor, bu nedenle özetteki materyalin BDT terimlerine geri çevrilmesi gerekiyor. Her hasta için, transkriptlerin tamamı okunarak altın referans bağımsız şekilde yazıldı. Gerçek hastalara ait veri kullanılmadı.
İş bölümü
Belirleyici değişiklikler daha iyi istemler değil, sorumlulukların yeniden dağıtılmasıydı. Her bileşen yalnızca iyi olduğu işi yapar.
Belirlenimci kod
Sayılabilen, sıralanabilen veya denetlenebilen her şey
Her inanç için seans listeleri, sayımlar ve aralıklar; seanslar arasında ilişkilendirilen öngörü zincirleri; hastanın kendi ifadelerinde bulunmayan alıntıları çıkaran kelimesi kelimesine alıntı filtresi; terapistin tekrarlarının ayıklanması ve 28. sürümden itibaren bugünkü seans için önerilen noktaların sıralaması. Bu koddaki bir kusur saptandığında, kusur düzeltilmiş olarak kalır.
Cümle sınıflandırıcısı
Metin üretimi gerektirmeyen yargılar
Hastaya ait her cümle (toplam 11.464) bir kez etiketlenir: BDT düzeyi (otomatik düşünce, kural, inanç, duygu, davranış…), zaman çerçevesi (şimdi veya geçmişe dönük), ifadenin gerçek ya da mecazi oluşu ve cümlenin bir sonraki seans açısından ne kadar önemli olabileceği; her etiket için bir olasılık verilir. Aynı sınıflandırıcı daha sonra başvuru metni gerektirmeyen bir doğrulayıcı ve kontrol listesi puanlayıcısı olarak kullanılır.
Küçük bir dil modeli
Hazırlanmış materyalden kısa metin yazımı
Küçük model her seans için yapıyı çıkarır, çarpıtmaları kelimesi kelimesine alıntılarla doğrular ve hipotezler önerir (bunlar kanıt olarak değil, hipotez olarak saklanır). Her özet için beş bölüm yazarı paralel çalışır; her biri yalnızca kendi bölümüne ait, seans numaralarıyla düzenlenmiş verileri görür ve seans numarası ya da alıntı uydurmaması için yönerge alır.
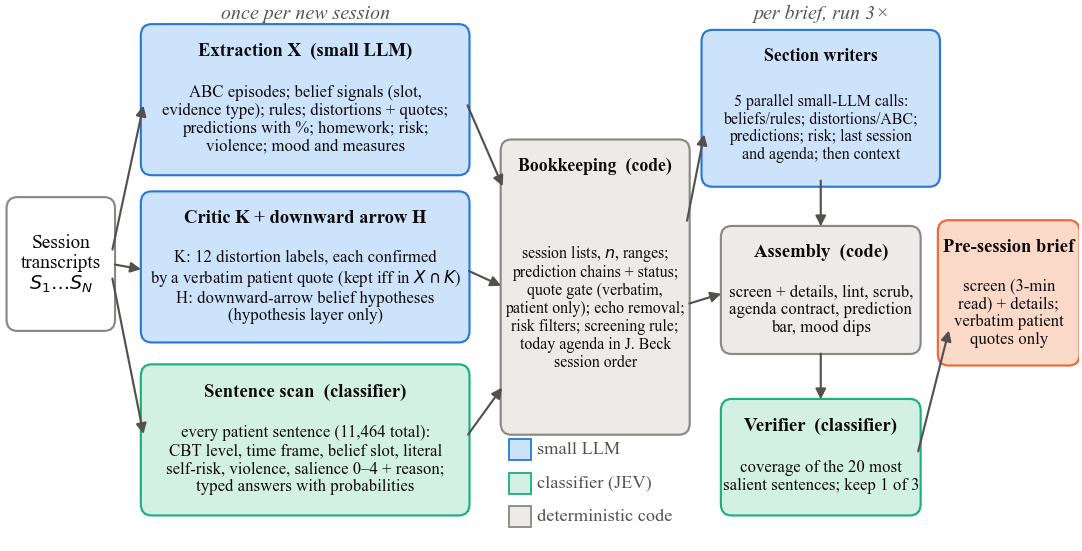
Yanıta bakmadan üç seçenekten en iyisini seçmek
Aynı sürüm içindeki çalıştırmalar arası farklar, sürümler arasındaki farklardan çoğu zaman daha büyüktü. Bu nedenle özet düzeyindeki pipeline üç kez çalışır ve bir doğrulayıcı bir çıktıyı seçer: hastaya ait en önemli 20 cümleyi alır ve sınıflandırıcıya her birinin özette yer alıp almadığını sorar. Doğrulayıcı altın referansı veya kontrol listesini görmez.
Autoresearch döngüsü
Yakın dönem otomatik deney çalışmalarından esinlenen bir otomatik geliştirme döngüsü: tek bir değişiklik öner, dene ve yalnızca iki bağımsız ölçüt de aynı yönde sonuç verirse koru.
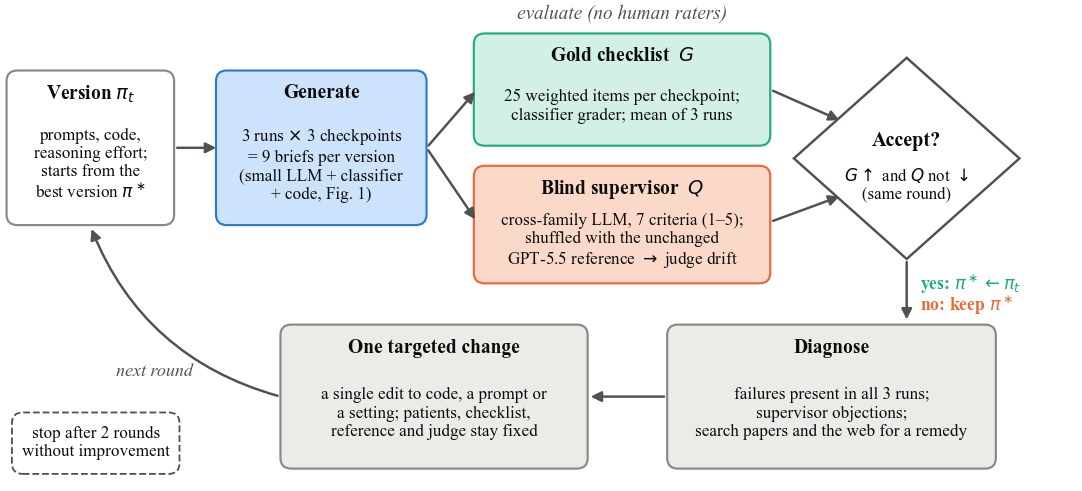
- İki ölçüt. Her kontrol noktası için sınıflandırıcı tarafından puanlanan 25 ağırlıklı ifadeden oluşan bir altın kontrol listesi ve farklı bir model ailesinden LLM denetçisinin 1–5 ölçeğinde yedi ölçüt üzerinden yaptığı kör değerlendirme.
- Sabit bir referans. Değerlendiricinin kayması her turda ölçülebilsin diye denetçiye, rastgele bir harfle etiketlenmiş, değişmeyen bir frontier referans özeti de gösterilir.
- Her seferinde tek değişiklik. Üç çalıştırmanın tümünde görülen hatalar ve denetçinin itirazları, literatür taramasından yararlanılarak tur başına tek bir hedefli değişikliğe yön verir.
- Sabit durdurma kuralı. Art arda iki turda iyileşme görülmemesi döngüyü sonlandırır. Döngü v28’de durdu.
- Sabit maliyet sınırı. Pipeline içinde küçük modelden veya sınıflandırıcıdan daha pahalı hiçbir model kullanılamaz.
Gözlemlediklerimiz
Üç kontrol noktasına (13. ve 20. seans öncesinde Anita, 12. seans öncesinde Markus) ve sürüm başına üç çalıştırmaya ilişkin betimsel istatistikler.
İçerik kapsamı: altın kontrol listesi
Küçük model, referansın oldukça gerisinde başladı (0.647’ye karşı 0.782), v25’te referansı geçti ve v28’de 0.846 puana ulaştı. Üç v28 çalıştırmasının tümü (0.818, 0.842, 0.879) referansın üzerindedir. Sonraki iki sürüm v28’den daha iyi sonuç vermedi ve döngü durdu.
| Anita, S13 öncesi | Anita, S20 öncesi | Markus, S12 öncesi | |
|---|---|---|---|
| v28, 3 çalıştırmanın ortalaması | 0.963 | 0.800 | 0.776 |
| v28, best-of-3 (doğrulayıcı) | 0.963 | 0.836 | 0.836 |
| GPT-5.5 referansı (1 çalıştırma) | 0.963 | 0.655 | 0.727 |
Kontrol noktalarının ortalaması: v28 0.846 · best-of-3 0.879 · referans 0.782.
Kör değerlendirme: değerlendiricinin gürültü payı içinde
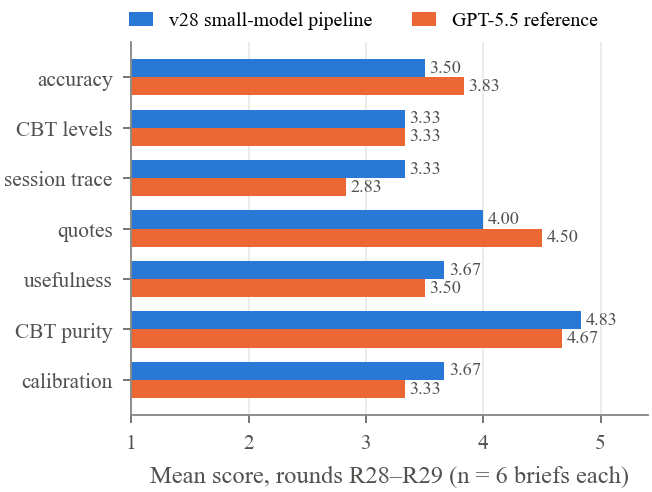
Son turlarda en iyi küçük model sürümü ile referans sırasıyla 3.77’ye karşı 3.87 (R28) ve 3.77’ye karşı 3.57 (R29) puan aldı. Aynı turdaki altı eşleşmede farklar −0.4, +0.2, −0.1, −0.5, +0.9, +0.2 oldu: ortalama +0.05, SD 0.49. İki sistem de denetçinin 4.0’lık hedef ortalama puanına ulaşmadı. Ölçüt bazında v28 seans izleme ve kalibrasyonda öndeydi; doğrulukta (altın referansla uyum) ve alıntılarda gerideydi; BDT düzeylerinde ise eşitti.
Maliyet
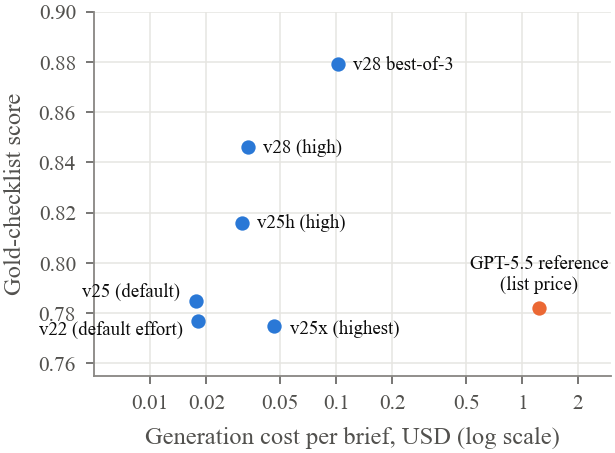
Bir v28 özetinin bölüm yazımı maliyeti yaklaşık 0,03 USD ve üretimi 2,5–3 dakika sürüyor; best-of-3 özetin maliyeti yaklaşık 0,11 USD. Yeni bir seansın işlenmesi yaklaşık 0,07 USD ekliyor; bunun büyük kısmı sınıflandırıcının her cümleyi işlemesinden kaynaklanıyor. Liste fiyatlarıyla frontier referans özeti, tek bir v28 özetinden yaklaşık 19 kat daha pahalı. Projenin tamamında küçük model belirteçleri için 5,57 USD harcandı.
Neler işe yaradı, neler yaramadı
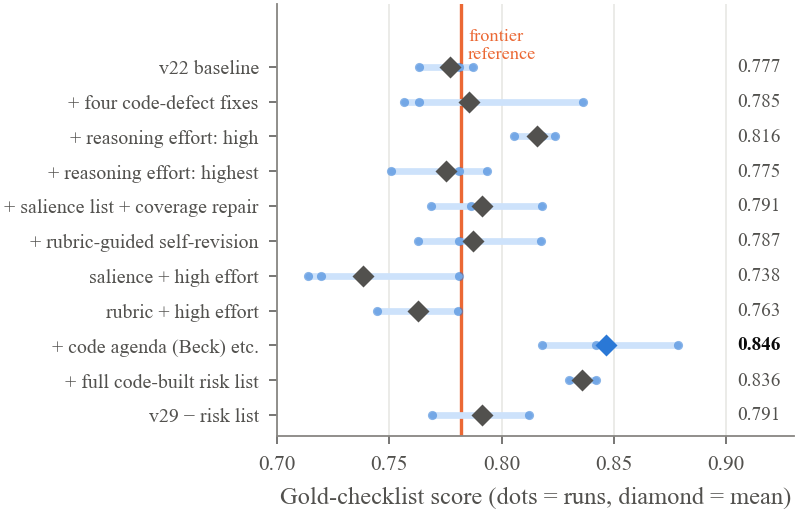
Üç şey işe yaradı: denetçinin saptadığı belirlenimci kod kusurlarını düzeltmek, bölüm yazarları için yüksek akıl yürütme çabası ayarını kullanmak (en yüksek ayar daha pahalıydı ve daha düşük puan aldı) ve önerilen gündem maddelerini, öngörü çubuğunu ve riskle ilgili en yakın tarihli ifadeyi koda taşımak. Makul görünen birkaç ekleme ise performansı düşürdü: üç taslağı birleştirmek, kodla belirlenen bir inanç zaman çizelgesi, kapsamı düzeltme adımıyla birlikte kullanılan önem ipuçları ve rubrik yönlendirmeli öz düzeltme. Bunların her biri, küçük modelin bilgiyi kaybedebileceği veya çarpıtabileceği yeni bir üretim adımı ekledi. Modelin işini azaltan veya çıktıları yeniden yazmadan aralarından seçim yapan her değişiklik güvenliydi.
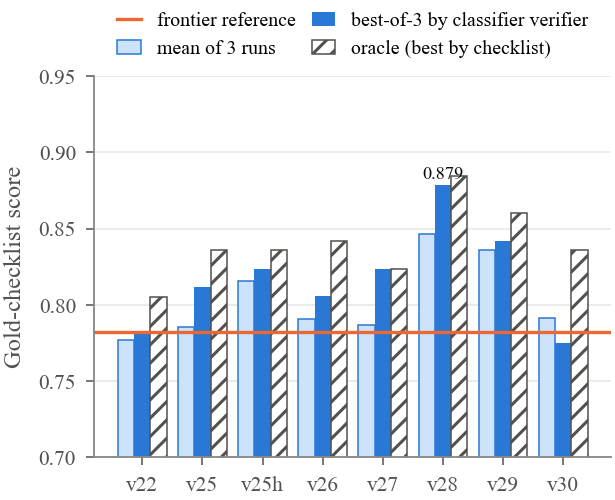
Doğrulayıcıyla seçim, sekiz sürümün yedisinde kontrol listesi puanını artırdı; v28’de puan 0.846’dan 0.879’a çıktı ve oracle değerine (0.885) yaklaştı. Doğrulayıcı ile kontrol listesi puanlayıcısı aynı sınıflandırıcı olduğundan, bu artışın bir bölümü ortak tercihlerden kaynaklanıyor olabilir.
Zor olmaya devam edenler
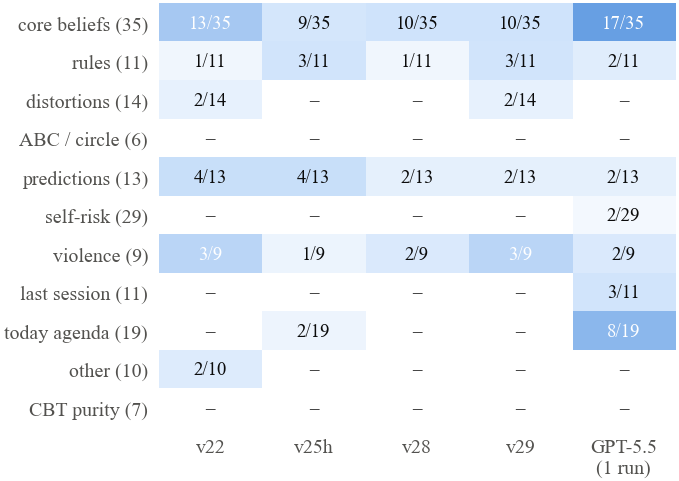
Kalıcı hatalar v22 ile v28 arasında 164 ağırlık biriminden 25’ten 15’e düştü. Geriye bilişsel modelin en incelikli yargıları kalıyor: yeniden etkinleştirilmesinin ardından bir inancın durumu, en güncel materyalden önce sona eren inanç aralıkları ve kapsam nitelemeleri. Riskle ilgili ifadeler en zor bileşendi: hem yakın tarihli bir ifadeyi atlamak hem de bir metaforu, alıştırmayı veya duygu puanlamasını bir sinyale dönüştürmek cezalandırıldı. En iyi tasarım yalnızca en yakın tarihli gerçek ifadeyi ve terapistin bunu en son doğrudan sorduğu seansı korudu; tüm yorumları terapiste bıraktı.
Değerlendirici deneyin bir parçasıdır
Referans özet hiç değişmediğinden puanları yalnızca denetçinin kendisini ölçer.
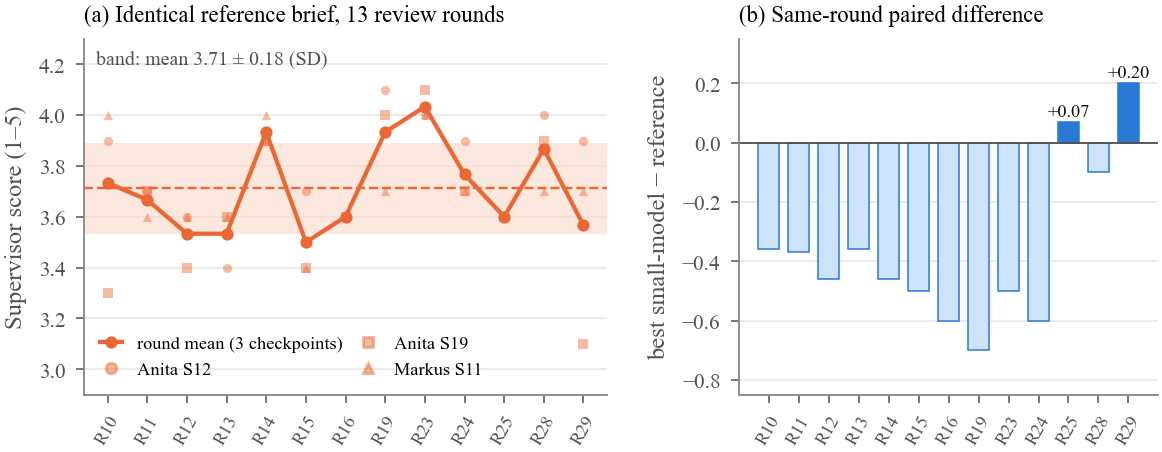
13 tur boyunca aynı referans özet, 1–5 ölçeğinde tur başına 3.71 ortalama puan aldı; SD 0.18, aralık 3.50–4.03 oldu. Tek tek ölçütlerde SD 0.46’ya ulaştı; buna, her seferinde aynı olan ve komut dosyasıyla doğrulanmış alıntılar da dahildi. Bu gürültü, döngünün aynı ölçekte sağladığı toplam iyileşme kadar büyüktür.
Bu çalışma neyi göstermiyor
- Yalnızca sentetik veriler. İki sentetik hasta, üç kontrol noktası, sürüm başına üç çalıştırma. Yalnızca betimsel istatistikler, anlamlılık testleri yok. Diğer görevlere ve gerçek materyale aktarılabilirlik gösterilmemiş, yalnızca tartışılmıştır.
- Yalnızca model tabanlı değerlendirme. Tasarım gereği hiçbir klinisyen veya başka bir insan değerlendirici çalışmaya katılmadı. Puanlar, altın kontrol listesiyle uyumu ve bir LLM denetçisinin yargısını betimler; klinik kaliteyi, güvenliği veya terapi üzerindeki herhangi bir etkiyi değil.
- Değerlendirme kümesine göre ayarlandı. Tüm sürümler aynı kontrol noktaları ve değerlendiriciler kullanılarak geliştirildi; dolayısıyla son puanlar iyimserdir. Doğru test, eğitim sürecinde kullanılmamış bir hasta üzerinde yapılırdı.
- Ayırt edilememek daha iyi olmak demek değildir. Kör değerlendirmede, bu örneklem büyüklüğünde küçük model ile frontier referansını birbirinden ayırt etmek mümkün olmadı; farklar değerlendiricinin kendi gürültü payı içindedir.
- Ortak sınıflandırıcı. Kontrol listesi puanlayıcısı, cümle tarayıcısı ve doğrulayıcı aynı modeldir.
- Mütevazı bir referans. Frontier referansı, GPT-5.5 ile bir kez çalıştırılmış, daha eski ve optimize edilmemiş tek bir pipeline çalıştırmasıdır; aynı döngüyle ayarlanmış frontier pipeline değildir.
Makaleyi okuyun, sayıları inceleyin
Makalenin tamamı ücretsiz indirilebilir. Kontrol listelerini, puanları ve örnek özetleri içeren veri paketi e-postayla gönderilir.
Makale
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Ön baskı, 13 sayfa, 9 şekil.
Veri paketini indirin
Makalenin PDF’si, dokuz şeklin tamamı, üç altın kontrol listesi, her sürüm için kontrol listesi ve doğrulayıcı puanları, harf anahtarlarıyla birlikte son turlardaki kör değerlendirmeler ve son üç örnek özet. README dosyası her alanı açıklar.
Adresleri paylaşmıyoruz. Veri bağlantısı birkaç dakika içinde gelir.
ZIP dosyasının içeriği
paper/: makalenin PDF’sifigures/: dokuz şekil ve bunların dayandığı sayılarscores/gold_checklists.json: 3 × 25 ağırlıklı ifadescores/checklist_results.json: puanlanan 198 özet için madde başına olasılıklarscores/blind_review_R28.json,R29: harf anahtarlarıyla birlikte yedi ölçüt, kararlar ve itirazlarexample-briefs/: son üç v28 özeti (transkriptler gibi Lehçe)
Dahil olmayanlar: sentetik transkriptler, istemler ve kod. Araştırma amacıyla yazarlardan talep edilebilir.
Atıf
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}