
Malý model, starostlivo navrhnutý pipeline
Metóda autoresearch na zmenšenie rozdielu oproti frontier LLM pri sumarizácii dlhých textov z viacerých dokumentov. Testované na súhrnoch pred sedením vytvorených z prepisov dvoch syntetických pacientov.
Lacný model sa môže priblížiť, ak robí menej
Frontier jazykové modely dobre sumarizujú dlhé materiály z viacerých dokumentov, no ich spúšťanie pred každým výstupom je nákladné. Malé modely sú lacné, ale pri dlhých vstupoch strácajú informácie. Skúmali sme, ako ďaleko sa môže dostať nízkonákladový model, keď je súčasťou starostlivo navrhnutého pipeline a zlepšuje ho automatizovaná slučka, ktorá hodnotí každú zmenu pomocou iných modelov bez ľudských hodnotiteľov.
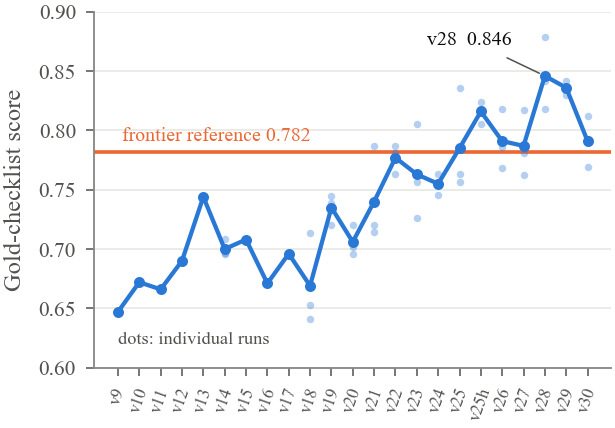
Počas viac než 30 verzií a 16 kôl zaslepeného hodnotenia sa skóre malého modelu podľa váženého zlatého kontrolného zoznamu zvýšilo z 0.647 na 0.846 (0.879, keď výber z troch behov vykoná verifikátor bez prístupu k referencii). Referenčný frontier model dosiahol skóre 0.782. Pri zaslepenom hodnotení supervízorom LLM nebolo možné pri tejto veľkosti vzorky tieto dva systémy rozlíšiť: priemerný párový rozdiel bol +0.05 (SD 0.49). Ten istý, nezmenený referenčný súhrn získal od daného supervízora skóre od 3.50 do 4.03 v priebehu 13 kôl, takže vlastný šum hodnotiteľa sa ukázal byť samostatným zistením.
Obsah
Dlhý vstup, pevná štruktúra, rutinné použitie
Mnohé praktické úlohy sumarizácie majú tri spoločné vlastnosti: vstup je dlhý a rozložený vo viacerých dokumentoch, výstup má pevnú štruktúru s počtami, dátumami a doslovnými dôkazmi a tvorí sa pravidelne, takže záleží na nákladoch.
Ako testovacie prostredie sme použili jednu takúto úlohu: štruktúrovaný súhrn, ktorý si terapeut KBT môže prečítať približne za tri minúty pred sedením. Uvádza základné presvedčenia s počtom sedení, pravidlá, opakujúce sa skreslenia, typické epizódy ABC, testované predpovede, posledné sedenie a body, ktorým sa terapeut môže chcieť venovať na dnešnom sedení. Do 20. sedenia má materiál približne 130 000 slov.
Táto úloha sa hodí na metodologickú otázku, pretože má známu štruktúru (Beckov kognitívny model), prirodzený spôsob overovania dôkazov (doslovné vyjadrenia pacienta) a niekoľko nástrah: presvedčenie, ktoré pôvodne formuloval terapeut, alebo metafora, ktorá nie je vyjadrením o smrti.
Dvaja syntetickí pacienti
Obaja pacienti boli vytvorení pomocou našej vrstvenej metódy syntetických pacientov (najprv profilový hárok, terapeutický priebeh, plán sedení a sprievodca hlasovým prejavom, potom jednotlivé sedenia generované postupne ako prepisy v štýle ASR). Anita: 20 sedení, 131 498 slov, KBT v štýle J. Beckovej. Markus: 12 sedení, 83 978 slov; jeho terapeut čiastočne pracuje so schématerapiou, preto treba materiál v súhrne previesť späť do pojmov KBT. Pre každého pacienta bol zlatý referenčný súhrn vytvorený nezávisle na základe úplného prečítania prepisov. Nepoužili sa žiadne údaje skutočných pacientov.
Rozdelenie práce
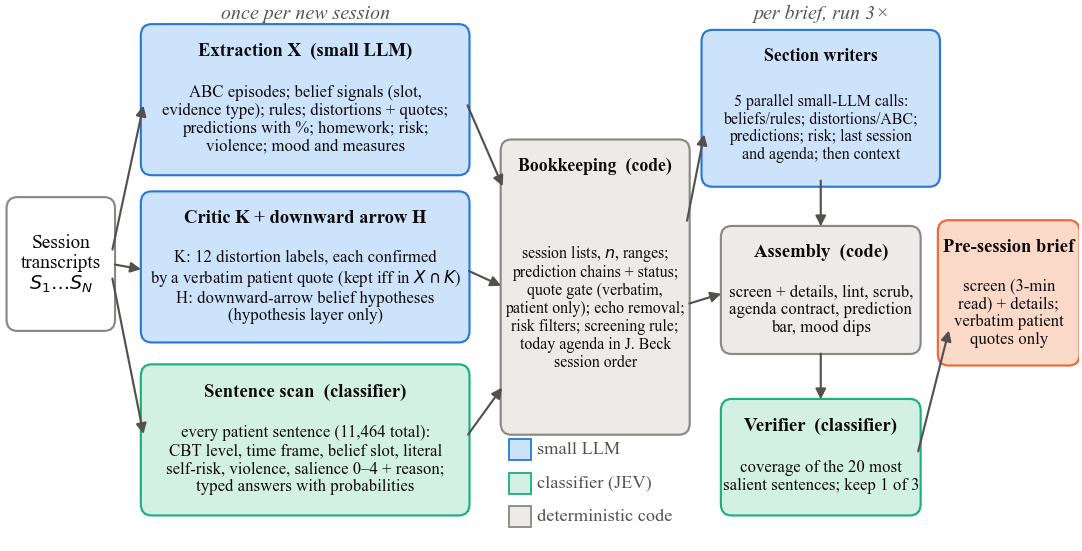
Rozhodujúce zmeny nespočívali v lepších promptoch, ale v novom rozdelení úloh. Každá súčasť robí len to, v čom je dobrá.
Deterministický kód
Všetko, čo sa dá spočítať, zoradiť alebo skontrolovať
Zoznamy sedení, počty a rozsahy pre každé presvedčenie; reťazce predpovedí prepojené naprieč sedeniami; filter doslovných citátov, ktorý odstráni každý citát, ktorý sa nenachádza vo vlastných vyjadreniach pacienta; odstránenie terapeutových ozvien; a od verzie 28 aj poradie navrhovaných bodov pre dnešné sedenie. Po odhalení chyby v tomto kóde zostáva oprava natrvalo.
Klasifikátor viet
Posudzovanie, ktoré si nevyžaduje generovanie textu
Každá veta pacienta (spolu 11 464) sa raz označí: úroveň KBT (automatická myšlienka, pravidlo, presvedčenie, emócia, správanie…), časový rámec (teraz alebo spomienka), doslovné alebo obrazné vyjadrenie a pravdepodobná významnosť vety pre nasledujúce sedenie; ku každému označeniu sa priradí pravdepodobnosť. Ten istý klasifikátor neskôr slúži ako verifikátor bez referencie aj ako hodnotiteľ kontrolného zoznamu.
Malý jazykový model
Stručné písanie z pripravených podkladov
Pre každé sedenie malý model extrahuje štruktúru, potvrdzuje skreslenia doslovnými citátmi a navrhuje hypotézy (ukladané ako hypotézy, nikdy nie ako dôkazy). Pri tvorbe každého súhrnu pracuje paralelne päť autorov jednotlivých častí; každý vidí len údaje očíslovaných sedení pre svoju časť a dostane pokyn, aby nevymýšľal čísla sedení ani citáty.
Najlepší z troch, bez nahliadnutia do odpovede
Rozdiely medzi behmi v rámci jednej verzie boli často väčšie než rozdiely medzi verziami. Preto pipeline na úrovni súhrnu spúšťa tri behy a verifikátor vyberie jeden z nich: vezme 20 najvýznamnejších viet pacienta a požiada klasifikátor, aby posúdil, či sa každá z nich odráža v súhrne. Verifikátor nevidí zlatú referenciu ani kontrolný zoznam.
Slučka autoresearch
Automatizovaná vývojová slučka inšpirovaná nedávnym výskumom automatizovaných experimentov: navrhnúť jednu zmenu, otestovať ju a ponechať ju len vtedy, ak sa zhodnú dve nezávislé metriky.
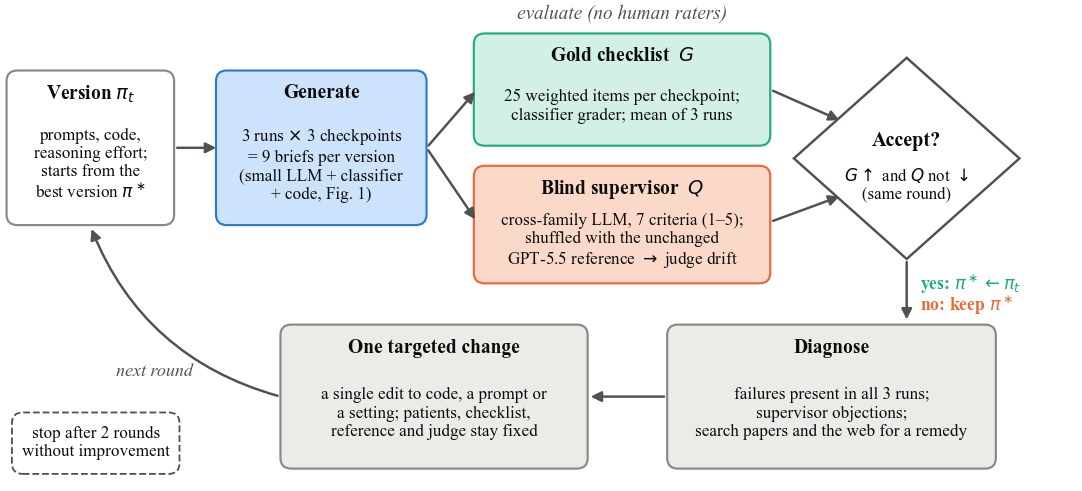
- Dve metriky. Zlatý kontrolný zoznam s 25 váženými tvrdeniami pre každý kontrolný bod, hodnotený klasifikátorom, a zaslepené hodnotenie supervízorom LLM z inej rodiny modelov podľa siedmich kritérií na škále 1–5.
- Pevná kotva. Supervízor vždy vidí aj jeden nezmenený referenčný súhrn frontier modelu, označený náhodným písmenom, takže vlastný posun hodnotiteľa sa meria v každom kole.
- Jedna zmena naraz. Zlyhania prítomné vo všetkých troch behoch a pripomienky supervízora určujú jednu cielenú zmenu na kolo, ktorá vychádza z rešerše literatúry.
- Pevné pravidlo zastavenia. Slučka sa ukončí po dvoch po sebe nasledujúcich kolách bez zlepšenia. Zastavila sa pri v28.
- Pevný nákladový strop. V pipeline sa nesmie použiť model drahší než malý model alebo klasifikátor.
Čo sme pozorovali
Opisná štatistika z troch kontrolných bodov (Anita pred 13. a 20. sedením, Markus pred 12. sedením) a troch behov na verziu.
Pokrytie obsahu: zlatý kontrolný zoznam
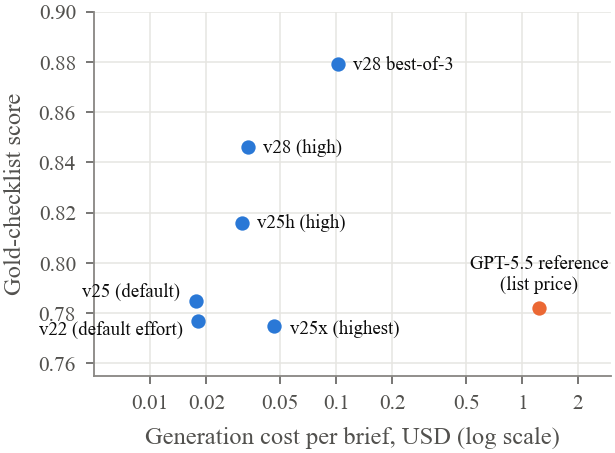
Malý model začínal výrazne pod referenciou (0.647 oproti 0.782), pri v25 ju prekonal a pri v28 dosiahol 0.846. Všetky tri behy v28 (0.818, 0.842, 0.879) sú nad referenciou. Dve nasledujúce verzie v28 nezlepšili a slučka sa zastavila.
| Anita, pred S13 | Anita, pred S20 | Markus, pred S12 | |
|---|---|---|---|
| v28, priemer z 3 behov | 0.963 | 0.800 | 0.776 |
| v28, best-of-3 (verifikátor) | 0.963 | 0.836 | 0.836 |
| referencia GPT-5.5 (1 beh) | 0.963 | 0.655 | 0.727 |
Priemery za kontrolné body: v28 0.846 · best-of-3 0.879 · referencia 0.782.
Zaslepené hodnotenie: v rámci šumu hodnotiteľa
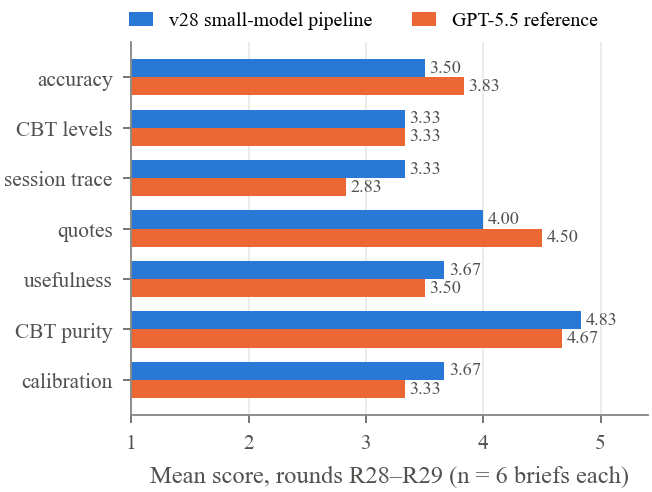
V záverečných kolách dosiahla najlepšia verzia malého modelu a referencia skóre 3.77 oproti 3.87 (R28) a 3.77 oproti 3.57 (R29). V šiestich pároch z rovnakého kola boli rozdiely −0.4, +0.2, −0.1, −0.5, +0.9, +0.2: priemer +0.05, SD 0.49. Ani jeden systém nedosiahol cieľový priemer supervízora 4.0. Podľa jednotlivých kritérií v28 dosahovala lepšie výsledky v sledovaní priebehu sedení a kalibrácii, horšie v presnosti (zhode so zlatou referenciou) a citátoch a rovnaké v úrovniach KBT.
Náklady
Vytvorenie jedného súhrnu v28 stojí približne USD 0.03 za písanie jednotlivých častí a trvá 2.5–3 minúty; súhrn best-of-3 stojí približne USD 0.11. Spracovanie nového sedenia stojí ďalších približne USD 0.07, prevažne za prechod klasifikátora cez každú vetu. Pri katalógových cenách stojí referenčný súhrn frontier modelu približne 19-krát viac než jeden súhrn v28. Celý projekt spotreboval tokeny malého modelu v hodnote USD 5.57.
Čo pomohlo a čo nie
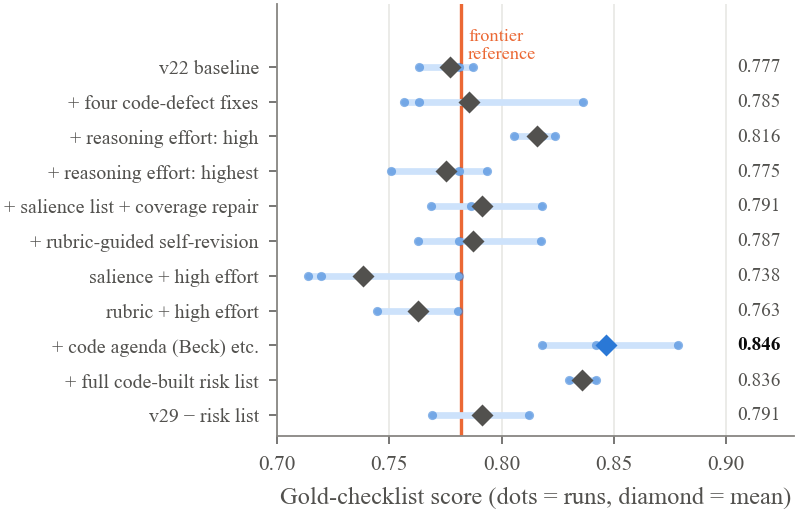
Pomohli tri veci: oprava chýb v deterministickom kóde odhalených supervízorom, nastavenie vysokej náročnosti uvažovania pre autorov jednotlivých častí (nastavenie najvyššej náročnosti stálo viac a dosiahlo nižšie skóre) a presun navrhovanej agendy, lišty predpovedí a najnovšieho vyjadrenia súvisiaceho s rizikom do kódu. Niekoľko vierohodných doplnkov výsledky zhoršilo: zlúčenie troch návrhov, časová os presvedčení určená kódom, indikácie významnosti s krokom na opravu pokrytia a samostatná revízia riadená hodnotiacou rubrikou. Každý z nich pridal krok generovania, v ktorom môže malý model stratiť alebo skresliť informácie. Každá zmena, ktorá modelu odobrala časť práce alebo vybrala jeden z výstupov bez jeho prepisovania, bola bezpečná.
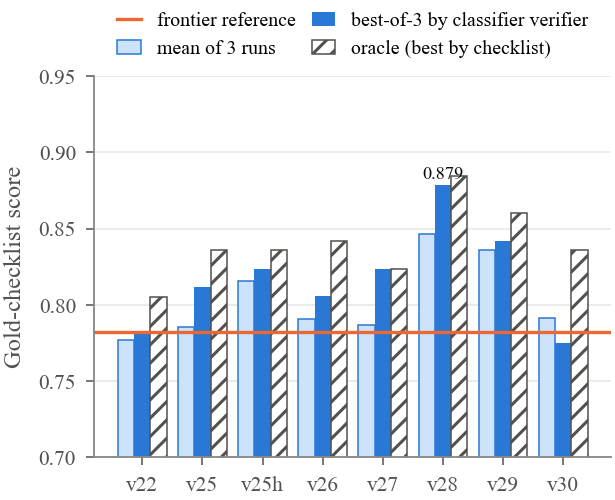
Výber verifikátorom zlepšil skóre kontrolného zoznamu v siedmich z ôsmich verzií; pri v28 z 0.846 na 0.879, čo sa blíži k oracle (0.885). Keďže verifikátor aj hodnotiteľ kontrolného zoznamu sú ten istý klasifikátor, časť tohto zlepšenia môže odrážať ich spoločné preferencie.
Čo zostalo náročné
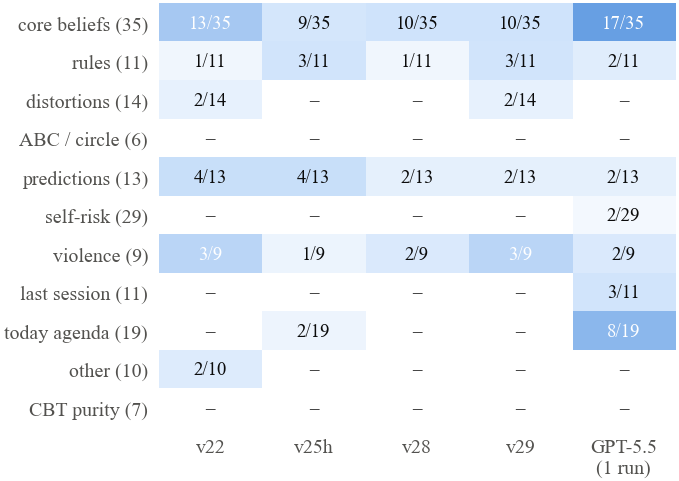
Počet pretrvávajúcich zlyhaní klesol medzi v22 a v28 z 25 na 15 zo 164 váhových jednotiek. Zostávajú najjemnejšie úsudky kognitívneho modelu: stav presvedčenia po jeho opätovnej aktivácii, rozsahy presvedčení končiace pred najnovším materiálom a obmedzenia rozsahu platnosti. Najnáročnejšou zložkou boli vyjadrenia o riziku: penalizovalo sa vynechanie nedávneho vyjadrenia aj premena metafory, cvičenia alebo hodnotenia emócie na signál. Najlepší návrh ponechal len najnovšie doslovné vyjadrenie a sedenie, na ktorom sa na to terapeut naposledy priamo opýtal, pričom všetky interpretácie nechával na terapeutovi.
Hodnotiteľ je súčasťou experimentu
Keďže sa referenčný súhrn nikdy nemenil, jeho skóre meria iba samotného supervízora.
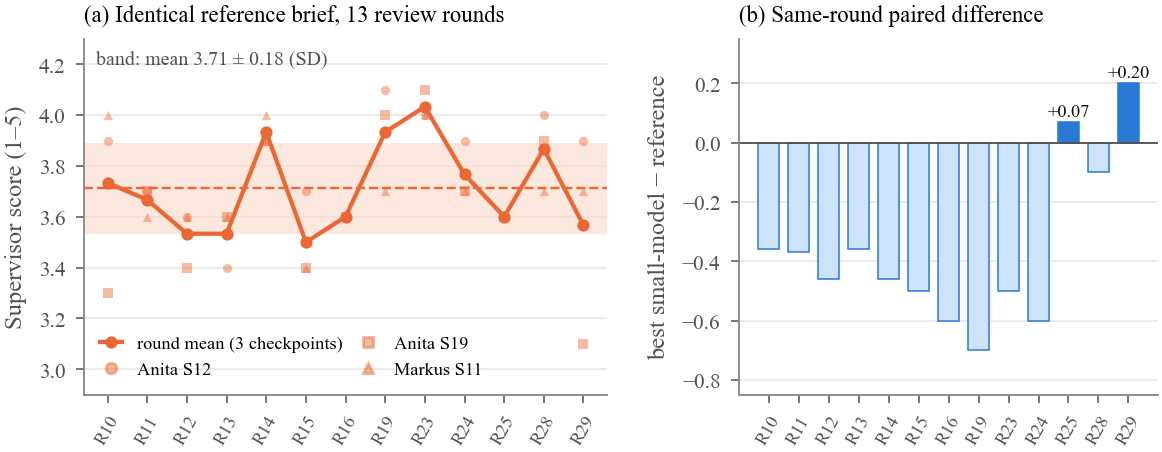
V priebehu 13 kôl získal totožný referenčný súhrn priemerné skóre 3.71 so SD 0.18 a rozsahom 3.50–4.03 na škále 1–5. Pri jednotlivých kritériách dosiahla SD až 0.46, a to aj pri citátoch overených skriptom, ktoré boli zakaždým identické. Tento šum je približne taký veľký ako celé zlepšenie, ktoré slučka dosiahla na rovnakej škále.
Čo táto štúdia neukazuje
- Iba syntetické dáta. Dvaja syntetickí pacienti, tri kontrolné body, tri behy na verziu. Len opisná štatistika, bez testov významnosti. Prenositeľnosť na iné úlohy a na skutočný materiál sa argumentuje, ale nepreukazuje.
- Len hodnotenie pomocou modelov. Zámerne sa nezúčastnili klinickí odborníci ani iní ľudskí hodnotitelia. Skóre vyjadrujú zhodu so zlatým kontrolným zoznamom a úsudkom supervízora LLM, nie klinickú kvalitu, bezpečnosť ani akýkoľvek účinok na terapiu.
- Ladenie na súbore hodnotenia. Všetky verzie sa vyvíjali na rovnakých kontrolných bodoch a s rovnakými hodnotiteľmi, takže finálne skóre sú optimistické. Správnym testom by bol pacient vyhradený na testovanie.
- Nerozlíšiteľnosť neznamená lepší výsledok. Pri zaslepenom hodnotení nebolo možné pri tejto veľkosti vzorky rozlíšiť malý model od referencie frontier modelu; rozdiely spadajú do vlastného šumu hodnotiteľa.
- Spoločný klasifikátor. Hodnotiteľ kontrolného zoznamu, skener viet a verifikátor sú ten istý model.
- Skromná referencia. Referencia frontier modelu je jedno predchádzajúce, neoptimalizované spustenie pipeline s GPT-5.5, nie frontier pipeline ladený tou istou slučkou.
Prečítajte si článok, overte si čísla
Celý článok je k dispozícii bezplatne na stiahnutie. Balík dát s kontrolnými zoznamami, skóre a ukážkovými súhrnmi vám pošleme e-mailom.
Článok
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Preprint, 13 strán, 9 obrázkov.
Stiahnuť balík dát
PDF článku, všetkých deväť obrázkov, tri zlaté kontrolné zoznamy, skóre kontrolného zoznamu a verifikátora pre každú verziu, zaslepené hodnotenia z posledných kôl s kľúčmi písmen a tri finálne ukážkové súhrny. Súbor README vysvetľuje každé pole.
Adresy neposkytujeme tretím stranám. Odkaz na dáta príde v priebehu niekoľkých minút.
Čo obsahuje ZIP
paper/: článok vo formáte PDFfigures/: deväť obrázkov a podkladové číselné údajescores/gold_checklists.json: 3 × 25 vážených tvrdeníscores/checklist_results.json: pravdepodobnosti pre jednotlivé položky pri 198 hodnotených súhrnochscores/blind_review_R28.json,R29: sedem kritérií, verdikty a pripomienky vrátane kľúčov písmenexample-briefs/: tri finálne súhrny v28 (v poľštine, rovnako ako prepisy)
Neobsahuje: syntetické prepisy, prompty ani kód. Autori ich na požiadanie sprístupnia na výskumné účely.
Ako citovať
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}