
Liten modell, noggrant utformad pipeline
En autoresearch-metod för att minska avståndet till frontier-LLM:er vid lång sammanfattning av flera dokument. Testad på förberedande sammanfattningar inför sessioner, baserade på transkriptioner från två syntetiska patienter.
En billig modell kan komma nära, om den gör mindre
Frontiermodeller för språk sammanfattar långa texter med flera dokument väl, men det blir dyrt att köra en sådan modell före varje resultat. Små modeller är billiga, men tappar information vid långa indata. Vi undersökte hur långt en lågkostnadsmodell kan nå när den ingår i en noggrant konstruerad pipeline och förbättras genom en automatiserad loop som utvärderar varje ändring med andra modeller, utan mänskliga bedömare.
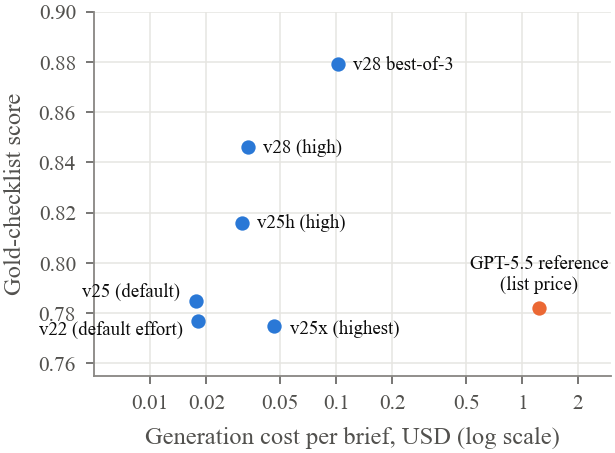
Under 30 versioner och 16 blinda granskningsomgångar steg den lilla modellens resultat från 0.647 till 0.846 på en viktad guldchecklista (0.879 när en referensfri verifierare väljer den bästa av tre körningar). Frontierreferensen fick 0.782. I blind granskning av en LLM-övervakare gick det inte att skilja de två åt vid denna urvalsstorlek: den genomsnittliga parade skillnaden var +0.05 (SD 0.49). Samma, oförändrade referenssammanfattning fick mellan 3.50 och 4.03 av övervakaren under 13 omgångar, vilket innebär att bedömarens egen variation visade sig vara ett resultat i sig.
Innehåll
Lång indata, fast struktur, rutinmässig användning
Många praktiska sammanfattningsuppgifter har tre gemensamma egenskaper: indata är lång och fördelad över många dokument, resultatet följer en fast struktur med antal, datum och ordagranna belägg, och resultatet tas fram rutinmässigt, vilket gör kostnaden viktig.
Vi använde en sådan uppgift som testmiljö: en strukturerad sammanfattning som en KBT-terapeut kan läsa på ungefär tre minuter före en session. Den listar grundantaganden med antal sessioner, regler, återkommande tankefällor, typiska ABC-episoder, prövade förutsägelser, den senaste sessionen och punkter som terapeuten kan vilja ta upp under dagens session. Vid session 20 omfattar materialet omkring 130 000 ord.
Uppgiften lämpar sig för en metodfråga eftersom den har en känd struktur (Becks kognitiva modell), en naturlig form av verifierbara belägg (patientens ordagranna uttalanden) och flera fallgropar: ett antagande som först formulerades av terapeuten, eller en metafor som inte är ett påstående om döden.
Två syntetiska patienter
Båda patienterna genererades med vår skiktade metod för syntetiska patienter (först profilblad, terapeutisk utveckling, sessionsplan och röstguide; därefter genererades sessionerna en i taget som ASR-liknande transkriptioner). Anita: 20 sessioner, 131 498 ord, KBT i J. Becks stil. Markus: 12 sessioner, 83 978 ord, med en terapeut som delvis arbetar med schematerapi, vilket innebär att sammanfattningen måste översätta materialet tillbaka till KBT-termer. För varje patient skrevs en guldreferens oberoende, efter att transkriptionerna lästs igenom i sin helhet. Inga verkliga patientdata användes.
Arbetsfördelning
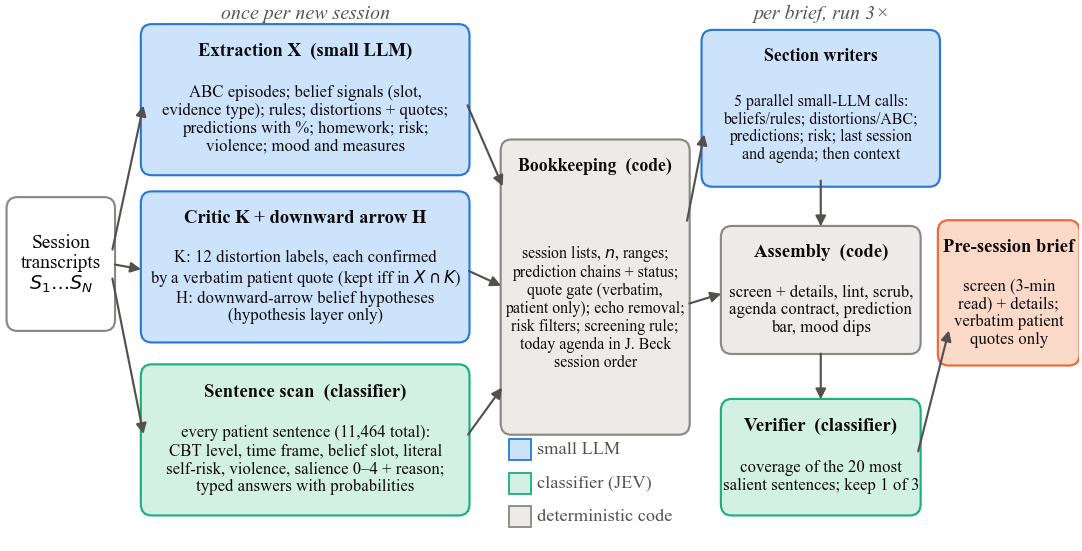
De avgörande förändringarna handlade inte om bättre promptar, utan om en omfördelning av ansvarsområden. Varje komponent gör bara det den är bra på.
Deterministisk kod
Allt som kan räknas, ordnas eller kontrolleras
Sessionslistor, antal och intervall för varje antagande; förutsägelsekedjor länkade mellan sessioner; en spärr för ordagranna citat som tar bort citat som inte återfinns i patientens egna repliker; borttagning av terapeutens ekon; och, från version 28, ordningen på de föreslagna punkterna för dagens session. När ett fel i koden väl har upptäckts åtgärdas det permanent.
En meningsklassificerare
Bedömningar som inte kräver textgenerering
Varje patientmening (11 464 totalt) märks upp en gång: KBT-nivå (automatisk tanke, regel, antagande, känsla, beteende …), tidsram (nu eller återblick), bokstavlig eller bildlig formulering samt hur framträdande meningen kan vara inför nästa session, vart och ett med en sannolikhet. Samma klassificerare används senare som referensfri verifierare och som bedömare av checklistan.
En liten språkmodell
Kort text från förberett material
För varje session extraherar den lilla modellen struktur, bekräftar tankefällor med ordagranna citat och föreslår hypoteser (som lagras som hypoteser, aldrig som belägg). För varje sammanfattning körs fem avsnittsförfattare parallellt. Var och en ser endast sessionsnumrerade data för sitt eget avsnitt och instrueras att aldrig hitta på sessionsnummer eller citat.
Bäst av tre, utan att se svaret
Skillnaderna mellan körningar inom en och samma version var ofta större än skillnaderna mellan versioner. Därför körs pipelinen på sammanfattningsnivå tre gånger, och en verifierare väljer en: den tar de 20 mest framträdande patientmeningarna och frågar klassificeraren om varje mening återspeglas i sammanfattningen. Verifieraren ser aldrig guldreferensen eller checklistan.
Autoresearch-loopen
En automatiserad utvecklingsloop i linje med senare arbete om automatiserade experiment: föreslå en ändring, kör den och behåll den endast om två oberoende mått är samstämmiga.
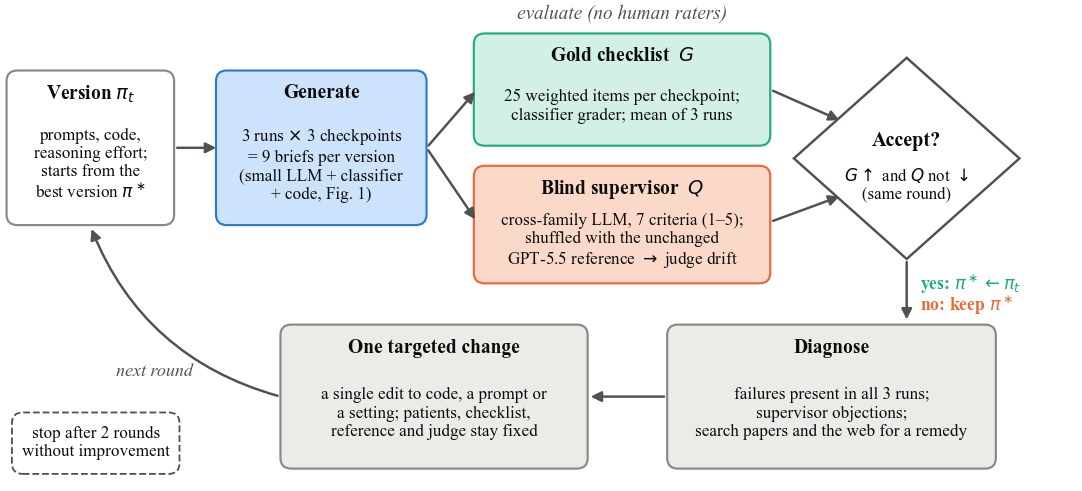
- Två mått. En guldchecklista med 25 viktade påståenden per kontrollpunkt, bedömd av klassificeraren, samt en blind granskning av en LLM-övervakare från en annan modellfamilj, med poäng på sju kriterier på en skala från 1 till 5.
- En fast referenspunkt. Övervakaren ser alltid också en oförändrad frontierreferenssammanfattning, märkt med en slumpmässig bokstav, så att bedömarens egen drift mäts i varje omgång.
- En ändring i taget. Fel som förekommer i alla tre körningarna och övervakarens invändningar ligger till grund för en riktad ändring per omgång, vägledd av en litteratursökning.
- En fast stoppregel. Två omgångar i följd utan förbättring avslutar loopen. Den stannade vid v28.
- Ett fast kostnadstak. Ingen modell som är dyrare än den lilla modellen eller klassificeraren får användas i pipelinen.
Vad vi observerade
Deskriptiv statistik för tre kontrollpunkter (Anita före session 13 och 20, Markus före session 12) och tre körningar per version.
Innehållstäckning: guldchecklistan
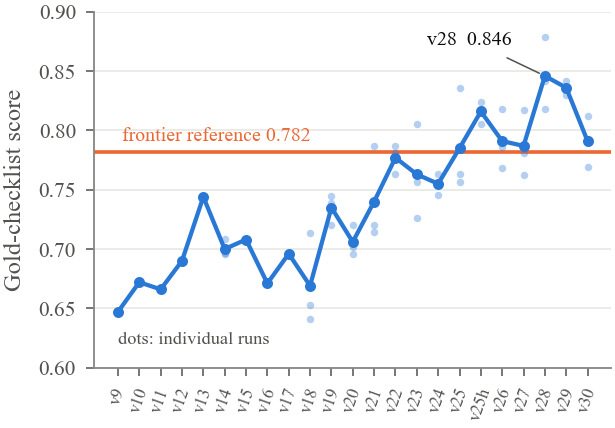
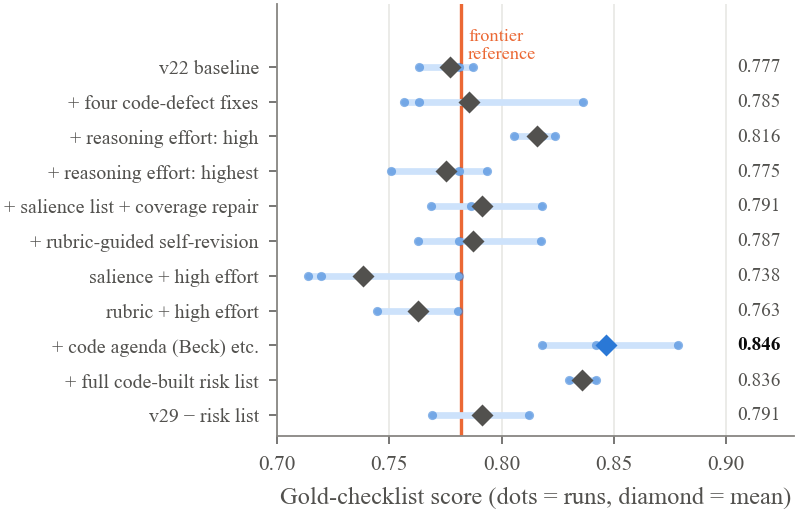
Den lilla modellen började klart under referensen (0.647 mot 0.782), gick om den vid v25 och nådde 0.846 vid v28. Alla tre v28-körningar (0.818, 0.842, 0.879) ligger över referensen. Två senare versioner förbättrades inte jämfört med v28, och loopen stannade.
| Anita, före S13 | Anita, före S20 | Markus, före S12 | |
|---|---|---|---|
| v28, medelvärde av 3 körningar | 0.963 | 0.800 | 0.776 |
| v28, best-of-3 (verifierare) | 0.963 | 0.836 | 0.836 |
| GPT-5.5-referens (1 körning) | 0.963 | 0.655 | 0.727 |
Medelvärden över kontrollpunkter: v28 0.846 · best-of-3 0.879 · referens 0.782.
Blind granskning: inom bedömarens brus
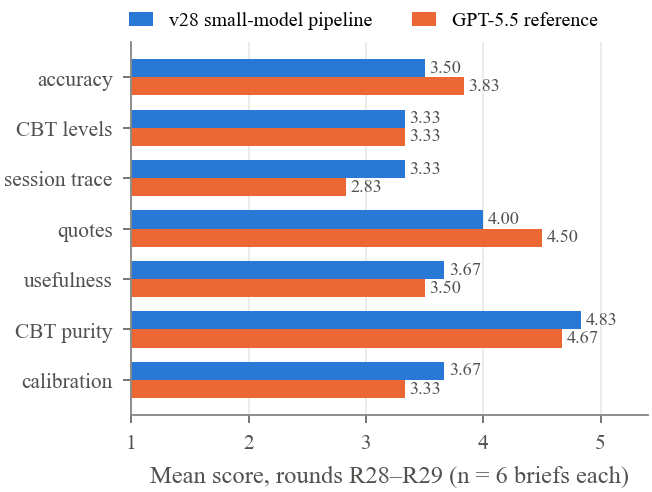
I de sista omgångarna fick den bästa versionen av den lilla modellen och referensen 3.77 mot 3.87 (R28) respektive 3.77 mot 3.57 (R29). Över sex par från samma omgång var skillnaderna −0.4, +0.2, −0.1, −0.5, +0.9, +0.2: medelvärde +0.05, SD 0.49. Inget av systemen nådde övervakarens målsnitt på 4.0. Per kriterium låg v28 före på sessionsspårning och kalibrering, efter på korrekthet (överensstämmelse med guldreferensen) och citat, och jämsides på KBT-nivåer.
Kostnad
En v28-sammanfattning kostar cirka USD 0.03 för avsnittsskrivning och tar 2.5–3 minuter; en best-of-3-sammanfattning kostar cirka USD 0.11. Att bearbeta en ny session tillför cirka USD 0.07, främst för klassificerarens genomgång av varje mening. Enligt listpriser kostar en frontierreferenssammanfattning cirka 19 gånger mer än en enskild v28-sammanfattning. Hela projektet använde småmodellstoken för USD 5.57.
Vad som hjälpte och vad som inte gjorde det
Tre saker hjälpte: att åtgärda fel i deterministisk kod som övervakaren upptäckte, en hög inställning för resonemangsansträngning hos avsnittsförfattarna (den högsta inställningen kostade mer och gav lägre poäng) samt att flytta den föreslagna dagordningen, förutsägelsefältet och det senaste riskrelaterade uttalandet till kod. Flera rimliga tillägg försämrade resultaten: att slå samman tre utkast, en kodbestämd tidslinje över antaganden, saliensledtrådar med ett täckningsreparerande steg samt rubrikstyrd självredigering. Vart och ett lade till ett genereringssteg där en liten modell kan tappa eller förvanska information. Alla ändringar som minskade modellens arbetsbörda eller valde mellan resultat utan att skriva om dem var säkra.
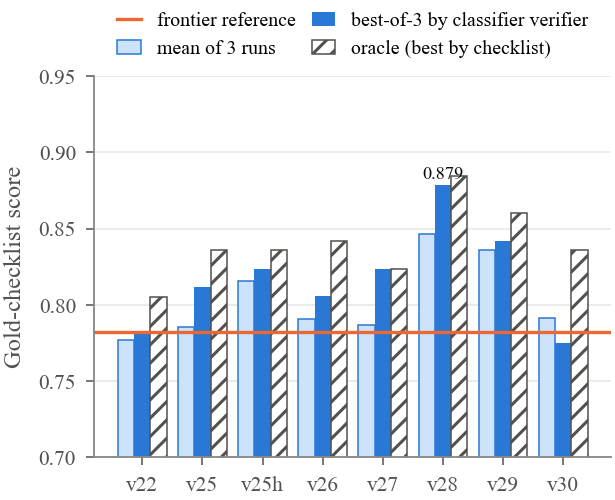
Verifierarurval förbättrade checklistpoängen för sju av åtta versioner; för v28 från 0.846 till 0.879, nära oraklet (0.885). Eftersom verifieraren och checklistbedömaren är samma klassificerare kan en del av denna ökning återspegla gemensamma preferenser.
Vad som förblev svårt
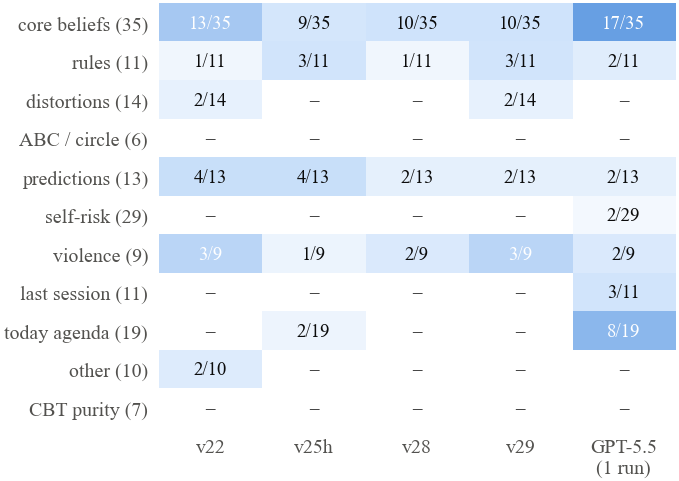
Ihållande fel minskade från 25 till 15 av 164 viktenheter mellan v22 och v28. Det som återstår är de mest subtila bedömningarna i den kognitiva modellen: tillståndet hos ett antagande efter att det återaktiverats, antagandeintervall som slutar före det senaste materialet och avgränsningar av räckvidden. Rader om risk var den svåraste komponenten: både att missa ett aktuellt uttalande och att tolka en metafor, en övning eller en känsloskattning som en signal gav avdrag. Den bästa utformningen behöll bara det senaste bokstavliga uttalandet och den session då terapeuten senast frågade direkt om det, och lämnade alla tolkningar åt terapeuten.
Bedömaren är en del av experimentet
Eftersom referenssammanfattningen aldrig ändrades mäter dess poäng endast övervakaren.
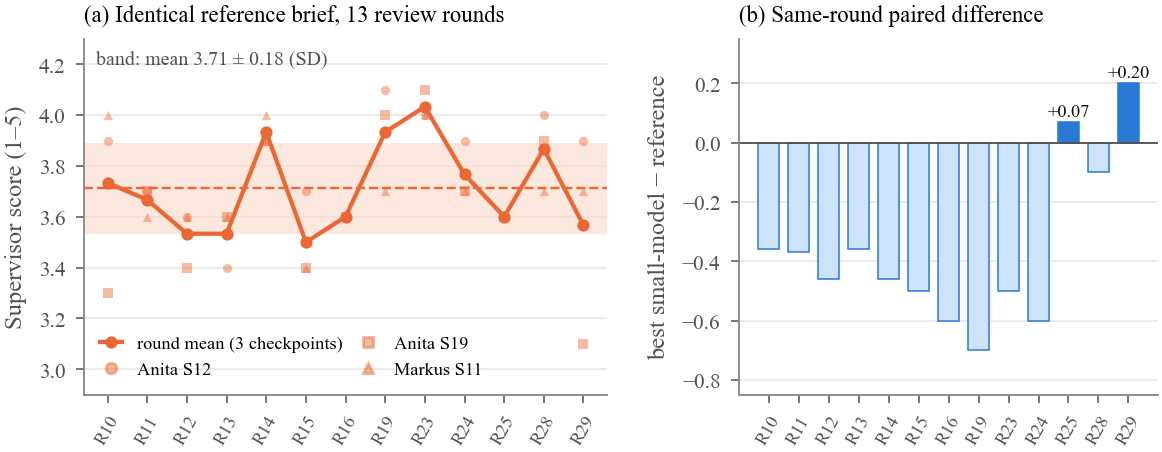
Under 13 omgångar fick den identiska referenssammanfattningen ett omgångsmedelvärde på 3.71 med SD 0.18 och ett intervall på 3.50–4.03 på en skala från 1 till 5. För enskilda kriterier nådde SD 0.46, även för citat som verifierats med skript och var identiska varje gång. Detta brus är ungefär lika stort som hela förbättringen som loopen åstadkom på samma skala.
Vad denna studie inte visar
- Endast syntetiska data. Två syntetiska patienter, tre kontrollpunkter, tre körningar per version. Endast deskriptiv statistik, inga signifikanstester. Överförbarhet till andra uppgifter och verkligt material diskuteras, men visas inte.
- Endast modelbaserad utvärdering. Inga kliniker eller andra mänskliga bedömare deltog, enligt upplägget. Poängen beskriver överensstämmelse med en guldchecklista och en LLM-övervakares bedömning, inte klinisk kvalitet, säkerhet eller någon effekt på terapi.
- Tränad mot utvärderingsmängden. Alla versioner utvecklades mot samma kontrollpunkter och bedömare, vilket gör slutpoängen optimistiska. En patient som hålls utanför utvecklingen vore det rätta testet.
- Att inte kunna skilja åt är inte detsamma som att vara bättre. I blind granskning gick det inte att skilja den lilla modellen från frontierreferensen vid denna urvalsstorlek; skillnaderna ligger inom bedömarens eget brus.
- Delad klassificerare. Checklistbedömaren, meningsskannern och verifieraren är samma modell.
- En måttlig referens. Frontierreferensen är en tidigare, ooptimerad pipelinekörning med GPT-5.5, körd en gång, inte en frontierpipeline som optimerats med samma loop.
Läs artikeln, kontrollera siffrorna
Hela artikeln kan laddas ned kostnadsfritt. Datapaketet med checklistor, poäng och exempelsammanfattningar skickas via e-post.
Artikeln
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Förtryck, 13 sidor, 9 figurer.
Ladda ned datapaketet
PDF av artikeln, alla nio figurer, de tre guldchecklistorna, checklist- och verifierarpoäng för varje version, blinda granskningar från de sista omgångarna med tillhörande bokstavsnycklar samt tre slutliga exempelsammanfattningar. En README förklarar varje fält.
Vi delar inte adresser. Datalänken kommer inom några minuter.
Detta ingår i ZIP-filen
paper/: artikeln som PDFfigures/: nio figurer samt siffrorna bakom demscores/gold_checklists.json: 3 × 25 viktade påståendenscores/checklist_results.json: sannolikheter per bedömt objekt för 198 bedömda sammanfattningarscores/blind_review_R28.json,R29: sju kriterier, utlåtanden och invändningar, med bokstavsnycklarexample-briefs/: tre slutliga v28-sammanfattningar (på polska, liksom transkriptionerna)
Ingår inte: syntetiska transkriptioner, promptar och kod. De kan fås från författarna på begäran för forskningsbruk.
Så här citerar du
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}