
Lille model, omhyggelig pipeline
En autoresearch-metode til at mindske afstanden til frontier-LLM'er inden for opsummering af lange dokumenter på tværs af flere kilder. Afprøvet på briefinger før sessioner, udarbejdet på grundlag af transskriptioner fra to syntetiske patienter.
En billig model kan komme tæt på, hvis den gør mindre
Frontier-sprogmodeller opsummerer lange dokumenter fra flere kilder godt, men det bliver dyrt at køre en sådan model før hvert output. Små modeller er billige, men mister information ved lange input. Vi undersøgte, hvor langt en billig model kan nå, når den indgår i en omhyggeligt udviklet pipeline og forbedres gennem en automatiseret sløjfe, der evaluerer hver ændring med andre modeller uden menneskelige bedømmere.
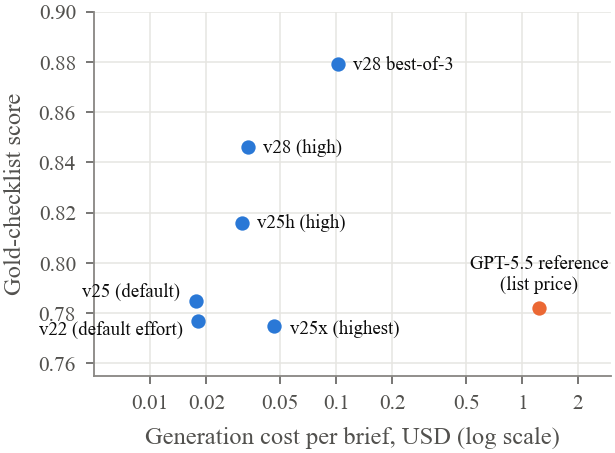
Over 30 versioner og 16 blinde evalueringsrunder steg den lille models score fra 0.647 til 0.846 på en vægtet guldtjekliste (0.879, når en referencefri verifier vælger den bedste af tre kørsler). Frontier-referencen scorede 0.782. I blind evaluering foretaget af en LLM-vejleder kunne de to ikke skelnes ved denne stikprøvestørrelse: den gennemsnitlige parrede forskel var +0.05 (SD 0.49). Den samme, uændrede referencebriefing fik mellem 3.50 og 4.03 fra vejlederen over 13 runder, så dommerens egen støj viste sig at være et forskningsresultat i sig selv.
Indhold
Langt input, fast struktur, rutinemæssig brug
Mange praktiske opsummeringsopgaver har tre fælles egenskaber: Inputtet er langt og fordelt på mange dokumenter, outputtet følger en fast struktur med tællinger, datoer og ordrette belæg, og outputtet produceres rutinemæssigt, så omkostningerne har betydning.
Vi brugte en sådan opgave som testmiljø: en struktureret briefing, som en KAT-terapeut kan læse på omkring tre minutter før en session. Den oplister kerneoverbevisninger med antal sessioner, regler, tilbagevendende forvrængninger, typiske ABC-episoder, afprøvede forudsigelser, den seneste session og punkter, terapeuten eventuelt vil tage op i dagens session. Ved session 20 er materialet på omkring 130,000 ord.
Opgaven egner sig til et metodestudie, fordi den har en kendt struktur (Becks kognitive model), en naturlig form for verificerbart belæg (patientens ordrette udsagn) og flere faldgruber: en overbevisning, der først blev formuleret af terapeuten, eller en metafor, der ikke er et udsagn om døden.
To syntetiske patienter
Begge patienter blev genereret med vores lagdelte metode til syntetiske patienter (først profilark, terapeutisk forløb, sessionsplan og stemmevejledning, derefter sessioner genereret én ad gangen som ASR-lignende transskriptioner). Anita: 20 sessioner, 131,498 ord, KAT i J. Becks stil. Markus: 12 sessioner, 83,978 ord, med en terapeut, der delvist arbejder med skematerapi, så briefingen skal omsætte materialet til KAT-termer. For hver patient blev en guldreference skrevet uafhængigt på baggrund af en fuld gennemlæsning af transskriptionerne. Der blev ikke brugt data fra virkelige patienter.
Arbejdsdeling
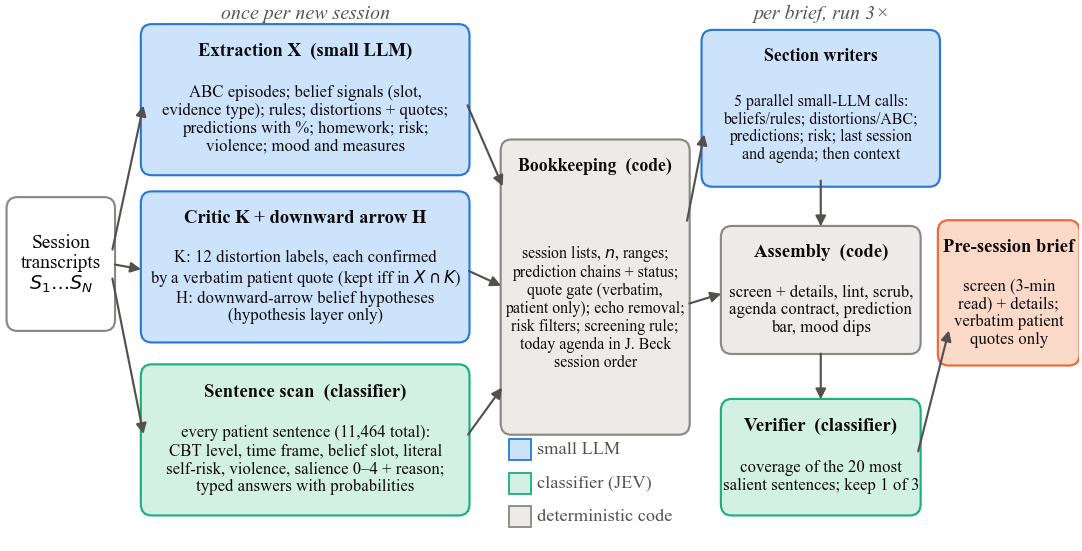
De afgørende ændringer var ikke bedre prompts, men en ny fordeling af ansvar. Hver komponent udfører kun det, den er god til.
Deterministisk kode
Alt, der kan tælles, sorteres eller kontrolleres
Sessionslister, tællinger og intervaller for hver overbevisning; forudsigelseskæder, der forbindes på tværs af sessioner; en gate til ordrette citater, der fjerner citater, som ikke findes i patientens egne replikker; fjernelse af terapeutens gentagelser; og fra version 28 rækkefølgen af de foreslåede punkter til dagens session. Når en fejl i denne kode først er fundet, bliver den rettet permanent.
En sætningsklassifikator
Vurderinger, der ikke kræver tekstgenerering
Hver patientsætning (11,464 i alt) mærkes én gang: KAT-niveau (automatisk tanke, regel, overbevisning, følelse, adfærd …), tidsramme (nu eller erindret), bogstavelig eller billedlig formulering og hvor fremtrædende sætningen kan være for den næste session, hver med en sandsynlighed. Den samme klassifikator bruges senere som referencefri verifier og til at bedømme tjeklisten.
En lille sprogmodel
Kort tekst ud fra forberedt materiale
For hver session udtrækker den lille model strukturen, bekræfter forvrængninger med ordrette citater og foreslår hypoteser (lagret som hypoteser, aldrig som belæg). For hver briefing kører fem afsnitsskribenter parallelt; hver ser kun de sessionsnummererede data for sit eget afsnit og får besked på aldrig at opfinde sessionsnumre eller citater.
Bedste af tre, uden at se svaret
Forskellene mellem kørsler inden for én version var ofte større end forskellene mellem versioner. Derfor køres pipelinen på briefingniveau tre gange, og en verifier vælger én: Den tager de 20 mest fremtrædende patientsætninger og spørger klassifikatoren, om hver af dem afspejles i briefingen. Verifieren ser aldrig guldreferencen eller tjeklisten.
Autoresearch-sløjfen
En automatiseret udviklingssløjfe i stil med nyere arbejde inden for automatiseret eksperimentering: Foreslå én ændring, afprøv den, og behold den kun, hvis to uafhængige målinger er enige.
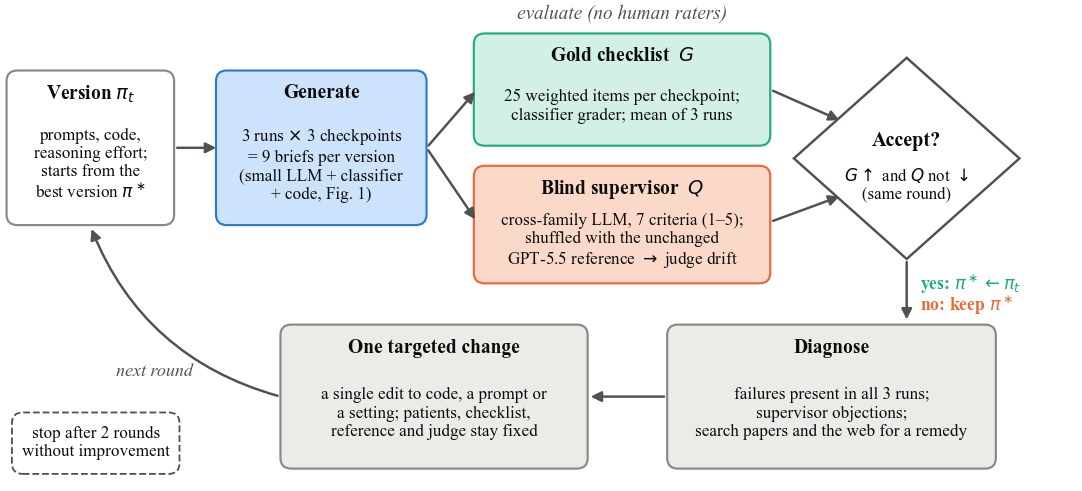
- To målinger. En guldtjekliste med 25 vægtede udsagn pr. kontrolpunkt, bedømt af klassifikatoren, og en blind evaluering udført af en LLM-vejleder fra en anden modelfamilie, der scorer syv kriterier på en skala fra 1 til 5.
- Et fast holdepunkt. Vejlederen ser altid også én uændret frontier-referencebriefing under et tilfældigt bogstav, så dommerens egen drift måles i hver runde.
- Én ændring ad gangen. Fejl, der findes i alle tre kørsler, og vejlederens indvendinger danner grundlag for én målrettet ændring pr. runde, informeret af en litteratursøgning.
- En fast stopregel. To runder i træk uden forbedring afslutter sløjfen. Den stoppede ved v28.
- Et fast omkostningsloft. Ingen model, der er dyrere end den lille model eller klassifikatoren, må bruges i pipelinen.
Hvad vi observerede
Deskriptiv statistik for tre kontrolpunkter (Anita før session 13 og 20, Markus før session 12) og tre kørsler pr. version.
Indholdsdækning: guldtjeklisten
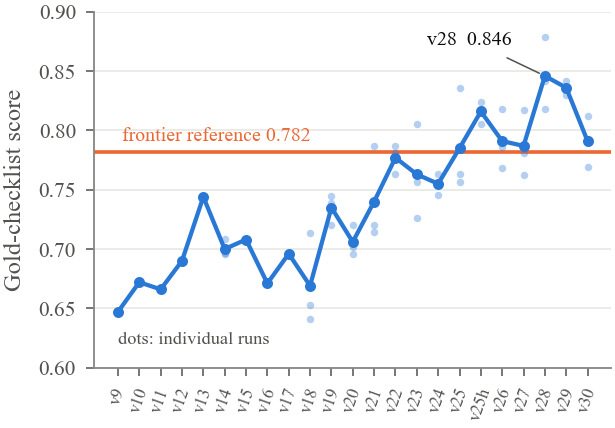
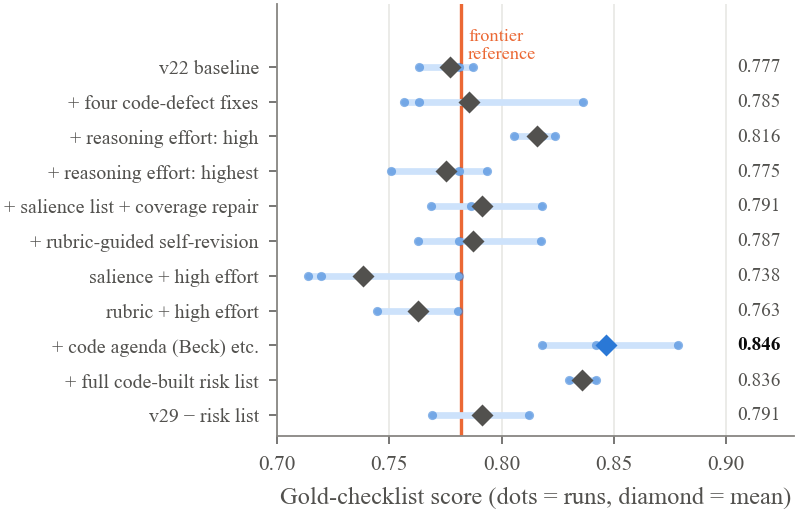
Den lille model startede et godt stykke under referencen (0.647 mod 0.782), passerede den ved v25 og nåede 0.846 ved v28. Alle tre v28-kørsler (0.818, 0.842, 0.879) ligger over referencen. To senere versioner forbedrede ikke v28, og sløjfen blev stoppet.
| Anita, før S13 | Anita, før S20 | Markus, før S12 | |
|---|---|---|---|
| v28, gennemsnit af 3 kørsler | 0.963 | 0.800 | 0.776 |
| v28, best-of-3 (verifier) | 0.963 | 0.836 | 0.836 |
| GPT-5.5-reference (1 kørsel) | 0.963 | 0.655 | 0.727 |
Gennemsnit over kontrolpunkterne: v28 0.846 · best-of-3 0.879 · reference 0.782.
Blind evaluering: inden for dommerens støj
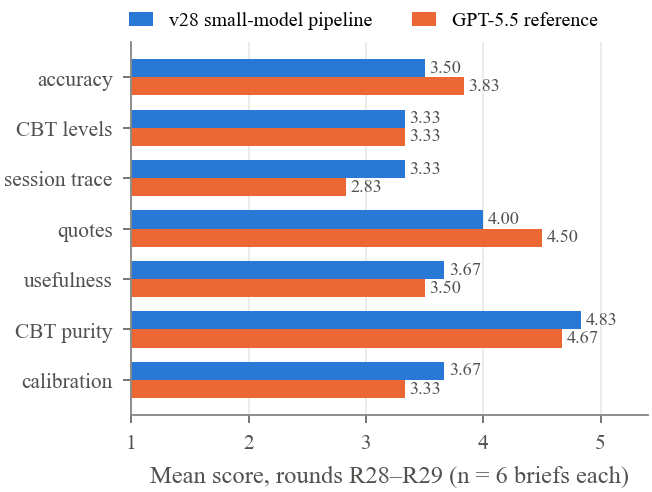
I de sidste runder scorede den bedste version af den lille model og referencen henholdsvis 3.77 mod 3.87 (R28) og 3.77 mod 3.57 (R29). På tværs af seks par fra samme runde var forskellene −0.4, +0.2, −0.1, −0.5, +0.9, +0.2: gennemsnit +0.05, SD 0.49. Ingen af systemerne nåede vejlederens målgennemsnit på 4.0. Kriterievis lå v28 foran på sessionsporing og kalibrering, bagefter på nøjagtighed (overensstemmelse med guldreferencen) og citater og på niveau med hensyn til KAT-niveauer.
Omkostninger
Én v28-briefing koster omkring USD 0.03 i afsnitsskrivning og tager 2.5–3 minutter; en best-of-3-briefing koster omkring USD 0.11. Behandling af en ny session koster omkring USD 0.07 ekstra, hovedsageligt på grund af klassifikatorens gennemgang af hver sætning. Ved listepriser koster en frontier-referencebriefing omkring 19 gange så meget som én v28-briefing. Hele projektet brugte USD 5.57 på tokens fra den lille model.
Hvad hjalp, og hvad gjorde ikke
Tre ting hjalp: rettelse af fejl i deterministisk kode, som vejlederen fandt; en høj indstilling for ræsonneringsindsats hos afsnitsskribenterne (den højeste indstilling kostede mere og scorede lavere); og flytning af den foreslåede dagsorden, forudsigelseslinjen og den seneste risikorelaterede udtalelse over i kode. Flere plausible tilføjelser forringede resultatet: sammenfletning af tre udkast, en kodefastlagt tidslinje for overbevisninger, fremtrædendeshints med en dækningsreparerende gennemgang og rubrikstyret selvrevision. Hver af dem tilføjede et genereringstrin, hvor en lille model kan miste eller forvride information. Alle ændringer, der fjernede opgaver fra modellen eller udvalgte mellem output uden at omskrive dem, var sikre.
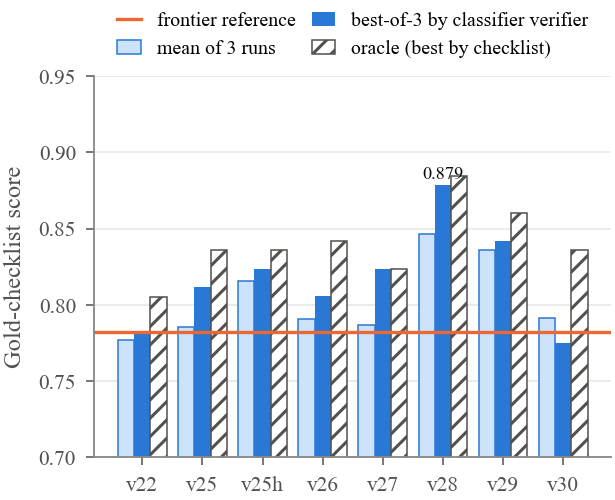
Verifierens udvælgelse forbedrede tjeklistescoren for syv af otte versioner; for v28 fra 0.846 til 0.879, tæt på oraklet (0.885). Da verifieren og tjeklistebedømmeren er den samme klassifikator, kan en del af denne gevinst afspejle fælles præferencer.
Hvad der fortsat var svært
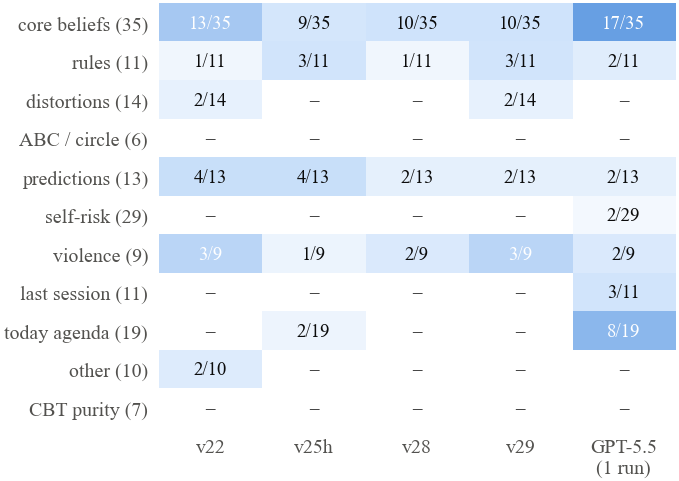
Vedvarende fejl faldt fra 25 til 15 af 164 vægtenheder mellem v22 og v28. Det, der er tilbage, er de mest subtile vurderinger i den kognitive model: en overbevisnings tilstand, efter at den er blevet aktiveret igen, intervaller for overbevisninger, der stopper før det seneste materiale, og forbehold om rækkevidden. Udsagn om risiko var den sværeste komponent: Der blev givet straf både for at overse en nylig udtalelse og for at gøre en metafor, en øvelse eller en følelsesvurdering til et signal. Det bedste design beholdt kun den seneste bogstavelige udtalelse og den session, hvor terapeuten sidst spurgte direkte til den, og overlod alle fortolkninger til terapeuten.
Dommeren er en del af eksperimentet
Fordi referencebriefingen aldrig ændrede sig, måler dens scorer alene vejlederen.
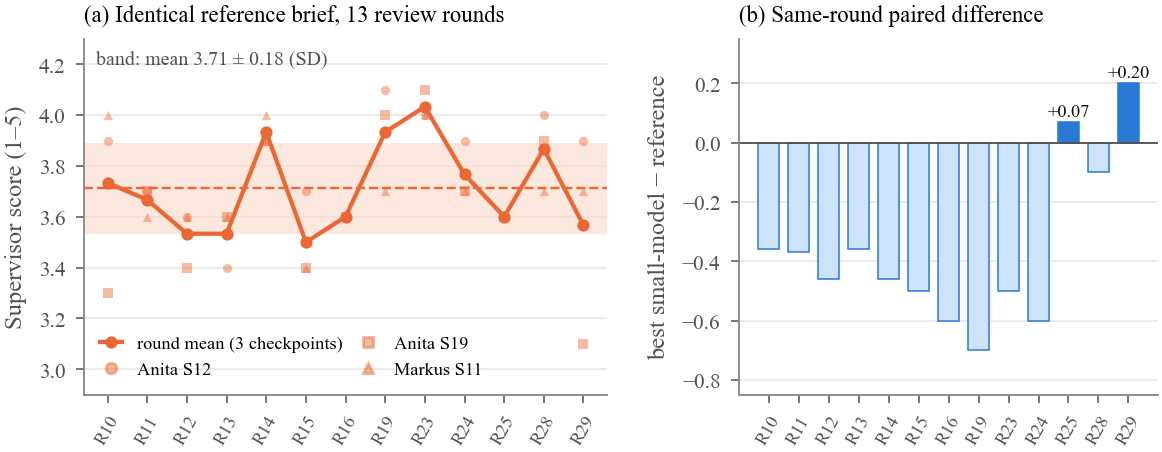
Over 13 runder fik den identiske referencebriefing et rundegennemsnit på 3.71 med SD 0.18 og et spænd på 3.50–4.03 på en skala fra 1 til 5. For enkelte kriterier nåede SD 0.46, også for citater, der blev verificeret af et script og var identiske hver gang. Denne støj er omtrent lige så stor som hele den forbedring, sløjfen frembragte på den samme skala.
Hvad dette studie ikke viser
- Kun syntetiske data. To syntetiske patienter, tre kontrolpunkter, tre kørsler pr. version. Kun deskriptiv statistik, ingen signifikanstests. Overførsel til andre opgaver og virkeligt materiale argumenteres for, men vises ikke.
- Kun modelevaluering. Ingen klinikere eller andre menneskelige bedømmere deltog, helt bevidst. Scorerne beskriver overensstemmelse med en guldtjekliste og en LLM-vejleders vurdering, ikke klinisk kvalitet, sikkerhed eller nogen effekt på terapi.
- Tilpasset til evalueringssættet. Alle versioner blev udviklet mod de samme kontrolpunkter og dommere, så de endelige scorer er optimistiske. En tilbageholdt patient ville være den rette test.
- Ikke til at skelne fra hinanden betyder ikke bedre. I den blinde evaluering kunne den lille model og frontier-referencen ikke skelnes ved denne stikprøvestørrelse; forskellene ligger inden for dommerens egen støj.
- Fælles klassifikator. Tjeklistebedømmeren, sætningsscanneren og verifieren er den samme model.
- En beskeden reference. Frontier-referencen er én tidligere, uoptimeret pipelinekørsel med GPT-5.5, ikke en frontier-pipeline, der er optimeret med den samme sløjfe.
Læs artiklen, efterprøv tallene
Hele artiklen kan downloades gratis. Datapakken med tjeklister, scorer og eksempelbriefinger sendes via e-mail.
Artiklen
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Fortryk, 13 sider, 9 figurer.
Download datapakken
PDF af artiklen, alle ni figurer, de tre guldtjeklister, tjekliste- og verifierscorer for hver version, blinde evalueringer fra de sidste runder med deres bogstavnøgler samt tre endelige eksempelbriefinger. En README forklarer alle felter.
Vi deler ikke e-mailadresser. Datalinket kommer inden for få minutter.
Indhold i ZIP-filen
paper/: artiklen som PDFfigures/: ni figurer plus de bagvedliggende talscores/gold_checklists.json: 3 × 25 vægtede udsagnscores/checklist_results.json: sandsynligheder pr. element for 198 bedømte briefingerscores/blind_review_R28.json,R29: syv kriterier, vurderinger og indvendinger med bogstavnøglerexample-briefs/: tre endelige v28-briefinger (på polsk, ligesom transskriptionerne)
Ikke inkluderet: syntetiske transskriptioner, prompts og kode. De fås fra forfatterne på anmodning til forskningsbrug.
Sådan citeres artiklen
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}