
პატარა მოდელი, ფრთხილად აგებული პაიპლაინი
ავტოკვლევის მეთოდი გრძელ, მრავალდოკუმენტიან შეჯამებაში მოწინავე LLM-ებთან სხვაობის შესამცირებლად. გამოიცადა ორი სინთეზური პაციენტის ტრანსკრიპტებიდან შექმნილ სესიამდელ ბრიფებზე.
იაფი მოდელი შეიძლება ახლოს მივიდეს, თუ ნაკლებს აკეთებს
მოწინავე ენობრივი მოდელები გრძელ, მრავალდოკუმენტიან მასალას კარგად აჯამებენ, თუმცა ყოველი შედეგის წინ მათი გაშვება ძვირი ჯდება. პატარა მოდელები იაფია, მაგრამ გრძელ შეყვანებზე ინფორმაციას კარგავენ. ჩვენ ვიკითხეთ, რამდენად შორს შეიძლება წავიდეს დაბალი ღირებულების მოდელი, როცა ის საგულდაგულოდ დაპროექტებულ პაიპლაინში მუშაობს და მას აუმჯობესებს ავტომატიზებული ციკლი, რომელიც ყოველ ცვლილებას სხვა მოდელებით აფასებს, ადამიან შემფასებელთა მონაწილეობის გარეშე.
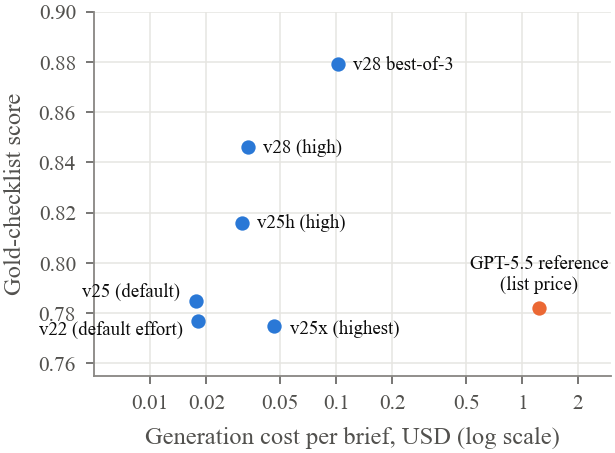
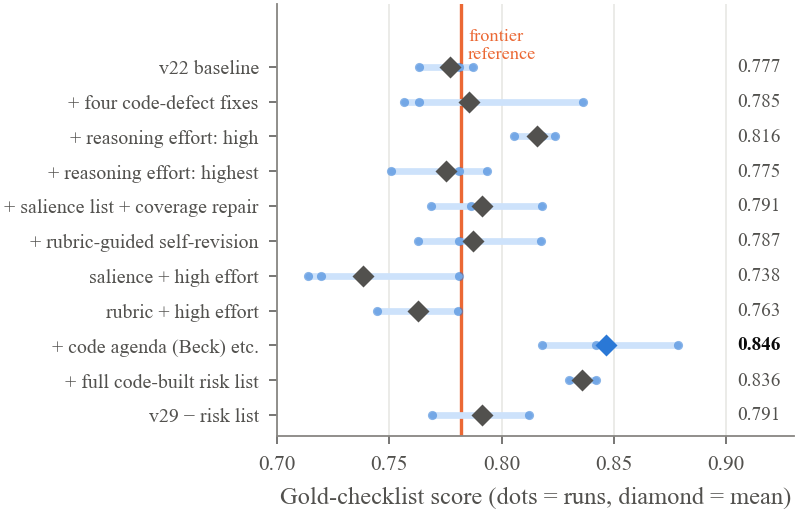
30-ზე მეტი ვერსიისა და ბრმა მიმოხილვის 16 რაუნდის განმავლობაში პატარა მოდელის ქულა შეწონილი gold checklist-ის მიხედვით 0.647-დან 0.846-მდე გაიზარდა (0.879, როცა სამ გაშვებას შორის არჩევანს საცნობარო მონაცემების არმქონე ვერიფიკატორი აკეთებდა). მოწინავე მოდელის საცნობარო მაჩვენებელი 0.782 იყო. LLM ზედამხედველის მიერ ჩატარებული ბრმა მიმოხილვისას, ამ ზომის შერჩევაში, მათი გარჩევა შეუძლებელი აღმოჩნდა: შეწყვილებული სხვაობის საშუალო იყო +0.05 (SD 0.49). იმავე, უცვლელმა საცნობარო ბრიფმა ზედამხედველისგან 13 რაუნდის განმავლობაში 3.50-დან 4.03-მდე ქულა მიიღო, ამიტომ მსაჯის საკუთარი ცვალებადობა ცალკე მნიშვნელოვან მიგნებად იქცა.
შინაარსი
გრძელი შეყვანა, ფიქსირებული სტრუქტურა, რუტინული გამოყენება
შეჯამების ბევრ პრაქტიკულ ამოცანას სამი საერთო მახასიათებელი აქვს: შეყვანა გრძელია და მრავალ დოკუმენტშია განაწილებული; შედეგს აქვს ფიქსირებული სტრუქტურა, რომელშიც შედის რაოდენობები, თარიღები და სიტყვასიტყვითი მტკიცებულებები; და შედეგი რუტინულად მზადდება, ამიტომ ღირებულებას მნიშვნელობა აქვს.
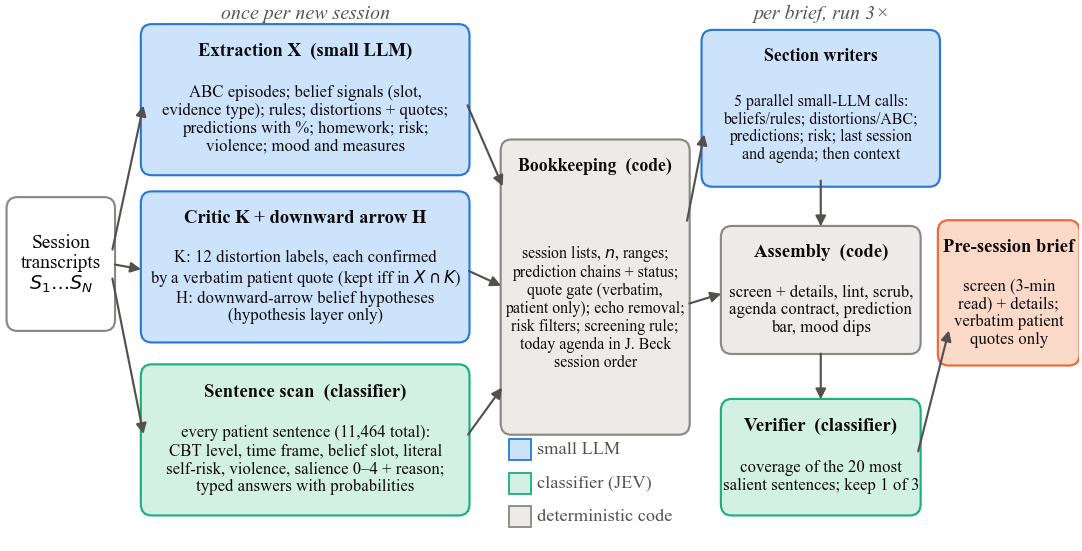
სატესტო ამოცანად ავიღეთ ერთი ასეთი დავალება: სტრუქტურირებული ბრიფი, რომლის წაკითხვას კოგნიტურ-ქცევითი თერაპიის (CBT) თერაპევტი სესიამდე დაახლოებით სამ წუთს ანდომებს. მასში ჩამოთვლილია ძირითადი რწმენები სესიების რაოდენობით, წესები, განმეორებადი დამახინჯებები, ტიპური ABC ეპიზოდები, შემოწმებული პროგნოზები, ბოლო სესია და საკითხები, რომელთა წამოჭრაც თერაპევტს დღევანდელ სესიაზე შეიძლება სურდეს. მე-20 სესიისთვის მასალა დაახლოებით 130,000 სიტყვას მოიცავს.
ეს ამოცანა მეთოდოლოგიური კითხვის შესასწავლად გამოდგება, რადგან აქვს ცნობილი სტრუქტურა (ბეკის კოგნიტური მოდელი), გადამოწმებადი მტკიცებულების ბუნებრივი წყარო (პაციენტის სიტყვასიტყვითი ნათქვამი) და რამდენიმე შესაძლო შეცდომა: რწმენა, რომელიც პირველად თერაპევტმა ჩამოაყალიბა, ან მეტაფორა, რომელიც სიკვდილზე განცხადებას არ წარმოადგენს.
ორი სინთეზური პაციენტი
ორივე პაციენტი შეიქმნა სინთეზური პაციენტის ჩვენი ეტაპობრივი მეთოდით (ჯერ პროფილის ფურცელი, თერაპიული რკალი, სესიების გეგმა და საუბრის მანერის გზამკვლევი, შემდეგ კი სესიები სათითაოდ, ASR-ის სტილის ტრანსკრიპტებად). Anita: 20 სესია, 131,498 სიტყვა, ჯ. ბეკის სტილის CBT. Markus: 12 სესია, 83,978 სიტყვა; მისი თერაპევტი ნაწილობრივ სქემა-თერაპიას იყენებს, ამიტომ ბრიფში მასალა CBT-ის ტერმინებში უნდა გადმოიცეს. თითოეული პაციენტისთვის gold საცნობარო ტექსტი ტრანსკრიპტების სრულად წაკითხვის საფუძველზე დამოუკიდებლად დაიწერა. რეალური პაციენტების მონაცემები არ გამოგვიყენებია.
შრომის დანაწილება
გადამწყვეტი ცვლილებები უკეთესი პრომპტები კი არა, პასუხისმგებლობების ხელახლა განაწილება იყო. თითოეული კომპონენტი მხოლოდ იმას აკეთებს, რაშიც ძლიერია.
დეტერმინისტული კოდი
ყველაფერი, რისი დათვლა, დალაგება ან შემოწმებაც შესაძლებელია
სესიების სიები, თითოეული რწმენის რაოდენობები და დიაპაზონები; სესიებს შორის დაკავშირებული პროგნოზების ჯაჭვები; სიტყვასიტყვითი ციტატის ფილტრი, რომელიც შლის პაციენტის საკუთარ სტრიქონებში არმყოფ ციტატებს; თერაპევტის მიერ გამეორებული ფრაზების მოცილება; ხოლო 28-ე ვერსიიდან — დღევანდელი სესიისთვის შეთავაზებული საკითხების თანმიმდევრობა. კოდში აღმოჩენილი ხარვეზის გასწორების შემდეგ ის მუდმივად გასწორებული რჩება.
წინადადებების კლასიფიკატორი
შეფასებები, რომლებსაც ტექსტის გენერირება არ სჭირდება
პაციენტის თითოეული წინადადება (სულ 11,464) ერთხელ კლასიფიცირდება: CBT-ის დონე (ავტომატური აზრი, წესი, რწმენა, ემოცია, ქცევა…), დროითი ჩარჩო (ახლანდელი ან წარსულის გახსენება), სიტყვასიტყვითი თუ გადატანითი ფორმულირება და ის, რამდენად მნიშვნელოვანი შეიძლება იყოს წინადადება მომდევნო სესიისთვის; თითოეულს ალბათობა ენიჭება. მოგვიანებით იგივე კლასიფიკატორი გამოიყენება საცნობარო მონაცემების არმქონე ვერიფიკატორად და საკონტროლო სიის შემფასებლადაც.
პატარა ენობრივი მოდელი
მოკლე ტექსტის დაწერა მომზადებული მასალიდან
თითოეული სესიისთვის პატარა მოდელი სტრუქტურას ამოიღებს, დამახინჯებებს სიტყვასიტყვითი ციტატებით ადასტურებს და ჰიპოთეზებს სთავაზობს (ისინი ჰიპოთეზებად ინახება და არასდროს მიიჩნევა მტკიცებულებად). თითოეული ბრიფისთვის ხუთი სექციის დამწერი зэрэгцүүлэн ажилладаг, тус бүр нь зөвхөн საკუთარი განყოფილებისთვის განკუთვნილ, სესიის ნომრებით მონიშნულ მონაცემებს ხედავს და ეძლევა ინსტრუქცია, არასდროს გამოიგონოს სესიის ნომრები ან ციტატები.
სამიდან საუკეთესო, პასუხისთვის შეუხედავად
ერთი ვერსიის ფარგლებში გაშვებებს შორის განსხვავებები ხშირად ვერსიებს შორის განსხვავებებზე დიდი იყო. ამიტომ ბრიფის პაიპლაინი სამჯერ მუშაობს და ვერიფიკატორი ერთ შედეგს ირჩევს: ის იღებს პაციენტის 20 ყველაზე მნიშვნელოვან წინადადებას და კლასიფიკატორს ეკითხება, აისახა თუ არა თითოეული მათგანი ბრიფში. ვერიფიკატორი ვერ ხედავს gold საცნობარო ტექსტს ან საკონტროლო სიას.
ავტოკვლევის ციკლი
ავტომატიზებული განვითარების ციკლი, რომელიც უახლესი ავტომატიზებული ექსპერიმენტების მიდგომებს ეყრდნობა: შესთავაზე ერთი ცვლილება, გაუშვი და შეინარჩუნე მხოლოდ მაშინ, თუ ორი დამოუკიდებელი მეტრიკა თანხმდება.
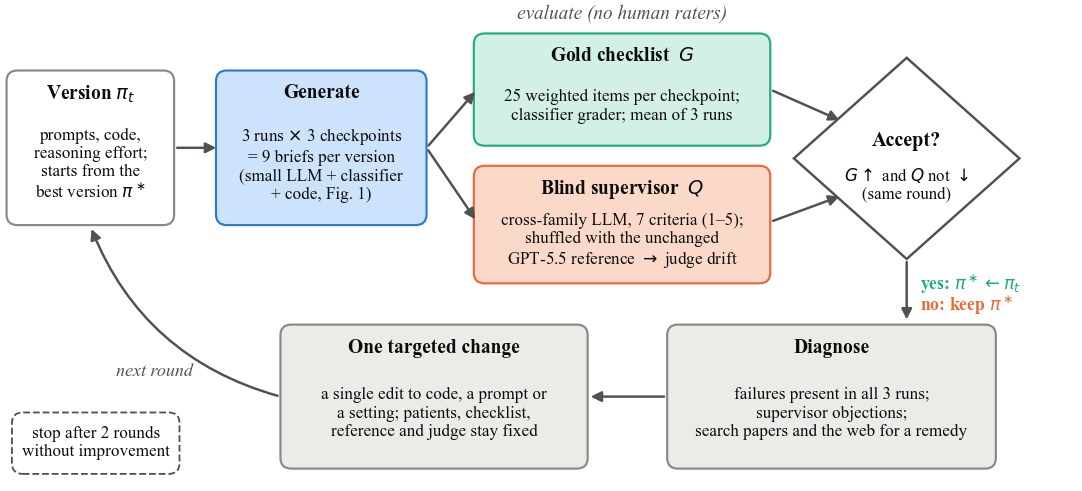
- ორი მეტრიკა. თითოეულ საკონტროლო წერტილზე 25 შეწონილი დებულებისგან შემდგარი gold checklist, რომელსაც კლასიფიკატორი აფასებს, და სხვა მოდელურ ოჯახზე გაწვრთნილი LLM ზედამხედველის ბრმა მიმოხილვა, რომელიც შვიდ კრიტერიუმს 1–5 შკალაზე აფასებს.
- ფიქსირებული საყრდენი. ზედამხედველს ყოველთვის ეჩვენება ერთი უცვლელი მოწინავე საცნობარო ბრიფიც, შემთხვევითი ასოს ქვეშ, რათა მსაჯის საკუთარი ცვალებადობა ყოველ რაუნდში იზომებოდეს.
- ერთ ჯერზე ერთი ცვლილება. სამივე გაშვებაში გამოვლენილი ხარვეზები და ზედამხედველის შენიშვნები განსაზღვრავს თითო რაუნდში ერთ მიზნობრივ ცვლილებას, რომელსაც ლიტერატურის ძიება ეხმარება.
- ფიქსირებული გაჩერების წესი. გაუმჯობესების გარეშე ზედიზედ ორი რაუნდი ციკლს ასრულებს. ის v28-ზე შეჩერდა.
- ფიქსირებული ხარჯის ზღვარი. პაიპლაინში არ შეიძლება გამოყენებულ იქნას პატარა მოდელზე ან კლასიფიკატორზე ძვირი მოდელი.
რას დავაკვირდით
აღწერითი სტატისტიკა სამ საკონტროლო წერტილზე (Anita-სთვის მე-13 და მე-20 სესიამდე, Markus-ისთვის მე-12 სესიამდე) და თითოეული ვერსიის სამი გაშვებისთვის.
შინაარსის დაფარვა: gold checklist
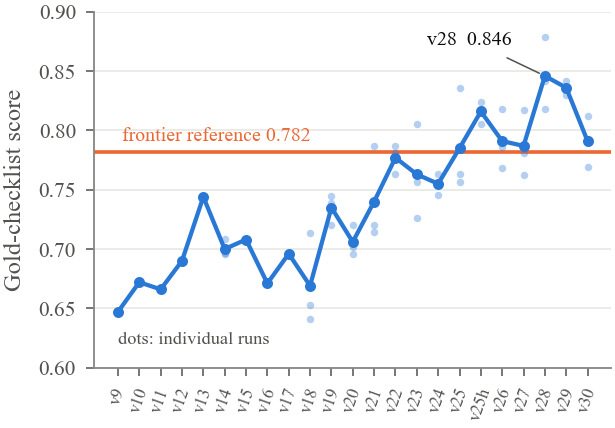
პატარა მოდელმა საცნობარო მოდელზე მნიშვნელოვნად დაბალი ქულით დაიწყო (0.647 vs 0.782), v25-ზე მას გადააჭარბა და v28-ზე 0.846-ს მიაღწია. v28-ის სამივე გაშვების ქულა (0.818, 0.842, 0.879) საცნობარო მაჩვენებელზე მაღალია. მოგვიანებით შექმნილმა ორმა ვერსიამ v28-ს ვერ აჯობა და ციკლი შეჩერდა.
| Anita, S13-მდე | Anita, S20-მდე | Markus, S12-მდე | |
|---|---|---|---|
| v28, 3 გაშვების საშუალო | 0.963 | 0.800 | 0.776 |
| v28, best-of-3 (ვერიფიკატორი) | 0.963 | 0.836 | 0.836 |
| GPT-5.5-ის საცნობარო მაჩვენებელი (1 გაშვება) | 0.963 | 0.655 | 0.727 |
საკონტროლო წერტილების საშუალო: v28 0.846 · best-of-3 0.879 · საცნობარო მაჩვენებელი 0.782.
ბრმა მიმოხილვა: მსაჯის ცვალებადობის ფარგლებში
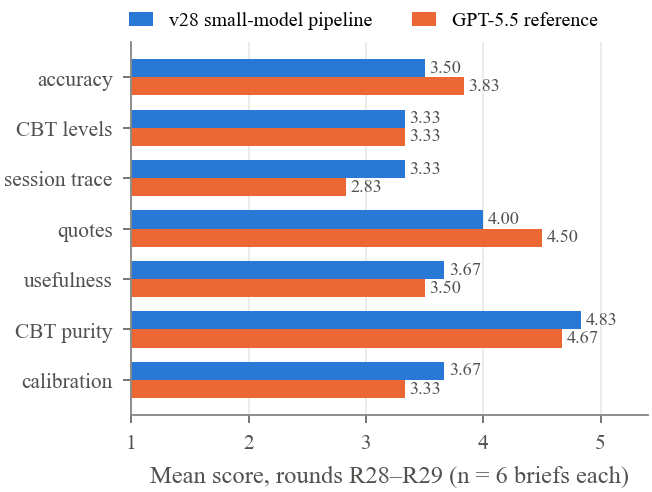
საბოლოო რაუნდებში საუკეთესო პატარა-მოდელის ვერსიამ და საცნობარო მოდელმა, შესაბამისად, 3.77 vs 3.87 ქულა მიიღეს (R28) და 3.77 vs 3.57 (R29). იმავე რაუნდის ექვს წყვილში სხვაობები იყო −0.4, +0.2, −0.1, −0.5, +0.9, +0.2: საშუალო +0.05, SD 0.49. ვერც ერთმა სისტემამ ვერ მიაღწია ზედამხედველის სამიზნე, 4.0 საშუალო ქულას. ცალკეული კრიტერიუმების მიხედვით v28-ს უკეთესი შედეგი ჰქონდა სესიების კვალდაკვალ მიყოლისა და კალიბრაციის მხრივ; ჩამორჩებოდა სიზუსტით (gold საცნობარო ტექსტთან თანხვედრით) და ციტატებით; CBT-ის დონეების მხრივ კი თანაბარი იყო.
ღირებულება
ერთი v28 ბრიფის ღირებულება სექციების დაწერისთვის დაახლოებით USD 0.03-ია და ამას 2.5–3 წუთი სჭირდება; best-of-3 ბრიფისას — დაახლოებით USD 0.11. ახალი სესიის დამუშავება დაახლოებით USD 0.07-ს ამატებს, უმეტესად კლასიფიკატორის მიერ ყველა წინადადების დამუშავების გამო. საჯარო ფასებით, მოწინავე მოდელის საცნობარო ბრიფი ერთ v28 ბრიფზე დაახლოებით 19-ჯერ ძვირია. მთელი პროექტის განმავლობაში პატარა მოდელის ტოკენებზე USD 5.57 დაიხარჯა.
რამ იმუშავა და რამ — არა
სამმა ფაქტორმა გააუმჯობესა შედეგი: ზედამხედველის მიერ აღმოჩენილი დეტერმინისტულ კოდში არსებული ხარვეზების გამოსწორებამ; სექციების დამწერებისთვის მაღალი მსჯელობის ინტენსივობის პარამეტრის გამოყენებამ (უმაღლესი პარამეტრი უფრო ძვირი იყო და დაბალი ქულა მიიღო); და დღევანდელი სესიისთვის შეთავაზებული დღის წესრიგის, პროგნოზების ზოლისა და რისკთან დაკავშირებული უახლესი განცხადების კოდში გადატანამ. რამდენიმე დამაჯერებელმა დამატებამ შედეგი გააუარესა: სამი მონახაზის გაერთიანებამ, კოდით დაწესებულმა რწმენის დროითმა ხაზმა, დაფარვის გამოსასწორებელი ეტაპით დამატებულმა მნიშვნელობის მინიშნებებმა და რუბრიკით მართულმა თვითრედაქტირებამ. თითოეულმა მათგანმა დაამატა გენერირების ეტაპი, რომელზეც პატარა მოდელს შეეძლო ინფორმაციის დაკარგვა ან დამახინჯება. ყოველი ცვლილება, რომელმაც მოდელის სამუშაო შეამცირა ან ტექსტის ხელახლა დაწერის გარეშე შეარჩია შედეგებს შორის, უსაფრთხო აღმოჩნდა.
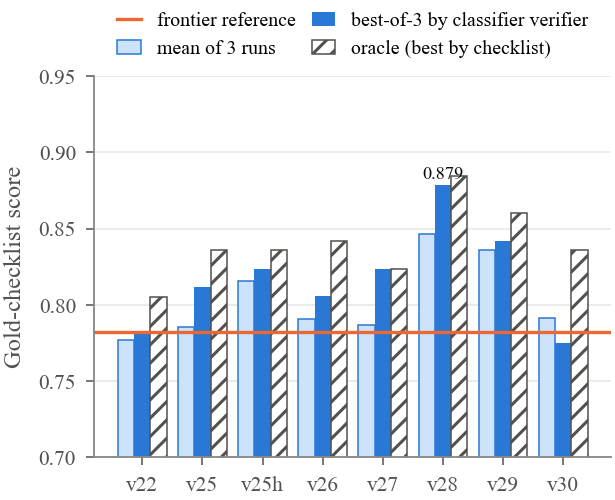
ვერიფიკატორის შერჩევამ რვა ვერსიიდან შვიდის საკონტროლო სიის ქულა გააუმჯობესა; v28-ის შემთხვევაში 0.846-დან 0.879-მდე, რაც ორაკულის ქულასთან (0.885) ახლოსაა. რადგან ვერიფიკატორი და საკონტროლო სიის შემფასებელი ერთი და იგივე კლასიფიკატორია, ამ გაუმჯობესების ნაწილი შესაძლოა მათ საერთო პრეფერენციებს ასახავდეს.
რა დარჩა რთულად
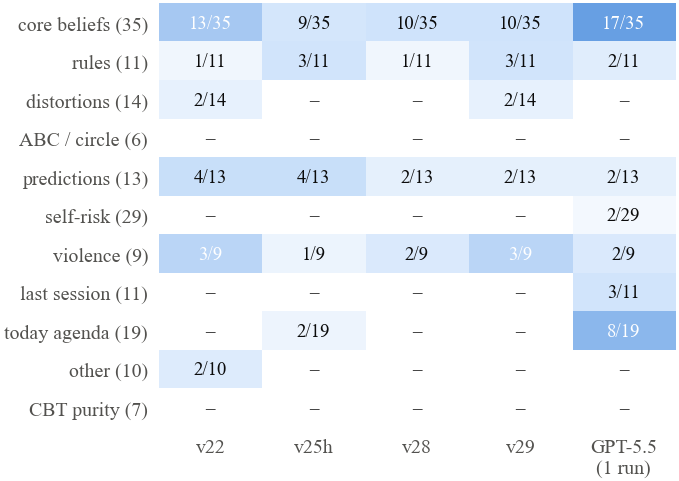
მდგრადი ხარვეზების წონა v22-სა და v28-ს შორის 164 წონითი ერთეულიდან 25-დან 15-მდე შემცირდა. დარჩენილია კოგნიტური მოდელის ყველაზე ფაქიზი შეფასებები: რწმენის მდგომარეობა მისი ხელახლა გააქტიურების შემდეგ, რწმენის დიაპაზონები, რომლებიც უახლეს მასალამდე არ მიდის, და მოქმედების ფარგლების დაზუსტებები. რისკის შესახებ სტრიქონები ყველაზე რთული კომპონენტი იყო: ჯარიმდებოდა როგორც უახლესი განცხადების გამოტოვება, ისე მეტაფორის, სავარჯიშოს ან ემოციის შეფასების სიგნალად ქცევა. საუკეთესო დიზაინში შენარჩუნდა მხოლოდ უახლესი სიტყვასიტყვითი განცხადება და სესია, როდესაც თერაპევტმა ამის შესახებ ბოლოს პირდაპირ იკითხა; ყველა ინტერპრეტაცია კი თერაპევტს დარჩა.
მსაჯი ექსპერიმენტის ნაწილია
რადგან საცნობარო ბრიფი არასდროს შეცვლილა, მისი ქულები მხოლოდ ზედამხედველის მუშაობას ასახავს.
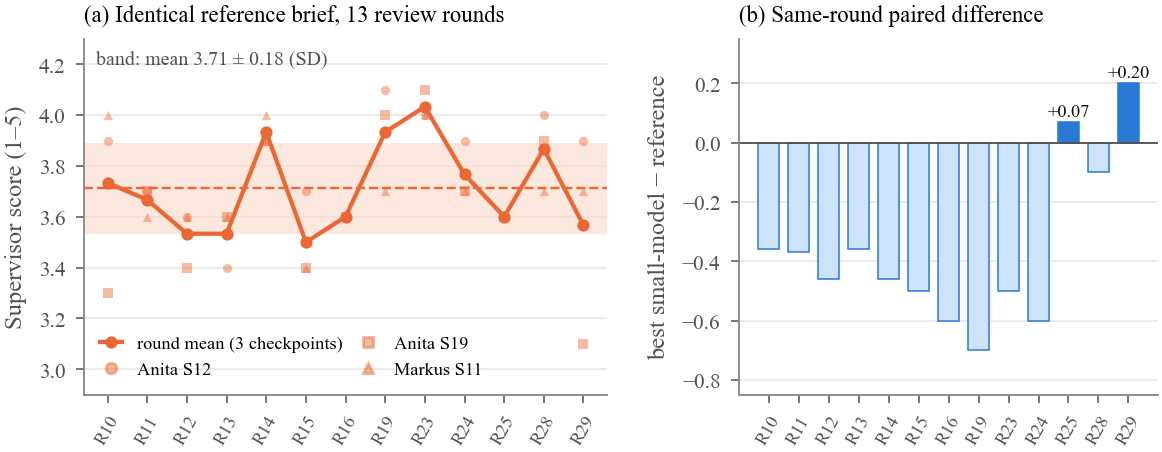
13 რაუნდის განმავლობაში იდენტურმა საცნობარო ბრიფმა მიიღო რაუნდების საშუალო ქულა 3.71, SD 0.18 და ქულების დიაპაზონი 3.50–4.03 1–5 შკალაზე. ცალკეული კრიტერიუმების SD 0.46-საც აღწევდა; მათ შორის იყო ციტატების შეფასებაც, რომლებიც სკრიპტით მოწმდებოდა და ყოველ ჯერზე იდენტური იყო. ეს ცვალებადობა იმავე შკალაზე ციკლის მიერ მიღწეული მთლიანი გაუმჯობესების ზომისაა.
რას არ აჩვენებს ეს კვლევა
- მხოლოდ სინთეზური მონაცემები. ორი სინთეზური პაციენტი, სამი საკონტროლო წერტილი, თითო ვერსიის სამი გაშვება. მხოლოდ აღწერითი სტატისტიკა, მნიშვნელოვნების ტესტების გარეშე. სხვა ამოცანებსა და რეალურ მასალაზე შედეგების გადატანის შესაძლებლობა არგუმენტირებულია, მაგრამ ნაჩვენები არ არის.
- მხოლოდ მოდელებზე დაფუძნებული შეფასება. დიზაინის მიხედვით, არც კლინიკოსები და არც სხვა ადამიანური შემფასებლები არ მონაწილეობდნენ. ქულები აღწერს gold checklist-თან თანხვედრასა და LLM ზედამხედველის შეფასებას და არა კლინიკურ ხარისხს, უსაფრთხოებას ან თერაპიაზე რაიმე ზემოქმედებას.
- შეფასების მონაცემებზე მორგებული. ყველა ვერსია იმავე საკონტროლო წერტილებისა და მსაჯების მიხედვით შეიქმნა, ამიტომ საბოლოო ქულები ოპტიმისტურია. სათანადო გამოცდა იქნებოდა გამოყოფილ პაციენტზე ტესტირება.
- გარჩევის შეუძლებლობა უპირატესობას არ ნიშნავს. ბრმა მიმოხილვისას ამ ზომის შერჩევაში პატარა მოდელისა და მოწინავე საცნობარო მოდელის გარჩევა შეუძლებელი იყო; სხვაობები მსაჯის საკუთარი ცვალებადობის ფარგლებშია.
- საერთო კლასიფიკატორი. საკონტროლო სიის შემფასებელი, წინადადებების სკანერი და ვერიფიკატორი ერთი და იგივე მოდელია.
- ზომიერი საცნობარო მაჩვენებელი. მოწინავე საცნობარო მაჩვენებელი GPT-5.5-ით ერთხელ გაშვებული ადრინდელი, არაოპტიმიზებული პაიპლაინის შედეგია და არა იმავე ციკლით მორგებული მოწინავე პაიპლაინისა.
წაიკითხეთ ნაშრომი, გადაამოწმეთ რიცხვები
სრული ნაშრომის ჩამოტვირთვა უფასოა. მონაცემთა პაკეტი საკონტროლო სიებით, ქულებითა და ბრიფების მაგალითებით ელფოსტით მიიღება.
ნაშრომი
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. წინასწარი პუბლიკაცია, 13 გვერდი, 9 ფიგურა.
ჩამოტვირთეთ მონაცემთა პაკეტი
ნაშრომის PDF, ცხრავე ფიგურა, სამი gold checklist, თითოეული ვერსიის საკონტროლო სიისა და ვერიფიკატორის ქულები, საბოლოო რაუნდების ბრმა მიმოხილვები ასოების შესაბამისობის გასაღებებთან ერთად და საბოლოო სამი სანიმუშო ბრიფი. README თითოეულ ველს განმარტავს.
მისამართებს არავის ვუზიარებთ. მონაცემების ბმული რამდენიმე წუთში მოვა.
რა შედის ZIP ფაილში
paper/: ნაშრომი PDF ფორმატშიfigures/: ცხრა ფიგურა და მათ საფუძვლად არსებული რიცხვებიscores/gold_checklists.json: 3 × 25 შეწონილი დებულებაscores/checklist_results.json: 198 შეფასებული ბრიფის თითოეული პუნქტის ალბათობებიscores/blind_review_R28.json,R29: შვიდი კრიტერიუმი, შეფასებები და შენიშვნები, ასოების შესაბამისობის გასაღებებითexample-briefs/: სამი საბოლოო v28 ბრიფი (პოლონურად, ტრანსკრიპტების მსგავსად)
არ შედის: სინთეზური ტრანსკრიპტები, პრომპტები და კოდი. კვლევითი გამოყენებისთვის მათი მიღება ავტორებისგან მოთხოვნით შეიძლება.
ციტირების წესი
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}