
Model i vogël, pipeline e kujdesshme
Një metodë autoresearch për të ngushtuar hendekun me LLM-të frontier në përmbledhjen e gjatë të disa dokumenteve. U testua në përmbledhje përgatitore para seancës, të krijuara nga transkriptet e dy pacientëve sintetikë.
Një model i lirë mund të afrohet, nëse i kërkohet të bëjë më pak
Modelet gjuhësore frontier përmbledhin mirë materiale të gjata me shumë dokumente, por përdorimi i njërit para çdo rezultati kushton shumë. Modelet e vogla janë të lira, por humbasin informacion në hyrje të gjata. Pyetëm se deri ku mund të arrijë një model me kosto të ulët kur vendoset brenda një pipeline-i të projektuar me kujdes dhe përmirësohet nga një cikël i automatizuar që vlerëson çdo ndryshim me modele të tjera, pa vlerësues njerëzorë.
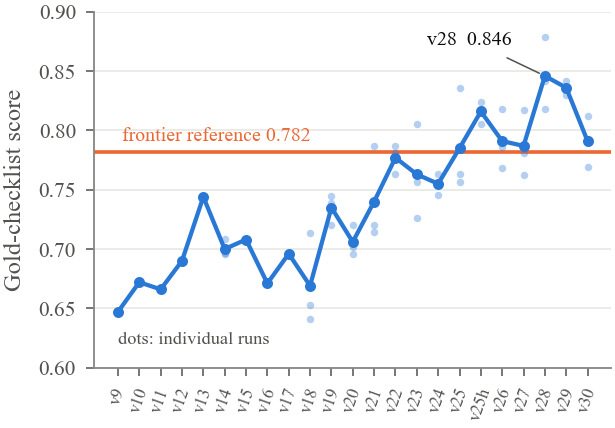
Përgjatë 30 versioneve dhe 16 raundeve të rishikimit të verbër, modeli i vogël u rrit nga 0,647 në 0,846 në një listë të ponderuar të artë kontrolli (0,879 kur një verifikues pa referencë zgjedh më të mirin nga tri ekzekutime). Referenca frontier mori 0,782. Në rishikimin e verbër nga një mbikëqyrës LLM, të dyja nuk mund të dalloheshin në këtë madhësi kampioni: diferenca mesatare e çiftuar ishte +0,05 (SD 0,49). E njëjta përmbledhje referuese, e pandryshuar, mori vlerësime nga 3,50 deri në 4,03 nga ai mbikëqyrës përgjatë 13 raundeve, kështu që zhurma e vetë vlerësuesit doli të ishte një gjetje më vete.
Përmbajtja
Hyrje e gjatë, strukturë fikse, përdorim rutinë
Shumë detyra praktike të përmbledhjes kanë tri veçori të përbashkëta: hyrja është e gjatë dhe shtrihet në shumë dokumente, rezultati ndjek një strukturë fikse me numërime, data dhe prova të cituara fjalë për fjalë, dhe rezultati prodhohet rregullisht, prandaj kostoja ka rëndësi.
Si mjedis testimi përdorëm një detyrë të tillë: një përmbledhje të strukturuar që një terapist CBT mund ta lexojë për rreth tre minuta para një seance. Ajo rendit besimet bazë me numrin e seancave, rregullat, shtrembërimet e përsëritura, episodet tipike ABC, parashikimet e testuara, seancën e fundit dhe pikat që terapisti mund të dëshirojë të trajtojë në seancën e sotme. Deri në seancën 20, materiali arrin rreth 130 000 fjalë.
Detyra i përshtatet një pyetjeje metodologjike, sepse ka një strukturë të njohur (modeli kognitiv i Beck-ut), një nocion natyror të provave të verifikueshme (fjalët e pacientit të cituara fjalë për fjalë) dhe disa kurthe: një besim i formuluar fillimisht nga terapisti, ose një metaforë që nuk është pohim për vdekjen.
Dy pacientë sintetikë
Të dy pacientët u gjeneruan me metodën tonë të shtresuar për pacientë sintetikë (fillimisht fleta e profilit, trajektorja terapeutike, plani i seancave dhe udhëzuesi i zërit, pastaj seancat e gjeneruara një nga një si transkripte në stilin ASR). Anita: 20 seanca, 131 498 fjalë, CBT në stilin e J. Beck-ut. Markus: 12 seanca, 83 978 fjalë, me një terapist që punon pjesërisht me terapinë e skemave, ndaj përmbledhja duhet ta përkthejë materialin përsëri në terma CBT. Për secilin pacient, një referencë e artë u shkrua në mënyrë të pavarur, pas leximit të plotë të transkripteve. Nuk u përdorën të dhëna të pacientëve realë.
Ndarja e punës
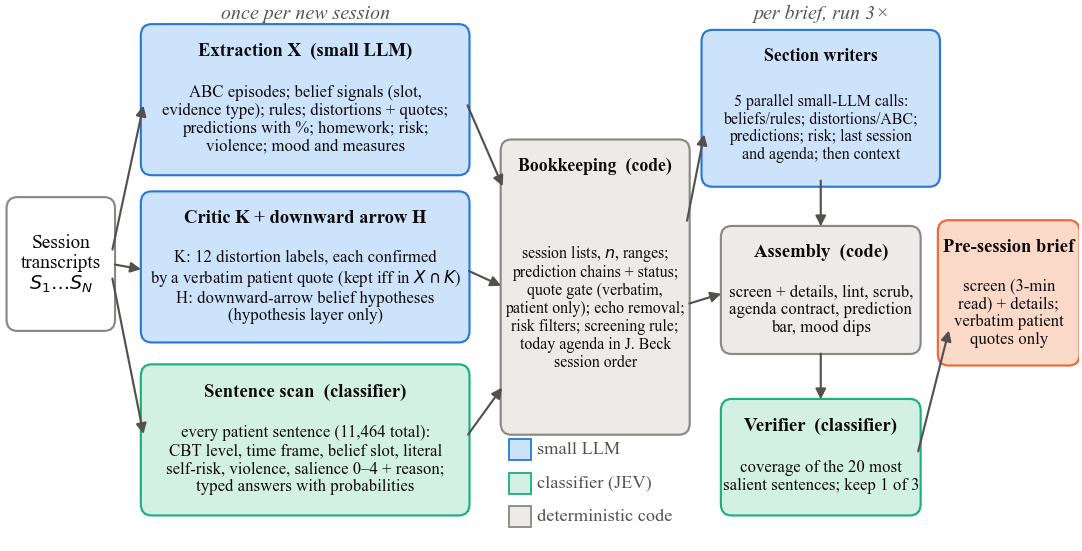
Ndryshimet vendimtare nuk ishin promptet më të mira, por rishpërndarja e përgjegjësive. Çdo komponent bën vetëm atë që di të bëjë mirë.
Kodi determinist
Gjithçka që mund të numërohet, renditet ose kontrollohet
Listat e seancave, numërimet dhe intervalet për secilin besim; zinxhirët e parashikimeve të lidhur ndërmjet seancave; një filtër për citimet fjalë për fjalë, që heq çdo citim që nuk gjendet në rreshtat e vetë pacientit; heqja e jehonave të terapistit; dhe, nga versioni 28, renditja e pikave të sugjeruara për seancën e sotme. Pasi zbulohet një defekt në këtë kod, ai rregullohet dhe mbetet i rregulluar.
Një klasifikues fjalish
Gjykime që nuk kërkojnë gjenerim teksti
Çdo fjali e pacientit (11 464 gjithsej) etiketohet një herë: niveli CBT (mendim automatik, rregull, besim, emocion, sjellje…), korniza kohore (tani ose e kujtuar), formulimi literal apo figurativ dhe sa e rëndësishme mund të jetë fjalia për seancën e ardhshme, secila me një probabilitet. I njëjti klasifikues më vonë shërben si verifikues pa referencë dhe si vlerësues i listës së kontrollit.
Një model i vogël gjuhësor
Shkrim i shkurtër nga materiali i përgatitur
Për çdo seancë, modeli i vogël nxjerr strukturën, konfirmon shtrembërimet me citime fjalë për fjalë dhe propozon hipoteza (të ruajtura si hipoteza, kurrë si prova). Për çdo përmbledhje, pesë shkrues seksionesh punojnë paralelisht; secili sheh vetëm të dhënat me numra seancash për seksionin e vet dhe udhëzohet të mos shpikë kurrë numra seancash apo citime.
Më e mira nga tri, pa parë përgjigjen
Dallimet nga një ekzekutim te tjetri brenda të njëjtit version shpesh ishin më të mëdha se dallimet ndërmjet versioneve. Prandaj pipeline-i në nivelin e përmbledhjes ekzekutohet tri herë dhe një verifikues zgjedh njërën: ai merr 20 fjalitë më të rëndësishme të pacientit dhe pyet klasifikuesin nëse secila pasqyrohet në përmbledhje. Verifikuesi nuk sheh kurrë referencën e artë apo listën e kontrollit.
Cikli autoresearch
Një cikël i automatizuar zhvillimi, në frymën e punimeve të fundit mbi eksperimentimin e automatizuar: propozo një ndryshim, provoje dhe mbaje vetëm nëse përputhen dy metrika të pavarura.
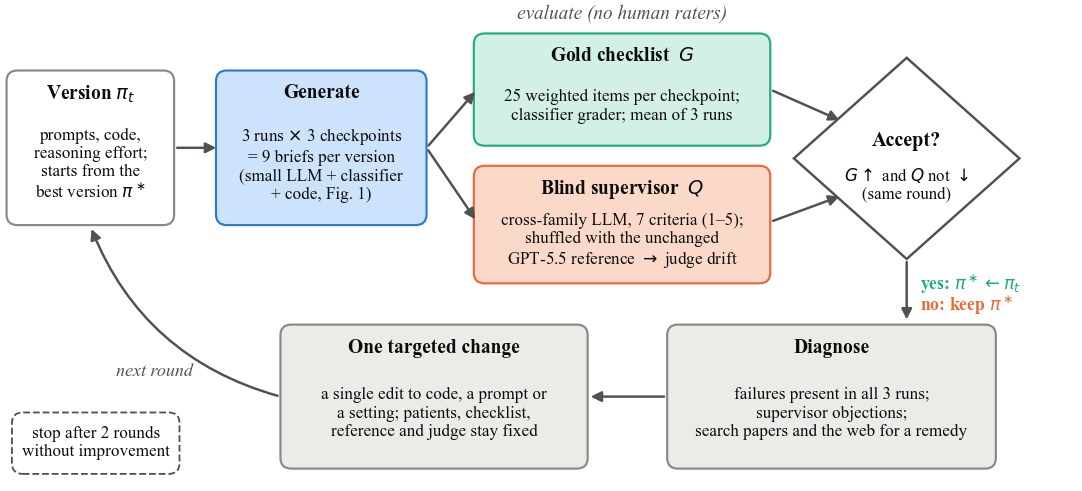
- Dy metrika. Një listë e artë kontrolli me 25 pohime të ponderuara për çdo pikë kontrolli, e vlerësuar nga klasifikuesi, dhe një rishikim i verbër nga një mbikëqyrës LLM i një familjeje tjetër modelesh, që vlerëson shtatë kritere në shkallën 1–5.
- Një pikë referimi fikse. Mbikëqyrësi sheh gjithmonë edhe një përmbledhje referuese frontier të pandryshuar, nën një shkronjë të rastësishme, që luhatja e vetë vlerësuesit të matet në çdo raund.
- Një ndryshim çdo herë. Dështimet e pranishme në të tria ekzekutimet dhe kundërshtimet e mbikëqyrësit nxisin një ndryshim të synuar për çdo raund, të mbështetur nga kërkimi në literaturë.
- Rregull fiks për ndalimin. Dy raunde radhazi pa përmirësim e përfundojnë ciklin. Ai u ndal te v28.
- Tavan fiks i kostos. Brenda pipeline-it nuk mund të përdoret asnjë model më i shtrenjtë se modeli i vogël ose klasifikuesi.
Çfarë vëzhguam
Statistika përshkruese në tri pika kontrolli (Anita para seancave 13 dhe 20, Markus para seancës 12) dhe tri ekzekutime për version.
Mbulimi i përmbajtjes: lista e artë e kontrollit
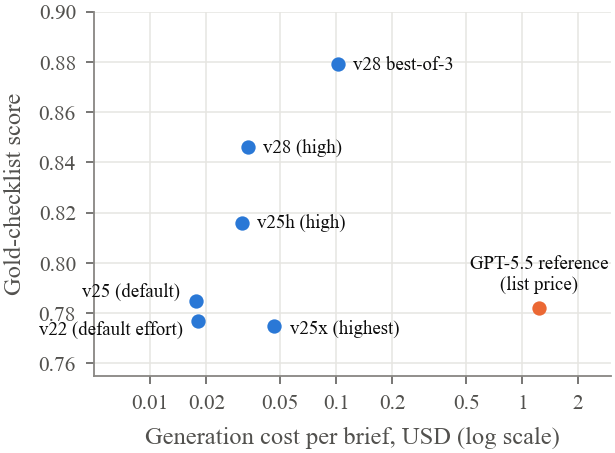
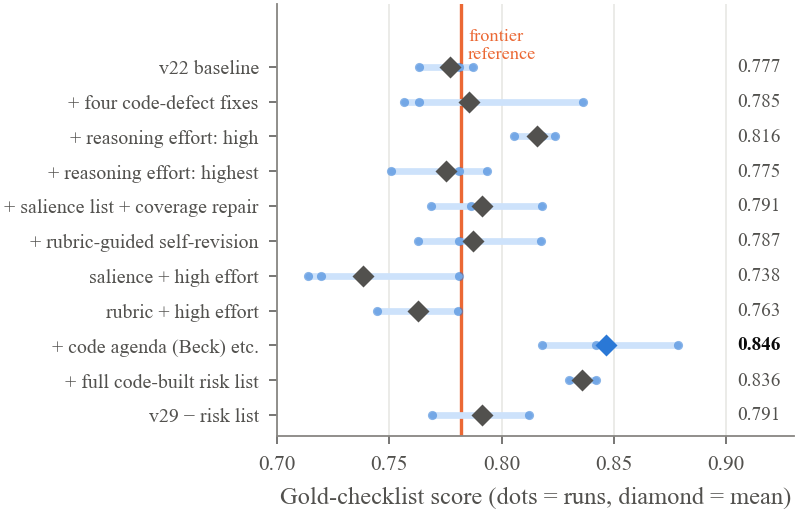
Modeli i vogël e nisi dukshëm pas referencës (0,647 kundrejt 0,782), e kaloi në v25 dhe arriti 0,846 në v28. Të tri ekzekutimet e v28 (0,818, 0,842, 0,879) janë mbi referencën. Dy versione të mëvonshme nuk e përmirësuan v28 dhe cikli u ndal.
| Anita, para S13 | Anita, para S20 | Markus, para S12 | |
|---|---|---|---|
| v28, mesatarja e 3 ekzekutimeve | 0,963 | 0,800 | 0,776 |
| v28, best-of-3 (verifikuesi) | 0,963 | 0,836 | 0,836 |
| Referenca GPT-5.5 (1 ekzekutim) | 0,963 | 0,655 | 0,727 |
Mesataret në pikat e kontrollit: v28 0,846 · best-of-3 0,879 · referenca 0,782.
Rishikimi i verbër: brenda zhurmës së vlerësuesit
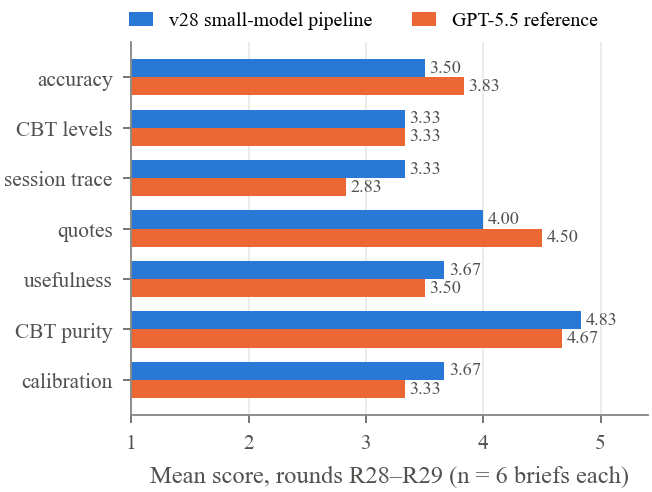
Në raundet përfundimtare, versioni më i mirë i modelit të vogël dhe referenca morën 3,77 kundrejt 3,87 (R28) dhe 3,77 kundrejt 3,57 (R29). Në gjashtë çifte të të njëjtit raund, diferencat ishin −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: mesatarja +0,05, SD 0,49. Asnjëri sistem nuk arriti mesataren e synuar 4,0 të mbikëqyrësit. Sipas kritereve, v28 ishte përpara për gjurmimin e seancave dhe kalibrimin, prapa për saktësinë (përputhjen me referencën e artë) dhe citimet, dhe në të njëjtin nivel për nivelet CBT.
Kostoja
Një përmbledhje v28 kushton rreth USD 0,03 për shkrimin e seksioneve dhe kërkon 2,5–3 minuta; një përmbledhje best-of-3 kushton rreth USD 0,11. Përpunimi i një seance të re shton rreth USD 0,07, kryesisht për kalimin e klasifikuesit mbi çdo fjali. Me çmimet e listës, përmbledhja referuese frontier kushton rreth 19 herë më shumë se një përmbledhje e vetme v28. I gjithë projekti përdori USD 5,57 në tokenë të modelit të vogël.
Çfarë ndihmoi dhe çfarë jo
Ndihmuan tri gjëra: rregullimi i defekteve në kodin determinist që zbuloi mbikëqyrësi, një nivel i lartë i përpjekjes arsyetuese për shkruesit e seksioneve (niveli më i lartë kushtoi më shumë dhe mori rezultat më të ulët), si dhe kalimi në kod i agjendës së sugjeruar, shiritit të parashikimeve dhe pohimit më të fundit të lidhur me rrezikun. Disa shtesa të besueshme patën efekt negativ: bashkimi i tri drafteve, një kronologji besimesh e imponuar nga kodi, sugjerimet për rëndësinë e informacionit me një kalim për riparimin e mbulimit dhe vetërishikimi i udhëhequr nga rubrika. Secila shtoi një hap gjenerimi ku një model i vogël mund të humbasë ose shtrembërojë informacion. Çdo ndryshim që ia hoqi punën modelit, ose përzgjodhi mes rezultateve pa i rishkruar ato, ishte i sigurt.
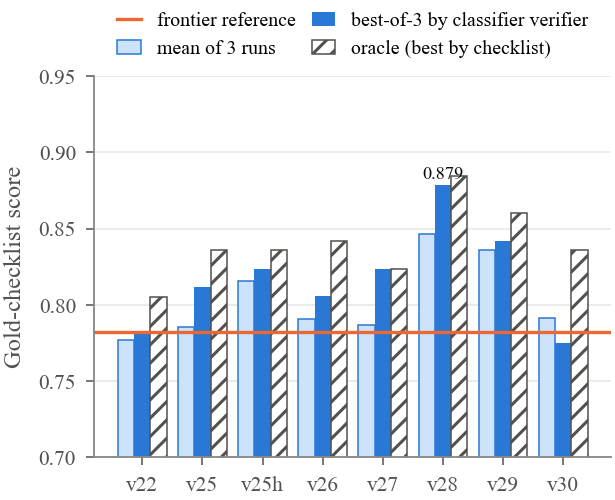
Përzgjedhja nga verifikuesi e përmirësoi rezultatin e listës së kontrollit për shtatë nga tetë versionet; për v28, nga 0,846 në 0,879, afër oracle-it (0,885). Meqë verifikuesi dhe vlerësuesi i listës së kontrollit janë i njëjti klasifikues, një pjesë e këtij përmirësimi mund të pasqyrojë preferenca të përbashkëta.
Çfarë mbeti e vështirë
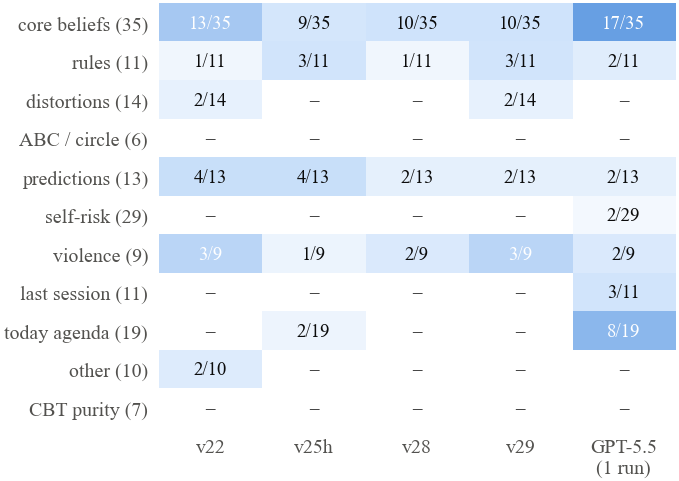
Dështimet e vazhdueshme ranë nga 25 në 15 njësi peshe nga 164 ndërmjet v22 dhe v28. Ajo që mbetet janë gjykimet më delikate të modelit kognitiv: gjendja e një besimi pasi riaktivizohet, intervalet e besimeve që ndalen para materialit më të fundit dhe kualifikimet e fushës së zbatimit. Rreshtat për rrezikun ishin pjesa më e vështirë: u penalizuan si mungesa e një pohimi të fundit, ashtu edhe shndërrimi i një metafore, ushtrimi apo vlerësimi të emocionit në sinjal. Dizajni më i mirë mbajti vetëm pohimin literal më të fundit dhe seancën kur terapisti e pyeti drejtpërdrejt për herë të fundit, duke ia lënë çdo interpretim terapistit.
Vlerësuesi është pjesë e eksperimentit
Meqë përmbledhja referuese nuk ndryshoi kurrë, rezultatet e saj matin vetëm mbikëqyrësin.
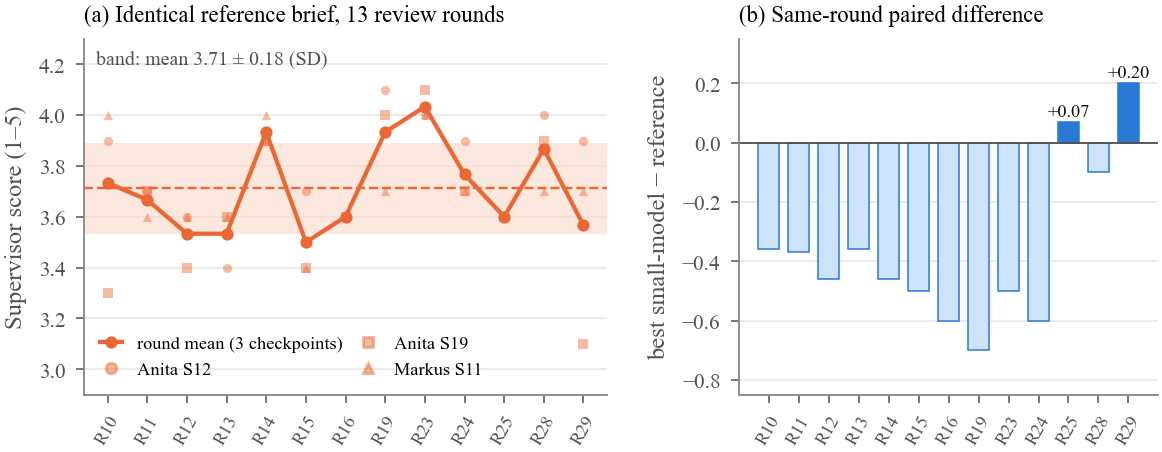
Përgjatë 13 raundeve, e njëjta përmbledhje referuese mori një mesatare raundi prej 3,71 me SD 0,18 dhe një interval prej 3,50–4,03 në shkallën 1–5. Për kriteret individuale, SD arriti 0,46, përfshirë citimet e verifikuara me skript që ishin identike çdo herë. Kjo zhurmë është afërsisht sa i gjithë përmirësimi që prodhoi cikli në të njëjtën shkallë.
Çfarë nuk tregon ky studim
- Vetëm të dhëna sintetike. Dy pacientë sintetikë, tri pika kontrolli, tri ekzekutime për version. Vetëm statistika përshkruese, pa teste domethënieje statistikore. Transferimi në detyra të tjera dhe në materiale reale argumentohen, por nuk demonstrohen.
- Vetëm vlerësim i bazuar në modele. Sipas dizajnit, nuk morën pjesë klinicistë apo vlerësues të tjerë njerëzorë. Rezultatet përshkruajnë përputhjen me një listë të artë kontrolli dhe gjykimin e një mbikëqyrësi LLM, jo cilësinë klinike, sigurinë apo ndonjë efekt në terapi.
- I përshtatur mbi grupin e vlerësimit. Të gjitha versionet u zhvilluan kundrejt të njëjtave pika kontrolli dhe vlerësues, ndaj rezultatet përfundimtare janë optimiste. Testi i duhur do të ishte një pacient i lënë mënjanë.
- I padallueshëm nuk do të thotë më i mirë. Në rishikimin e verbër, modeli i vogël dhe referenca frontier nuk mund të dalloheshin në këtë madhësi kampioni; diferencat janë brenda zhurmës së vetë vlerësuesit.
- Klasifikues i përbashkët. Vlerësuesi i listës së kontrollit, skanuesi i fjalive dhe verifikuesi janë i njëjti model.
- Referencë modeste. Referenca frontier është një ekzekutim i mëparshëm, i paoptimizuar, i pipeline-it me GPT-5.5, i kryer një herë; nuk është një pipeline frontier i përshtatur me të njëjtin cikël.
Lexoni punimin, kontrolloni shifrat
Punimi i plotë mund të shkarkohet falas. Paketa e të dhënave me listat e kontrollit, rezultatet dhe shembujt e përmbledhjeve dërgohet me email.
Punimi
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Parabotim, 13 faqe, 9 figura.
Shkarko paketën e të dhënave
PDF-ja e punimit, të nëntë figurat, tri listat e arta të kontrollit, rezultatet e listës së kontrollit dhe të verifikuesit për çdo version, rishikimet e verbra nga raundet përfundimtare me çelësat e tyre të shkronjave dhe tri përmbledhje përfundimtare shembull. Një README shpjegon çdo fushë.
Nuk i ndajmë adresat. Lidhja e të dhënave mbërrin brenda pak minutash.
Çfarë përmban ZIP-i
paper/: punimi në format PDFfigures/: nëntë figura dhe të dhënat numerike pas tyrescores/gold_checklists.json: 3 × 25 pohime të ponderuarascores/checklist_results.json: probabilitetet për çdo element për 198 përmbledhje të vlerësuarascores/blind_review_R28.json,R29: shtatë kritere, vlerësime dhe kundërshtime, me çelësat e shkronjaveexample-briefs/: tri përmbledhje përfundimtare v28 (në polonisht, si transkriptet)
Nuk përfshihen: transkriptet sintetike, promptet dhe kodi. Ato mund të kërkohen nga autorët për përdorim kërkimor.
Si të citoni
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}