
Мала модель, ретельно спроєктований конвеєр
Метод авторесерчу для скорочення розриву з передовими великими мовними моделями в узагальненні довгих документів із багатьох джерел. Перевірено на підсумках перед сеансами, складених на основі транскриптів двох синтетичних пацієнтів.
Недорога модель може наблизитися до передової, якщо робитиме менше
Передові мовні моделі добре узагальнюють довгі матеріали з багатьох документів, але запуск такої моделі перед кожним результатом обходиться дорого. Малі моделі дешеві, проте втрачають інформацію на довгих входах. Ми дослідили, як далеко може просунутися недорога модель, якщо помістити її в ретельно спроєктований конвеєр і вдосконалювати автоматизованим циклом, який оцінює кожну зміну за допомогою інших моделей, без людських оцінювачів.
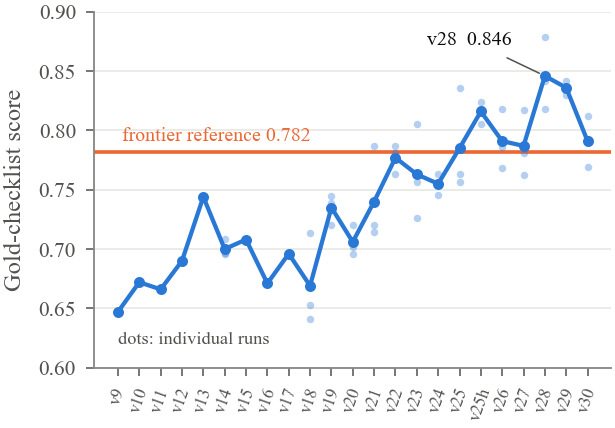
За понад 30 версій і 16 раундів сліпого оцінювання мала модель підвищила результат із 0,647 до 0,846 за зваженою золотою контрольною добіркою (0,879, якщо верифікатор без еталона обирає найкращий із трьох запусків). Передова модель-орієнтир набрала 0,782. У сліпому оцінюванні супервізором на основі LLM за такого розміру вибірки відмінності між ними виявити не вдалося: середня парна різниця становила +0,05 (SD 0,49). Той самий, незмінений еталонний підсумок отримував від цього супервізора оцінки від 3,50 до 4,03 упродовж 13 раундів, тож власний шум судді виявився окремим результатом дослідження.
Зміст
Довгий вхід, фіксована структура, регулярне використання
Багатьом практичним завданням з узагальнення притаманні три властивості: вхідні дані довгі й розподілені між багатьма документами; результат має фіксовану структуру з підрахунками, датами й дослівними свідченнями; результат створюється регулярно, тож вартість має значення.
Як тестове завдання ми використали одне з таких завдань: структурований підсумок, який терапевт КПТ може прочитати приблизно за три хвилини перед сеансом. У ньому перелічено ключові переконання з кількістю сеансів, правила, повторювані викривлення, типові епізоди ABC, перевірені прогнози, попередній сеанс і теми, які терапевт може захотіти обговорити сьогодні. До 20-го сеансу обсяг матеріалу становить близько 130 000 слів.
Це завдання підходить для методологічного дослідження, оскільки має відому структуру (когнітивна модель Бека), природне поняття перевірного свідчення (дослівні слова пацієнта) і кілька пасток: переконання, яке спершу сформулював терапевт, або метафора, що не є висловлюванням про смерть.
Два синтетичні пацієнти
Обох пацієнтів згенеровано за допомогою нашого багаторівневого методу створення синтетичних пацієнтів (спочатку профіль, терапевтична траєкторія, план сеансів і настанови щодо мовлення, а потім сеанси, згенеровані по одному у вигляді транскриптів у стилі ASR). Anita: 20 сеансів, 131 498 слів, КПТ у стилі Дж. Бека. Markus: 12 сеансів, 83 978 слів; терапевт частково працює в межах схематерапії, тому матеріал у підсумку потрібно перекласти на терміни КПТ. Для кожного пацієнта еталонний підсумок було незалежно підготовлено на основі повного прочитання транскриптів. Реальних даних пацієнтів не використовували.
Розподіл завдань
Вирішальними були не кращі промпти, а перерозподіл відповідальності. Кожен компонент виконує лише те, на що здатен найкраще.
Детермінований код
Усе, що можна підрахувати, упорядкувати або перевірити
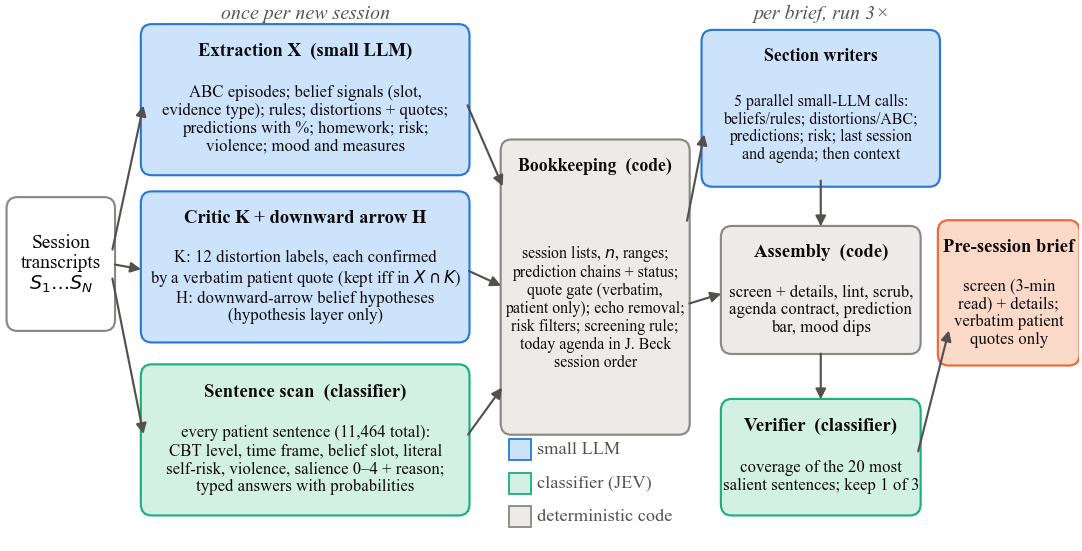
Переліки сеансів, підрахунки й діапазони для кожного переконання; ланцюжки прогнозів, пов’язані між сеансами; фільтр дослівних цитат, який відкидає цитати, не знайдені у власних репліках пацієнта; вилучення повторів за терапевтом; а починаючи з версії 28 — порядок запропонованих тем для сьогоднішнього сеансу. Щойно в цьому коді виявляють дефект, його виправляють остаточно.
Класифікатор речень
Судження, для яких не потрібна генерація тексту
Кожне речення пацієнта (загалом 11 464) один раз позначається мітками: рівень КПТ (автоматична думка, правило, переконання, емоція, поведінка…), часовий проміжок (теперішнє чи згадане), буквальне чи образне формулювання, а також імовірна значущість речення для наступного сеансу; для кожного визначення вказується ймовірність. Той самий класифікатор згодом використовується як верифікатор без еталона та як оцінювач контрольної добірки.
Мала мовна модель
Стислий текст на основі підготовленого матеріалу
Для кожного сеансу мала модель виокремлює структуру, підтверджує викривлення дослівними цитатами й пропонує гіпотези (які зберігаються як гіпотези, а не свідчення). Для кожного підсумку паралельно працюють п’ять авторів розділів; кожен бачить лише дані з номерами сеансів для свого розділу й отримує вказівку ніколи не вигадувати номери сеансів або цитати.
Найкращий із трьох — без перегляду відповіді
Відмінності між запусками в межах однієї версії часто були більшими за відмінності між версіями. Тому конвеєр на рівні підсумку запускається тричі, а верифікатор обирає один результат: він бере 20 найважливіших речень пацієнта й просить класифікатор визначити, чи відображено кожне з них у підсумку. Верифікатор не бачить ані еталонного результату, ані контрольної добірки.
Цикл авторесерчу
Автоматизований цикл розробки в дусі нещодавніх робіт з автоматизованого експериментування: запропонувати одну зміну, перевірити її й залишити лише тоді, коли погоджуються два незалежні показники.
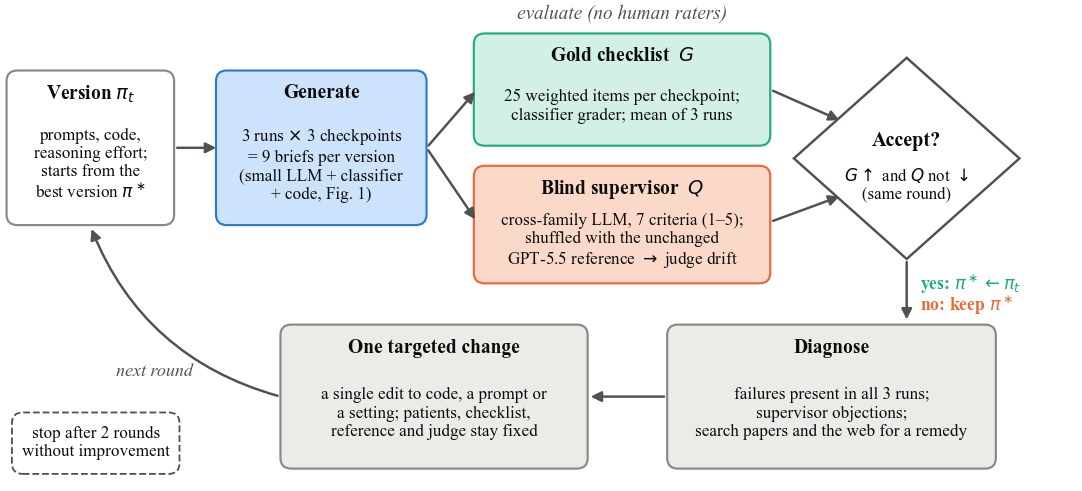
- Два показники. Золота контрольна добірка з 25 зважених тверджень для кожної контрольної точки, яку оцінює класифікатор, і сліпе оцінювання супервізором на основі LLM із іншого сімейства моделей за сімома критеріями за шкалою від 1 до 5.
- Фіксований еталон. Супервізор щоразу також бачить один незмінений еталонний підсумок передової моделі під випадковою літерою, тож власний дрейф судді вимірюється в кожному раунді.
- По одній зміні за раз. Помилки, наявні в усіх трьох запусках, і зауваження супервізора визначають одну цільову зміну за раунд; її розробляють з урахуванням пошуку в літературі.
- Фіксоване правило зупинки. Цикл завершується після двох послідовних раундів без покращення. Він зупинився на v28.
- Фіксована межа вартості. У конвеєрі не можна використовувати моделі, дорожчі за малу модель або класифікатор.
Що ми спостерігали
Описова статистика для трьох контрольних точок (Anita перед сеансами 13 і 20, Markus перед сеансом 12) і трьох запусків для кожної версії.
Повнота охоплення: золота контрольна добірка
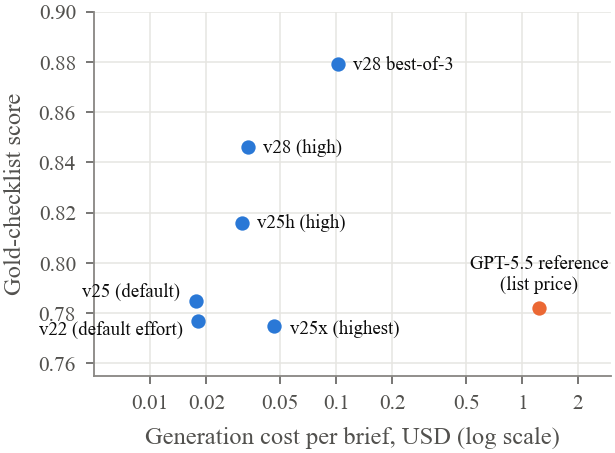
Мала модель починала значно нижче за еталон (0,647 проти 0,782), перевершила його на v25 і досягла 0,846 на v28. Усі три запуски v28 (0,818, 0,842, 0,879) перевищують еталон. Дві наступні версії не покращили результат v28, тож цикл зупинився.
| Anita, перед S13 | Anita, перед S20 | Markus, перед S12 | |
|---|---|---|---|
| v28, середнє за 3 запусками | 0,963 | 0,800 | 0,776 |
| v28, найкращий із 3 (верифікатор) | 0,963 | 0,836 | 0,836 |
| Еталон GPT-5.5 (1 запуск) | 0,963 | 0,655 | 0,727 |
Середнє за контрольними точками: v28 0,846 · найкращий із 3 0,879 · еталон 0,782.
Сліпе оцінювання: у межах шуму судді
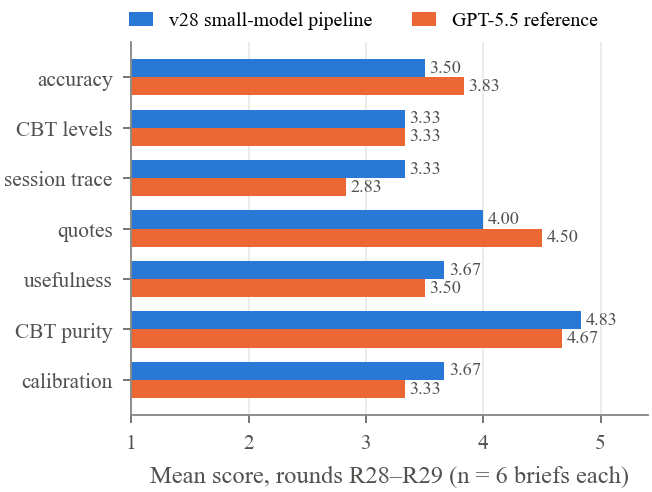
В останніх раундах найкраща версія малої моделі й еталон отримали оцінки 3,77 проти 3,87 (R28) і 3,77 проти 3,57 (R29). Для шести пар у межах одного раунду різниці становили −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: середнє +0,05, SD 0,49. Жодна система не досягла цільового середнього супервізора 4,0. За критеріями v28 випереджала еталон за послідовністю сеансів і калібруванням, поступалася за точністю (відповідністю еталонному результату) та цитатами й не відрізнялася за рівнями КПТ.
Вартість
Створення одного підсумку v28 коштує близько USD 0,03 на написання розділів і займає 2,5–3 хвилини; підсумок із вибором найкращого з 3 — близько USD 0,11. Обробка нового сеансу додає близько USD 0,07, здебільшого через обхід класифікатором кожного речення. За прейскурантними цінами еталонний підсумок передової моделі коштує приблизно в 19 разів дорожче за один підсумок v28. На весь проєкт витратили USD 5,57 на токени малої моделі.
Що допомогло, а що ні
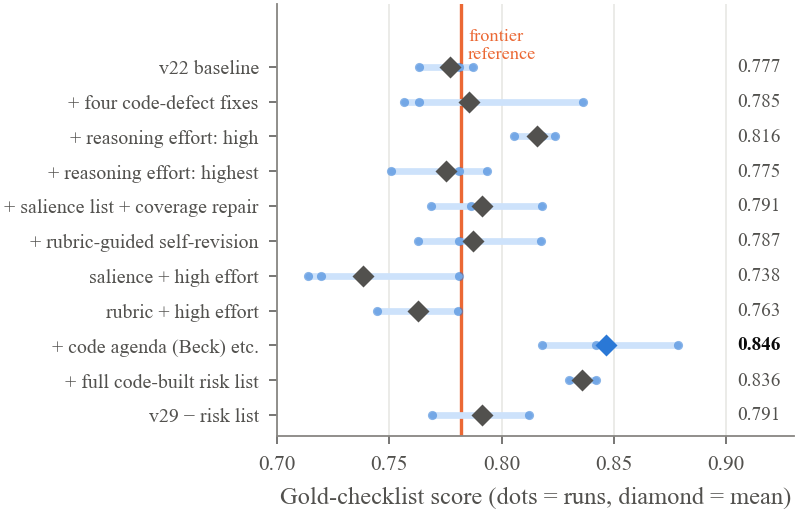
Допомогли три речі: виправлення дефектів у детермінованому коді, виявлених супервізором; високий рівень зусиль для міркування під час створення розділів (найвищий рівень коштував дорожче й давав нижчі оцінки); а також перенесення в код запропонованого порядку денного, шкали прогнозів і найновішого висловлювання, пов’язаного з ризиком. Кілька правдоподібних доповнень погіршили результат: об’єднання трьох чернеток, задана кодом часова шкала переконань, підказки щодо значущості з подальшим виправленням неповного охоплення та саморедагування за рубрикою. Кожне з них додавало крок генерації, на якому мала модель могла втратити або спотворити інформацію. Усі зміни, що зменшували обсяг роботи моделі або давали змогу вибирати між результатами без їх переписування, виявилися безпечними.
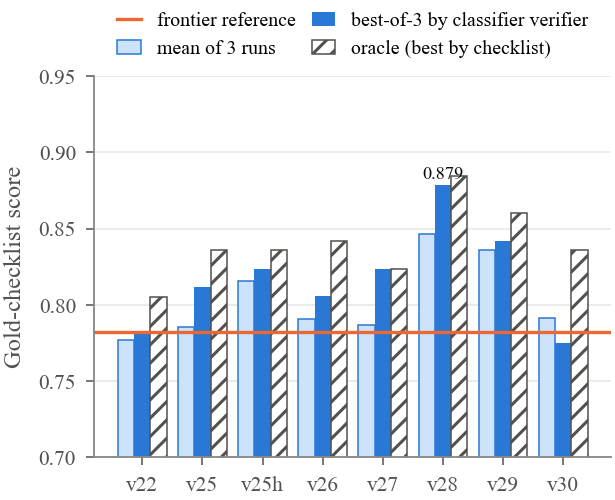
Вибір верифікатором підвищив оцінку за контрольною добіркою для семи з восьми версій; для v28 — з 0,846 до 0,879, близько до оракула (0,885). Оскільки верифікатор і оцінювач контрольної добірки — той самий класифікатор, частина цього приросту може відображати спільні уподобання.
Що залишилося складним
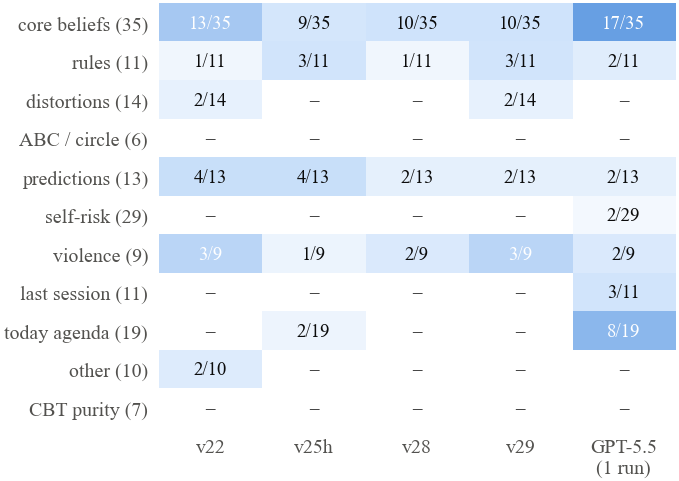
Кількість стійких помилок зменшилася з 25 до 15 зі 164 одиниць ваги між v22 і v28. Залишилися найтонші судження в межах когнітивної моделі: стан переконання після його повторної активації, діапазони переконань, що не охоплюють найновіший матеріал, і кваліфікації щодо сфери застосування. Найскладнішим компонентом були висловлювання про ризик: штрафувалися як пропуск недавнього висловлювання, так і перетворення метафори, вправи чи оцінки емоцій на сигнал ризику. Найкращий дизайн залишав лише найновіше буквальне висловлювання й сеанс, на якому терапевт востаннє запитував про нього безпосередньо, а всі інтерпретації залишав терапевту.
Суддя — частина експерименту
Оскільки еталонний підсумок ніколи не змінювався, його оцінки вимірюють лише роботу супервізора.
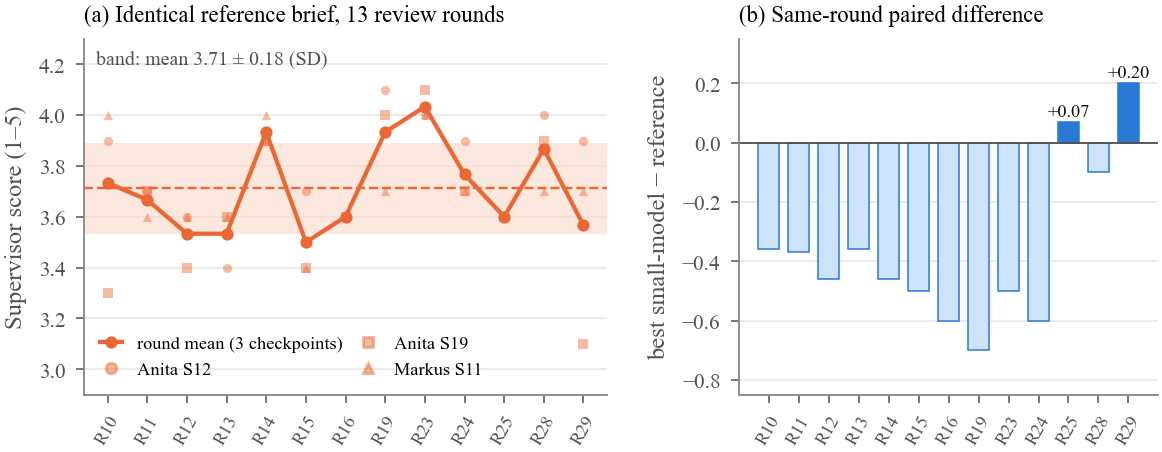
Упродовж 13 раундів той самий еталонний підсумок отримував середню оцінку за раунд 3,71 із SD 0,18 і діапазоном 3,50–4,03 за шкалою від 1 до 5. Для окремих критеріїв SD сягало 0,46, зокрема для цитат, перевірених скриптом і незмінних у кожному оцінюванні. Цей шум приблизно дорівнює всьому покращенню, якого досяг цикл за тією самою шкалою.
Чого це дослідження не показує
- Лише синтетичні дані. Два синтетичні пацієнти, три контрольні точки, три запуски для кожної версії. Лише описова статистика, без тестів значущості. Перенесення на інші завдання й реальні матеріали обґрунтовується, але не демонструється.
- Лише оцінювання моделями. За задумом у дослідженні не брали участі клініцисти чи інші люди-оцінювачі. Оцінки описують відповідність золотій контрольній добірці та судження супервізора на основі LLM, а не клінічну якість, безпеку чи будь-який вплив на терапію.
- Налаштування на наборі оцінювання. Усі версії розроблялися на тих самих контрольних точках і з тими самими суддями, тому фінальні оцінки є оптимістичними. Належною перевіркою був би відкладений пацієнт.
- Неможливість розрізнити — не означає переваги. Під час сліпого оцінювання за такого розміру вибірки малу модель і еталон передової моделі не вдалося розрізнити; відмінності лежать у межах власного шуму судді.
- Спільний класифікатор. Оцінювач контрольної добірки, аналізатор речень і верифікатор — одна й та сама модель.
- Помірний еталон. Еталон передової моделі — це один попередній, неоптимізований запуск конвеєра з GPT-5.5, а не конвеєр передової моделі, налаштований тим самим циклом.
Читайте статтю, перевіряйте числа
Повну статтю можна безплатно завантажити. Пакет даних із контрольними добірками, оцінками й прикладами підсумків надсилається електронною поштою.
Стаття
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Препринт, 13 сторінок, 9 рисунків.
Завантажити пакет даних
PDF статті, усі дев’ять рисунків, три золоті контрольні добірки, оцінки за контрольною добіркою й верифікатором для кожної версії, сліпі оцінки фінальних раундів із ключами літер і три приклади фінальних підсумків. У README пояснено кожне поле.
Ми не передаємо адреси третім особам. Посилання на дані надійде за кілька хвилин.
Що містить ZIP-архів
paper/: стаття у форматі PDFfigures/: дев’ять рисунків і вихідні дані для нихscores/gold_checklists.json: 3 × 25 зважених твердженьscores/checklist_results.json: імовірності для окремих пунктів у 198 оцінених підсумкахscores/blind_review_R28.json,R29: сім критеріїв, вердикти й зауваження з ключами літерexample-briefs/: три фінальні підсумки v28 (польською, як і транскрипти)
Не включено: синтетичні транскрипти, промпти й код. Їх можна запросити в авторів для дослідницького використання.
Як цитувати
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}