
Мали модел, пажљиво осмишљен процес
Метод аутоматизованог истраживања за смањење јаза у односу на водеће LLM-ове у сажимању дугих докумената и више докумената. Испитан на сажецима за припрему сесије, направљеним на основу транскрипата два синтетичка пацијента.
Јефтин модел може да се приближи, ако ради мање
Водећи језички модели добро сажимају дугачак материјал из више докумената, али њихова употреба пре сваког резултата постаје скупа. Мали модели су јефтини, али губе информације при обради дугачких улаза. Испитали смо докле може да стигне јефтин модел када се користи у пажљиво осмишљеном процесу и унапређује аутоматизованом петљом која сваку измену процењује помоћу других модела, без људских оцењивача.
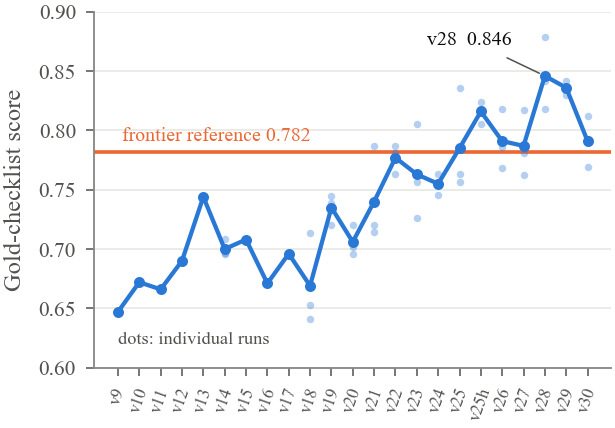
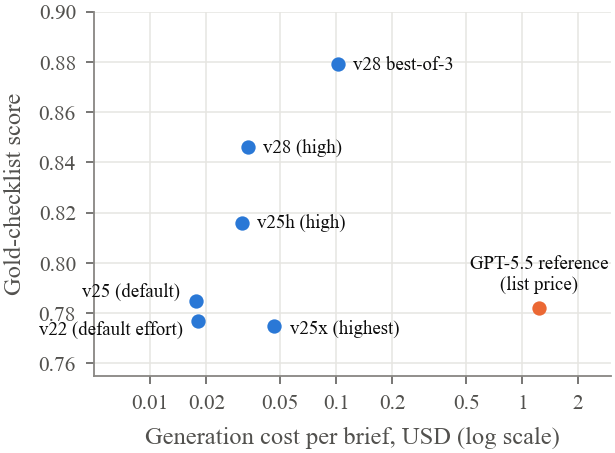
Током више од 30 верзија и 16 рунди слепог прегледа, резултат малог модела на пондерисаној контролној листи са златним стандардом порастао је са 0,647 на 0,846 (0,879 када верификатор без референтног одговора изабере најбољи од три излаза). Референтни водећи модел постигао је 0,782. У слепом прегледу који је обављао LLM супервизор, при овој величини узорка није било могуће разликовати та два модела: средња вредност упарене разлике била је +0,05 (SD 0,49). Исти, непромењени референтни сажетак добијао је оцене од 3,50 до 4,03 од тог супервизора током 13 рунди, па се испоставило да је шум у самом оцењивачу засебан налаз.
Садржај
Дугачак улаз, фиксна структура, редовна употреба
Многи практични задаци сажимања имају три заједничке особине: улаз је дугачак и распоређен кроз више докумената, излаз прати фиксну структуру са бројевима, датумима и дословним доказима, а излаз се производи редовно, па је трошак важан.
Као полигон за испитивање изабрали смо један такав задатак: структуриран сажетак који когнитивно-бихејвиорални терапеут може да прочита за око три минута пре сесије. У њему су наведена кључна уверења са бројем сесија, правила, понављајуће дисторзије, типичне ABC епизоде, испитана предвиђања, последња сесија и теме које би терапеут могао да покрене на данашњој сесији. До 20. сесије материјал има око 130.000 речи.
Овај задатак је погодан за испитивање методе зато што има познату структуру (Беков когнитивни модел), природан појам проверљивог доказа (дословне речи пацијента) и више замки: уверење које је првобитно формулисао терапеут или метафора која није исказ о смрти.
Два синтетичка пацијента
Оба пацијента су генерисана нашом слојевитом методом синтетичког пацијента (најпре профил, терапијски ток, план сесија и смернице за глас, а затим сесије генерисане једна по једна као ASR транскрипти). Anita: 20 сесија, 131.498 речи, КПТ у стилу Џ. Бека. Markus: 12 сесија, 83.978 речи, са терапеутом који делимично користи терапију усмерену на шеме, па сажетак мора да преведе материјал назад у КПТ термине. За сваког пацијента је независно написан референтни сажетак са златним стандардом, на основу целокупног читања транскрипата. Нису коришћени подаци стварних пацијената.
Подела рада
Одлучујуће измене нису биле бољи упити, већ другачија расподела одговорности. Свака компонента ради само оно у чему је добра.
Детерминистички код
Све што се може пребројати, поређати или проверити
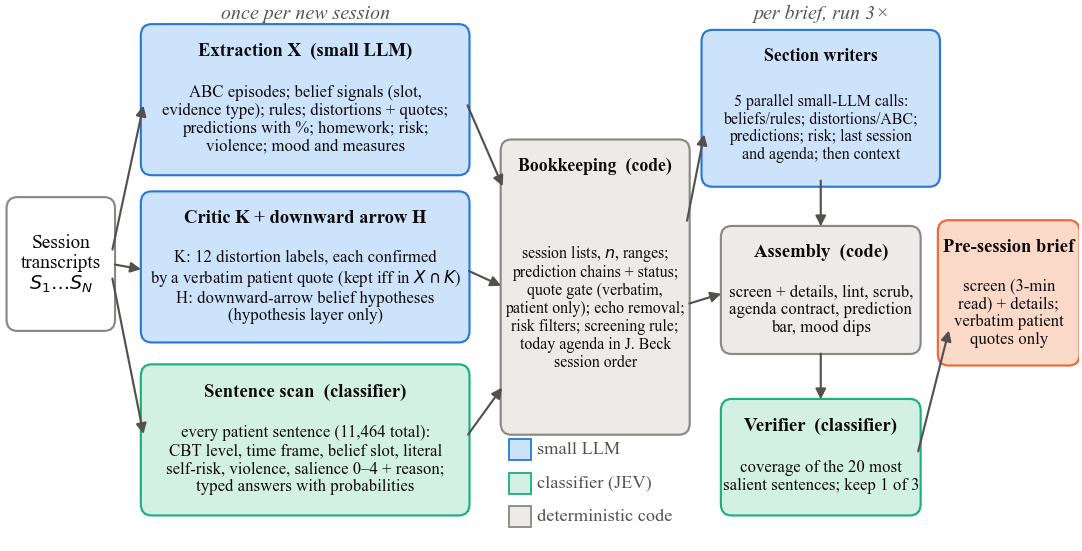
Спискови сесија, бројање и распони за свако уверење; ланци предвиђања повезани кроз сесије; филтер за дословне цитате који одбацује сваки цитат који се не налази у речима самог пацијента; уклањање понављања терапеутових речи; а од верзије 28 и редослед предложених тема за данашњу сесију. Када се открије недостатак у овом коду, он се исправља трајно.
Класификатор реченица
Просуђивања за која није потребно генерисање текста
Свакој реченици пацијента (укупно 11.464) додељују се ознаке једном: ниво КПТ-а (аутоматска мисао, правило, уверење, емоција, понашање…), временски оквир (садашњост или сећање), дословно или фигуративно значење и вероватна важност реченице за следећу сесију, свака са својом вероватноћом. Исти класификатор касније служи као верификатор без референтног одговора и као оцењивач контролне листе.
Мали језички модел
Кратко писање на основу припремљеног материјала
За сваку сесију мали модел издваја структуру, потврђује дисторзије дословним цитатима и предлаже хипотезе (чувају се као хипотезе, никада као докази). За сваки сажетак паралелно раде писци пет одељака, од којих сваки види само податке нумерисане по сесијама за свој одељак и добија упутство да никада не измишља бројеве сесија или цитате.
Најбољи од три, без увида у одговор
Разлике између покретања унутар исте верзије често су биле веће од разлика између верзија. Зато процес на нивоу сажетка покреће генерисање три пута, а верификатор бира један излаз: узима 20 најважнијих реченица пацијента и пита класификатор да ли се свака од њих огледа у сажетку. Верификатору се никада не приказују референтни одговор са златним стандардом ни контролна листа.
Аутоматизована истраживачка петља
Аутоматизована развојна петља у духу скорашњих радова о аутоматизовању експериментисања: предложи једну измену, испробај је и задржи само ако се две независне метрике слажу.
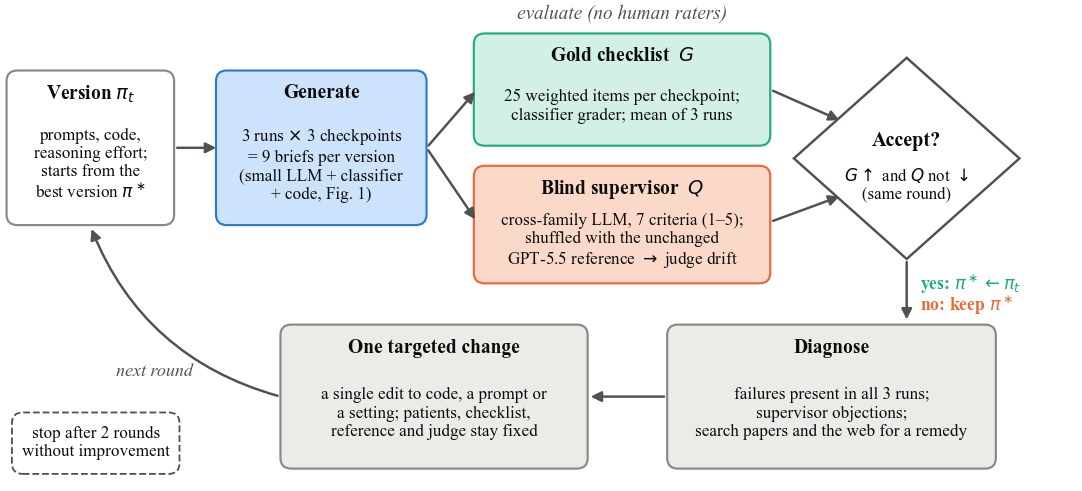
- Две метрике. Контролна листа са златним стандардом, која садржи 25 пондерисаних тврдњи по контролној тачки и коју оцењује класификатор, и слепи преглед LLM супервизора из друге породице модела, који оцењује седам критеријума на скали од 1 до 5.
- Фиксни оријентир. Супервизору се увек приказује и један непромењени референтни сажетак водећег модела, означен насумичним словом, тако да се одступање самог оцењивача мери у свакој рунди.
- Једна измена одједном. Неуспеси присутни у сва три покретања и примедбе супервизора усмеравају једну циљану измену по рунди, уз увид у претрагу литературе.
- Фиксно правило заустављања. Петља се завршава после две узастопне рунде без побољшања. Зауставила се на v28.
- Фиксна горња граница трошкова. Унутар процеса није дозвољена употреба модела скупљег од малог модела или класификатора.
Шта смо уочили
Дескриптивна статистика за три контролне тачке (Anita пре 13. и 20. сесије, Markus пре 12. сесије) и три покретања по верзији.
Покривеност садржаја: контролна листа са златним стандардом
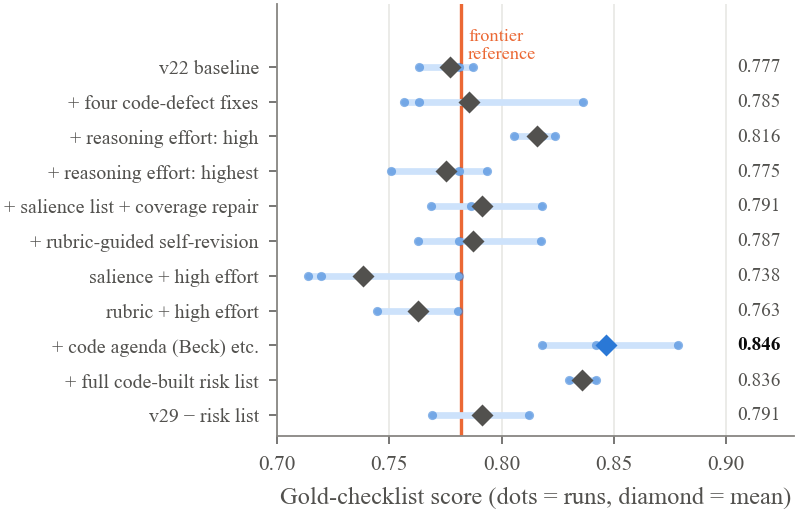
Мали модел је почео знатно испод референтне вредности (0,647 у односу на 0,782), престигао је у v25 и достигао 0,846 у v28. Сва три покретања v28 (0,818, 0,842, 0,879) била су изнад референтне вредности. Две касније верзије нису надмашиле v28, па је петља заустављена.
| Anita, пре S13 | Anita, пре S20 | Markus, пре S12 | |
|---|---|---|---|
| v28, просек 3 покретања | 0,963 | 0,800 | 0,776 |
| v28, најбољи од 3 (верификатор) | 0,963 | 0,836 | 0,836 |
| GPT-5.5 референтна вредност (1 покретање) | 0,963 | 0,655 | 0,727 |
Просек за контролне тачке: v28 0,846 · најбољи од 3 0,879 · референтна вредност 0,782.
Слепи преглед: у границама шума оцењивача
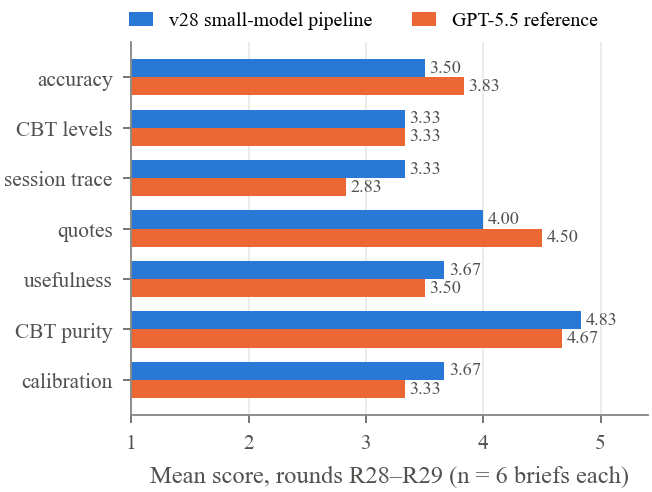
У завршним рундама најбоља верзија малог модела и референтна вредност добиле су 3,77 према 3,87 (R28) и 3,77 према 3,57 (R29). За шест парова у истој рунди разлике су биле −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: средња вредност +0,05, SD 0,49. Ниједан систем није достигао циљни просек супервизора од 4,0. По критеријумима, v28 је била боља у праћењу тока сесија и калибрацији, слабија у тачности (слагању са референтним одговором са златним стандардом) и цитатима, а изједначена у нивоима КПТ-а.
Трошак
Један сажетак v28 кошта око 0,03 USD за писање одељака и траје 2,5–3 минута; сажетак добијен избором најбољег од 3 кошта око 0,11 USD. Обрада нове сесије додаје око 0,07 USD, углавном због проласка класификатора кроз сваку реченицу. Према каталошким ценама, референтни сажетак водећег модела кошта око 19 пута више од једног сажетка v28. За цео пројекат потрошено је 5,57 USD на токене малог модела.
Шта је помогло, а шта није
Помогле су три ствари: исправљање недостатака у детерминистичком коду које је открио супервизор, подешавање високог нивоа напора у резоновању за писце одељака (највиши ниво је коштао више и давао нижи резултат) и пребацивање предложеног дневног реда, траке предвиђања и најновије изјаве у вези са ризиком у код. Неколико уверљивих додатака погоршало је резултате: спајање три нацрта, временска линија уверења наметнута кодом, смернице о важности уз пролаз за поправку покривености и саморевизија вођена критеријумима оцењивања. Сваки од њих додао је корак генерисања у ком мали модел може да изгуби или искриви информације. Свака измена која је моделу одузимала посао или бирала између излаза без њиховог преписивања била је безбедна.
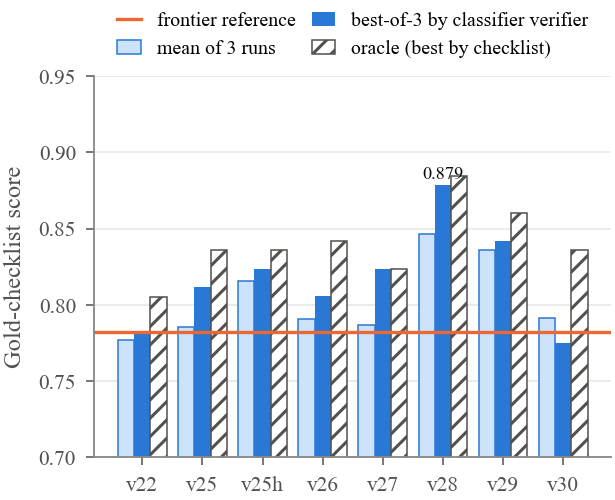
Избор верификатора побољшао је резултат на контролној листи у седам од осам верзија; за v28 резултат је порастао са 0,846 на 0,879, што је близу оракулу (0,885). Пошто су верификатор и оцењивач контролне листе исти класификатор, део овог добитка можда одражава њихове заједничке склоности.
Шта је и даље било тешко
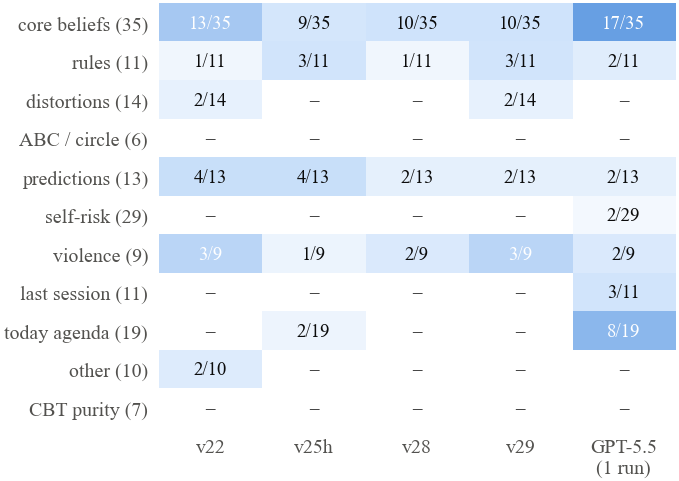
Број упорних неуспеха пао је са 25 на 15 од 164 пондерисане јединице између v22 и v28. Преостали су најсуптилнији судови когнитивног модела: стање уверења након његовог поновног активирања, распони уверења који се завршавају пре најновијег материјала и квалификације опсега. Искази о ризику били су најтежа компонента: кажњавани су и изостављање недавне изјаве и претварање метафоре, вежбе или оцене емоције у сигнал. Најбољи дизајн задржао је само најновију дословну изјаву и сесију у којој је терапеут последњи пут директно питао о њој, а свако тумачење препустио терапеуту.
Оцењивач је део експеримента
Пошто се референтни сажетак никада није мењао, његове оцене мере само супервизора.
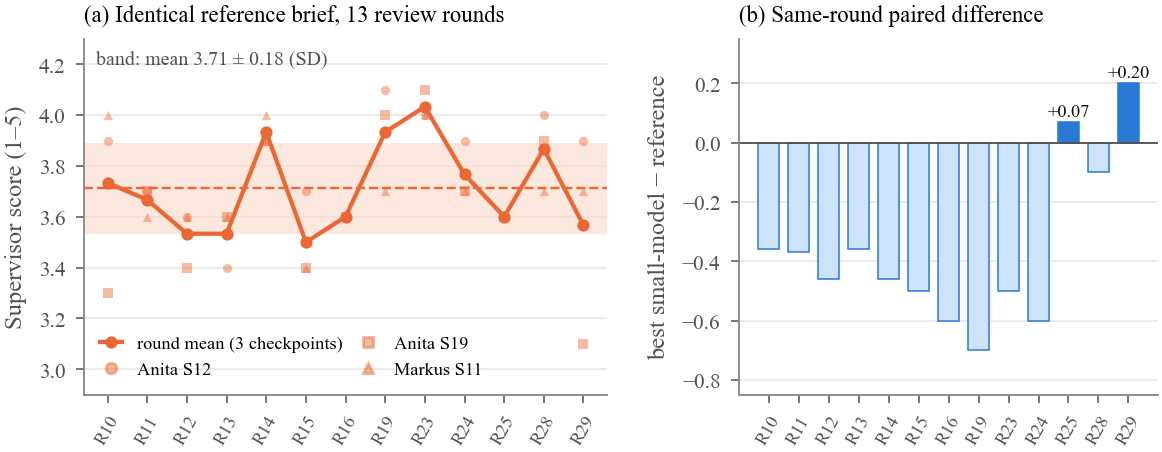
Током 13 рунди, идентични референтни сажетак добијао је средњу оцену по рунди од 3,71 са SD 0,18 и распоном од 3,50–4,03 на скали од 1 до 5. Код појединачних критеријума SD је достигао 0,46, укључујући и цитате који су били проверени скриптом и сваки пут идентични. Тај шум је приближно једнак укупном побољшању које је петља остварила на истој скали.
Шта ова студија не показује
- Само синтетички подаци. Два синтетичка пацијента, три контролне тачке, три покретања по верзији. Само дескриптивна статистика, без тестова статистичке значајности. Пренос на друге задатке и стварни материјал је аргументован, али није показан.
- Само евалуација заснована на моделима. Ниједан клиничар нити други људски оцењивач није учествовао, по дизајну. Оцене описују слагање са контролном листом са златним стандардом и судом LLM супервизора, а не клинички квалитет, безбедност или било какав утицај на терапију.
- Подешено на скупу за евалуацију. Све верзије су развијене на основу истих контролних тачака и оцењивача, па су коначни резултати оптимистични. Испитивање на пацијенту који није био у скупу био би одговарајући тест.
- Немогућност разликовања не значи да је боље. У слепом прегледу, при овој величини узорка, није било могуће разликовати мали модел од референтног водећег модела; разлике су у границама шума самог оцењивача.
- Заједнички класификатор. Оцењивач контролне листе, скенер реченица и верификатор су исти модел.
- Скромна референтна вредност. Референтни водећи модел је једно раније, неоптимизовано покретање процеса помоћу GPT-5.5, а не процес водећег модела подешаван истом петљом.
Прочитајте рад, проверите бројеве
Цео рад се може бесплатно преузети. Пакет података са контролним листама, резултатима и примерима сажетака стиже имејлом.
Рад
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Препринт, 13 страница, 9 слика.
Преузмите пакет података
PDF рада, свих девет слика, три контролне листе са златним стандардом, резултати контролне листе и верификатора за сваку верзију, слепи прегледи из завршних рунди са кључевима слова и три коначна примера сажетака. У датотеци README објашњена су сва поља.
Не делимо адресе. Веза ка подацима стиже за неколико минута.
Шта се налази у ZIP архиви
paper/: рад у PDF форматуfigures/: девет слика и бројеви на којима су заснованеscores/gold_checklists.json: 3 × 25 пондерисаних тврдњиscores/checklist_results.json: вероватноће по ставкама за 198 оцењених сажетакаscores/blind_review_R28.json,R29: седам критеријума, закључци и примедбе, са кључевима словаexample-briefs/: три коначна сажетка v28 (на пољском, као и транскрипти)
Није укључено: синтетички транскрипти, упити и код. Аутори их могу доставити на захтев за истраживачку употребу.
Како цитирати
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}