
Liten modell, omhyggelig pipeline
En autoresearch-metode for å minske avstanden til frontier-LLM-er i lange oppsummeringer på tvers av flere dokumenter. Testet på forberedende sammendrag før økter, basert på transkripsjoner av to syntetiske pasienter.
En rimelig modell kan komme nær, hvis den gjør mindre
Frontier-språkmodeller oppsummerer lange tekster på tvers av flere dokumenter godt, men det blir dyrt å bruke en før hvert eneste resultat. Små modeller er rimelige, men mister informasjon ved lange inndata. Vi undersøkte hvor langt en rimelig modell kan nå når den inngår i en nøye utviklet pipeline og forbedres gjennom en automatisert sløyfe som evaluerer hver endring med andre modeller, uten menneskelige vurderere.
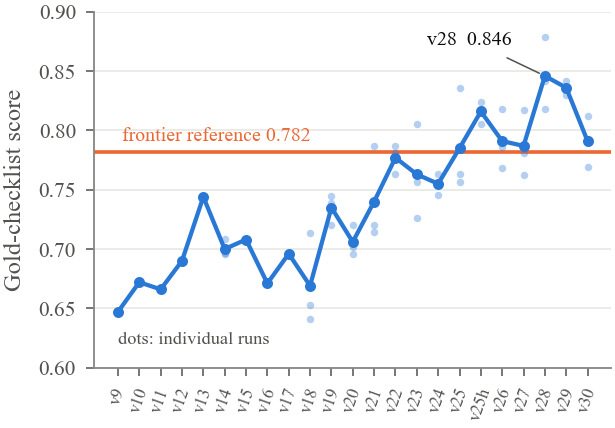
Gjennom 30 versjoner og 16 blinde evalueringsrunder steg den lille modellen fra 0,647 til 0,846 på en vektet gullsjekkliste (0,879 når en referansefri verifikator velger den beste av tre kjøringer). Frontier-referansen fikk 0,782. I blind evaluering utført av en LLM-veileder kunne de to ikke skilles fra hverandre ved denne utvalgsstørrelsen: den gjennomsnittlige parede forskjellen var +0,05 (SD 0,49). Det samme, uendrede referansesammendraget fikk mellom 3,50 og 4,03 fra veilederen på tvers av 13 runder, så støyen i selve bedømmeren viste seg å være et funn i seg selv.
Innhold
Lang inndata, fast struktur, rutinemessig bruk
Mange praktiske oppsummeringsoppgaver har tre fellestrekk: Inndataene er lange og fordelt på mange dokumenter, resultatet følger en fast struktur med tellinger, datoer og ordrette belegg, og resultatet produseres rutinemessig, slik at kostnadene betyr noe.
Vi brukte én slik oppgave som testgrunnlag: et strukturert sammendrag som en KAT-terapeut kan lese på omtrent tre minutter før en økt. Det lister opp kjerneoppfatninger med antall økter, regler, tilbakevendende forvrengninger, typiske ABC-episoder, utprøvde prediksjoner, forrige økt og punkter terapeuten kanskje vil ta opp i dagens økt. Innen økt 20 er materialet på rundt 130 000 ord.
Oppgaven egner seg til et metodisk spørsmål fordi den har en kjent struktur (Becks kognitive modell), en naturlig form for etterprøvbart belegg (pasientens ordrette utsagn) og flere fallgruver: en oppfatning som først ble formulert av terapeuten, eller en metafor som ikke er et utsagn om døden.
To syntetiske pasienter
Begge pasientene ble generert med vår lagdelte metode for syntetiske pasienter (først profilark, terapeutisk forløp, øktplan og veiledning for stemme, deretter økter generert én om gangen som ASR-lignende transkripsjoner). Anita: 20 økter, 131 498 ord, KAT i stil med J. Beck. Markus: 12 økter, 83 978 ord, med en terapeut som delvis arbeider med skjematerapi, slik at sammendraget må oversette materialet tilbake til KAT-begreper. For hver pasient ble en gullreferanse utarbeidet uavhengig, basert på en fullstendig gjennomlesning av transkripsjonene. Ingen reelle pasientdata ble brukt.
Arbeidsdeling
De avgjørende endringene var ikke bedre instruksjoner, men en omfordeling av ansvar. Hver komponent gjør bare det den er god til.
Deterministisk kode
Alt som kan telles, sorteres eller kontrolleres
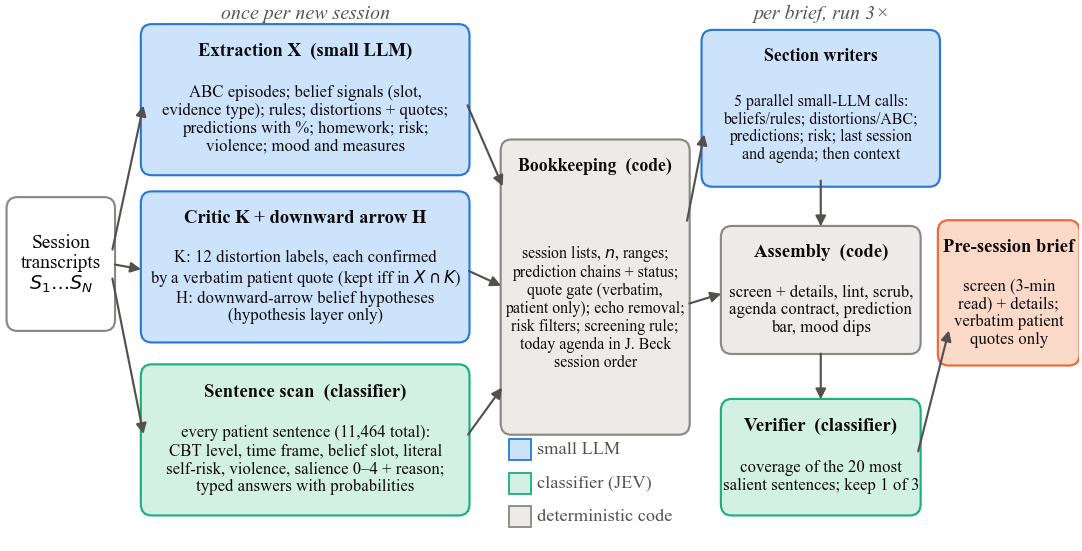
Øktlister, tellinger og spenn for hver oppfatning; prediksjonskjeder koblet på tvers av økter; en port for ordrette sitater som forkaster sitater som ikke finnes i pasientens egne utsagn; fjerning av ekko fra terapeuten; og, fra versjon 28, rekkefølgen på de foreslåtte punktene for dagens økt. Når en feil i denne koden først er funnet, blir den rettet permanent.
En setningsklassifikator
Vurderinger som ikke krever tekstgenerering
Hver pasientsetning (11 464 totalt) merkes én gang: KAT-nivå (automatisk tanke, regel, oppfatning, følelse, atferd …), tidsramme (nå eller tilbakeblikk), bokstavelig eller billedlig språk, og hvor relevant setningen kan være for neste økt, hver med en sannsynlighet. Den samme klassifikatoren brukes senere som referansefri verifikator og til å vurdere sjekklisten.
En liten språkmodell
Kortfattet tekst basert på klargjort materiale
For hver økt trekker den lille modellen ut struktur, bekrefter forvrengninger med ordrette sitater og foreslår hypoteser (lagret som hypoteser, aldri som belegg). For hvert sammendrag kjører fem skribenter for hver sin del parallelt. Hver av dem ser bare de øktnummererte dataene for sin del og får beskjed om aldri å finne på øktnumre eller sitater.
Beste av tre, uten å se svaret
Forskjellene mellom kjøringer innen samme versjon var ofte større enn forskjellene mellom versjoner. Derfor kjører pipelinen for sammendragsnivå tre ganger, og en verifikator velger én: Den tar de 20 mest relevante pasientsetningene og spør klassifikatoren om hver av dem gjenspeiles i sammendraget. Verifikatoren ser aldri gullreferansen eller sjekklisten.
Autoresearch-sløyfen
En automatisert utviklingssløyfe inspirert av nyere arbeid med automatiserte eksperimenter: foreslå én endring, kjør den, og behold den bare hvis to uavhengige måltall peker i samme retning.
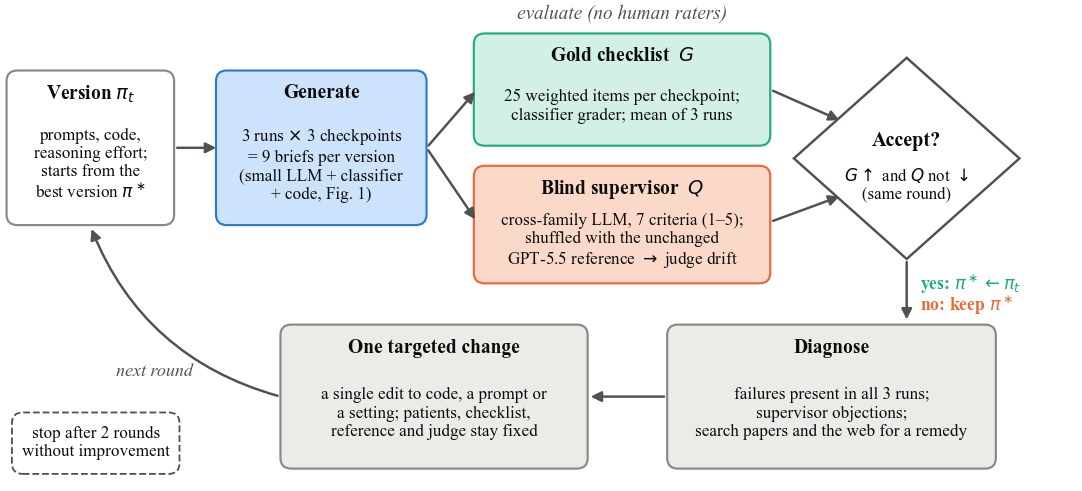
- To måltall. En gullsjekkliste med 25 vektede utsagn per kontrollpunkt, vurdert av klassifikatoren, og en blind evaluering utført av en LLM-veileder fra en annen modellfamilie, med skårer på sju kriterier på en skala fra 1 til 5.
- Et fast holdepunkt. Veilederen ser alltid også ett uendret frontier-referansesammendrag, under en tilfeldig bokstav, slik at bedømmerens egen drift måles i hver runde.
- Én endring om gangen. Feil som finnes i alle tre kjøringer, og veilederens innvendinger, brukes til å styre én målrettet endring per runde, informert av et litteratursøk.
- En fast stoppregel. To påfølgende runder uten forbedring avslutter sløyfen. Den stoppet ved v28.
- Et fast kostnadstak. Ingen modell som er dyrere enn den lille modellen eller klassifikatoren, kan brukes i pipelinen.
Hva vi observerte
Beskrivende statistikk fra tre kontrollpunkter (Anita før økt 13 og 20, Markus før økt 12) og tre kjøringer per versjon.
Innholdsdekning: gullsjekklisten
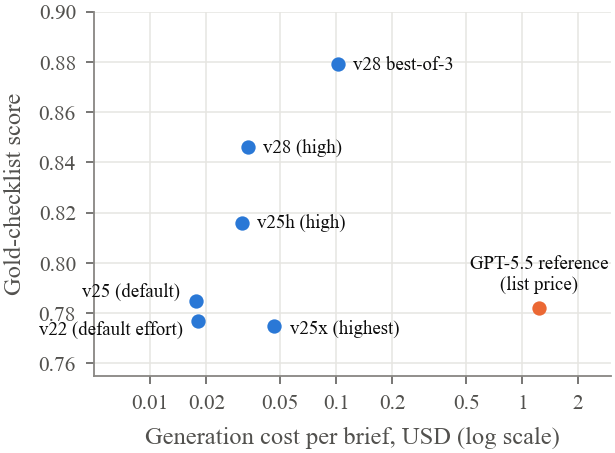
Den lille modellen startet godt under referansen (0,647 mot 0,782), passerte den ved v25 og nådde 0,846 ved v28. Alle de tre v28-kjøringene (0,818, 0,842, 0,879) ligger over referansen. To senere versjoner forbedret ikke resultatet fra v28, og sløyfen ble avsluttet.
| Anita, før S13 | Anita, før S20 | Markus, før S12 | |
|---|---|---|---|
| v28, gjennomsnitt av 3 kjøringer | 0,963 | 0,800 | 0,776 |
| v28, best-of-3 (verifikator) | 0,963 | 0,836 | 0,836 |
| GPT-5.5-referanse (1 kjøring) | 0,963 | 0,655 | 0,727 |
Gjennomsnitt over kontrollpunktene: v28 0,846 · best-of-3 0,879 · referanse 0,782.
Blind evaluering: innenfor bedømmerens støynivå
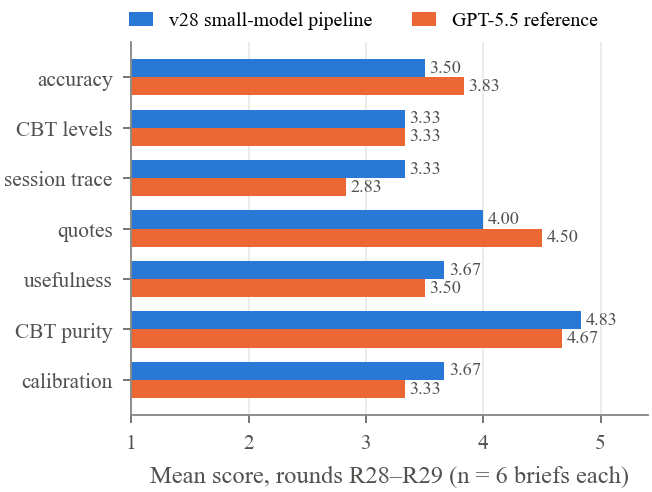
I de siste rundene fikk den beste versjonen av den lille modellen og referansen skårene 3,77 mot 3,87 (R28) og 3,77 mot 3,57 (R29). På tvers av seks par fra samme runde var forskjellene −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: gjennomsnitt +0,05, SD 0,49. Ingen av systemene nådde veilederens målgjennomsnitt på 4,0. Per kriterium lå v28 foran på sporbarhet til øktene og kalibrering, bak på nøyaktighet (samsvar med gullreferansen) og sitater, og likt på KAT-nivåer.
Kostnad
Ett v28-sammendrag koster omtrent USD 0,03 for skriving av delene og tar 2,5–3 minutter; et best-of-3-sammendrag koster omtrent USD 0,11. Behandling av en ny økt koster omtrent USD 0,07 ekstra, hovedsakelig på grunn av klassifikatorens gjennomgang av hver setning. Med listepriser koster et frontier-referansesammendrag omtrent 19 ganger så mye som ett v28-sammendrag. Hele prosjektet brukte småmodellbrikker for USD 5,57.
Hva hjalp, og hva gjorde ikke det
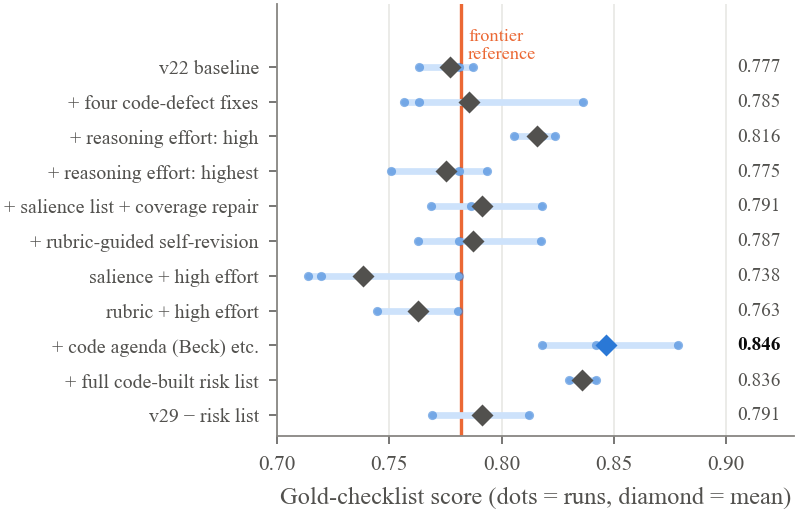
Tre ting hjalp: å rette feil i deterministisk kode som veilederen fant, en innstilling for høy resonneringsinnsats for skribentene (den høyeste innstillingen kostet mer og ga lavere skår), og å flytte den foreslåtte dagsordenen, prediksjonslinjen og den nyeste risikorelaterte uttalelsen over i kode. Flere plausible tillegg svekket resultatet: å slå sammen tre utkast, en kodestyrt tidslinje for oppfatninger, relevanshint med et dekningskorrigerende trinn og rubrikkstyrt selvrevisjon. Hvert av disse la til et genereringstrinn der en liten modell kan miste eller forvrenge informasjon. Alle endringer som tok arbeid bort fra modellen, eller valgte mellom resultater uten å skrive dem om, var trygge.
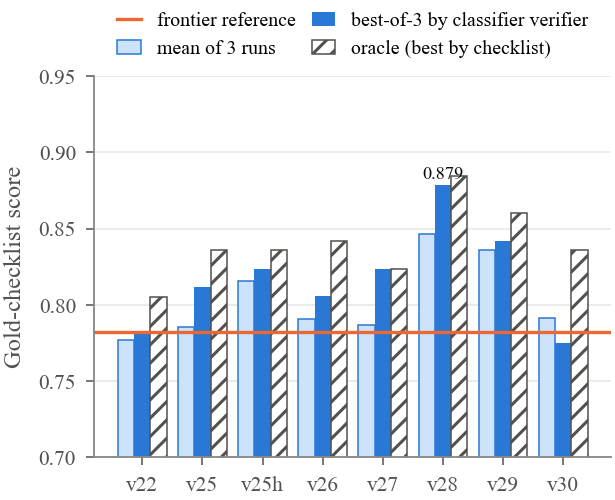
Verifikatorutvelgelse forbedret sjekklisteskåren for sju av åtte versjoner; for v28 fra 0,846 til 0,879, nær orakelverdien (0,885). Siden verifikatoren og sjekklistevurdereren er samme klassifikator, kan en del av denne gevinsten gjenspeile felles preferanser.
Hva som fortsatt var vanskelig
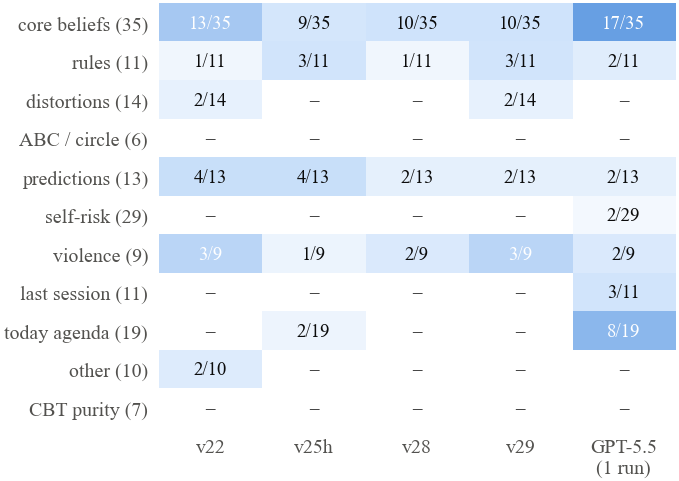
Vedvarende feil falt fra 25 til 15 av 164 vektenheter mellom v22 og v28. Det som gjenstår, er de mest finstilte vurderingene i den kognitive modellen: tilstanden til en oppfatning etter at den aktiveres på nytt, spenn for oppfatninger som avsluttes før det nyeste materialet, og avgrensninger av hva utsagn omfatter. Utsagn om risiko var den vanskeligste komponenten: både det å utelate en nylig uttalelse og det å gjøre en metafor, en øvelse eller en følelsesskår om til et signal ble straffet. Den beste utformingen beholdt bare den nyeste bokstavelige uttalelsen og økten der terapeuten sist spurte direkte om den, og overlot alle tolkninger til terapeuten.
Bedømmeren er en del av eksperimentet
Siden referansesammendraget aldri ble endret, måler skårene bare veilederen.
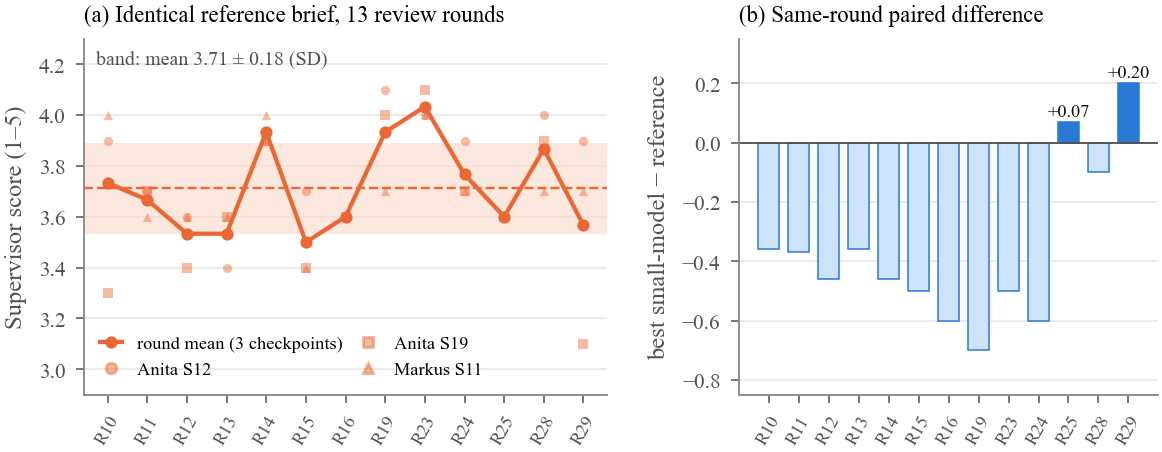
På tvers av 13 runder fikk det identiske referansesammendraget et gjennomsnitt per runde på 3,71, med SD 0,18 og et spenn på 3,50–4,03 på en skala fra 1 til 5. For enkeltkriterier nådde SD 0,46, også for sitater som var verifisert med skript og identiske hver gang. Denne støyen er omtrent like stor som hele forbedringen sløyfen ga på samme skala.
Hva denne studien ikke viser
- Kun syntetiske data. To syntetiske pasienter, tre kontrollpunkter, tre kjøringer per versjon. Bare beskrivende statistikk, ingen signifikanstester. Overførbarhet til andre oppgaver og reelt materiale er begrunnet, men ikke vist.
- Kun modelevaluering. Ingen klinikere eller andre menneskelige vurderere deltok, etter planen. Skårene beskriver samsvar med en gullsjekkliste og en LLM-veileders vurdering, ikke klinisk kvalitet, sikkerhet eller noen effekt på terapi.
- Tilpasset evalueringssettet. Alle versjoner ble utviklet mot de samme kontrollpunktene og bedømmerne, så sluttskårene er optimistiske. En pasient holdt utenfor utviklingen ville vært den riktige testen.
- Ikke mulig å skille betyr ikke bedre. I blind evaluering kunne man ikke skille den lille modellen fra frontier-referansen ved denne utvalgsstørrelsen; forskjellene ligger innenfor bedømmerens eget støynivå.
- Delt klassifikator. Sjekklistevurdereren, setningsskanneren og verifikatoren er samme modell.
- En beskjeden referanse. Frontier-referansen er én tidligere, ikke-optimert pipelinekjøring med GPT-5.5, ikke en frontier-pipeline tilpasset med samme sløyfe.
Les artikkelen, kontroller tallene
Hele artikkelen kan lastes ned gratis. Datapakken med sjekklister, skårer og eksempelsammendrag sendes på e-post.
Artikkelen
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Forhåndstrykk, 13 sider, 9 figurer.
Last ned datapakken
PDF av artikkelen, alle ni figurene, de tre gullsjekklistene, sjekkliste- og verifikatorskårer for hver versjon, blinde evalueringer fra de siste rundene med tilhørende bokstavnøkler, samt tre endelige eksempelsammendrag. En README forklarer hvert felt.
Vi deler ikke e-postadresser. Lenken til dataene kommer i løpet av noen minutter.
Dette inneholder ZIP-filen
paper/: artikkelen som PDFfigures/: ni figurer pluss tallene som ligger bak demscores/gold_checklists.json: 3 × 25 vektede utsagnscores/checklist_results.json: sannsynligheter per element for 198 vurderte sammendragscores/blind_review_R28.json,R29: sju kriterier, konklusjoner og innvendinger, med bokstavnøklerexample-briefs/: tre endelige v28-sammendrag (på polsk, som transkripsjonene)
Ikke inkludert: syntetiske transkripsjoner, instruksjoner og kode. De kan fås fra forfatterne på forespørsel til forskningsbruk.
Slik siterer du
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}