
Model mic, pipeline atent
O metodă de autoresearch pentru reducerea decalajului față de LLM-urile de frontieră în rezumarea lungă, cu documente multiple. Testată pe rezumate pre-sesiune realizate pe baza transcrierilor a doi pacienți sintetici.
Un model ieftin se poate apropia, dacă face mai puțin
Modelele lingvistice de frontieră rezumă bine materiale lungi, cu documente multiple, dar utilizarea unuia înainte de fiecare rezultat devine costisitoare. Modelele mici sunt ieftine, dar pierd informații când intrările sunt lungi. Am analizat până unde poate ajunge un model cu cost redus atunci când este integrat într-un pipeline conceput cu atenție și îmbunătățit printr-o buclă automatizată care evaluează fiecare modificare cu alte modele, fără evaluatori umani.
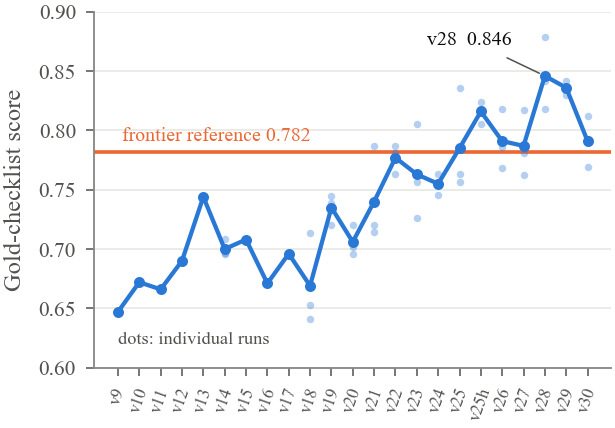
În peste 30 de versiuni și 16 runde de evaluare oarbă, modelul mic a crescut de la 0,647 la 0,846 pe o listă de verificare de referință ponderată (0,879 când verificatorul fără referință selectează cea mai bună dintre trei rulări). Referința de frontieră a obținut 0,782. În evaluarea oarbă realizată de un supervizor LLM, cele două nu au putut fi deosebite la această dimensiune a eșantionului: diferența medie între perechi a fost de +0,05 (SD 0,49). Același rezumat de referință, neschimbat, a primit scoruri între 3,50 și 4,03 de la acel supervizor în 13 runde, astfel că zgomotul propriu al evaluatorului s-a dovedit, în sine, o constatare.
Cuprins
Intrare lungă, structură fixă, utilizare de rutină
Multe sarcini practice de rezumare au trei caracteristici comune: intrarea este lungă și distribuită în multe documente, rezultatul urmează o structură fixă cu numărători, date și dovezi citate textual, iar rezultatul este produs în mod regulat, deci costul contează.
Am folosit o astfel de sarcină ca teren de testare: un rezumat structurat pe care un terapeut CBT îl poate citi în aproximativ trei minute înaintea unei ședințe. Acesta enumeră convingerile de bază împreună cu numărul ședințelor, regulile, distorsiunile recurente, episoadele ABC tipice, predicțiile testate, ultima ședință și aspectele pe care terapeutul ar putea dori să le abordeze în ședința de astăzi. Până la ședința 20, materialul ajunge la aproximativ 130,000 de cuvinte.
Sarcina este potrivită pentru o întrebare metodologică, deoarece are o structură cunoscută (modelul cognitiv al lui Beck), o noțiune naturală de dovezi verificabile (cuvintele exacte ale pacientului) și câteva capcane: o convingere formulată inițial de terapeut sau o metaforă care nu este o afirmație despre moarte.
Doi pacienți sintetici
Ambii pacienți au fost generați prin metoda noastră stratificată pentru pacienți sintetici (mai întâi fișa de profil, parcursul terapeutic, planul ședințelor și ghidul vocii, apoi ședințele generate una câte una ca transcrieri de tip ASR). Anita: 20 de ședințe, 131,498 de cuvinte, CBT în stilul lui J. Beck. Markus: 12 ședințe, 83,978 de cuvinte, cu un terapeut care lucrează parțial în terapia schemelor, astfel încât rezumatul trebuie să traducă materialul înapoi în termeni CBT. Pentru fiecare pacient, un reper de referință a fost redactat independent, pe baza lecturii complete a transcrierilor. Nu s-au folosit date despre pacienți reali.
Împărțirea responsabilităților
Modificările decisive nu au constat în prompturi mai bune, ci în redistribuirea responsabilităților. Fiecare componentă face doar ceea ce știe să facă bine.
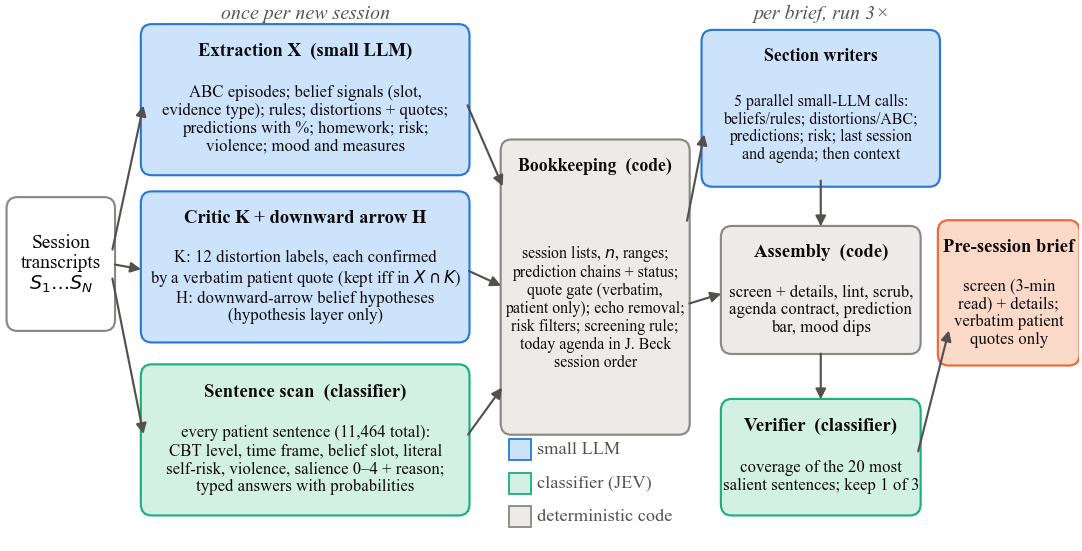
Cod determinist
Tot ce poate fi numărat, ordonat sau verificat
Listele ședințelor, numărătorile și intervalele pentru fiecare convingere; lanțurile de predicții corelate între ședințe; o verificare a citatelor exacte care elimină orice citat care nu apare în replicile pacientului; eliminarea ecourilor terapeutului; iar, începând cu versiunea 28, ordinea punctelor sugerate pentru ședința de astăzi. Odată identificat un defect în acest cod, acesta este corectat definitiv.
Un clasificator de propoziții
Evaluări care nu necesită generarea de text
Fiecare propoziție a pacientului (11,464 în total) este etichetată o singură dată: nivelul CBT (gând automat, regulă, convingere, emoție, comportament…), intervalul temporal (prezent sau rememorat), formularea literală sau figurată și relevanța posibilă a propoziției pentru următoarea ședință, fiecare cu o probabilitate. Același clasificator servește ulterior drept verificator fără referință și evaluator al listei de verificare.
Un model lingvistic mic
Redactare concisă pe baza materialului pregătit
Pentru fiecare ședință, modelul mic extrage structura, confirmă distorsiunile cu citate exacte și propune ipoteze (păstrate ca ipoteze, niciodată ca dovezi). Pentru fiecare rezumat, cinci redactori de secțiuni rulează în paralel; fiecare vede doar datele numerotate după ședință pentru propria secțiune și primește instrucțiunea să nu inventeze numere de ședințe sau citate.
Cea mai bună dintre trei, fără a consulta răspunsul
Diferențele dintre rulările aceleiași versiuni erau adesea mai mari decât diferențele dintre versiuni. Așadar, pipeline-ul la nivel de rezumat rulează de trei ori, iar un verificator selectează una dintre rezultate: extrage cele mai relevante 20 de propoziții ale pacientului și îi cere clasificatorului să determine dacă fiecare este reflectată în rezumat. Verificatorul nu vede reperul de referință sau lista de verificare.
Bucla de autoresearch
O buclă de dezvoltare automatizată, în spiritul lucrărilor recente despre experimentarea automatizată: propune o modificare, testeaz-o și păstreaz-o numai dacă două metrici independente concordă.
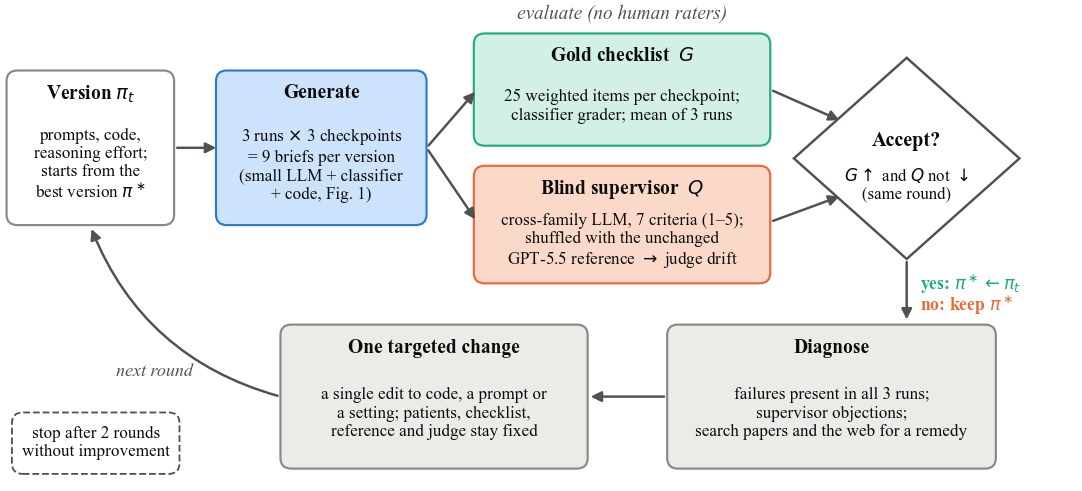
- Două metrici. O listă de verificare de referință cu 25 de afirmații ponderate pentru fiecare punct de verificare, evaluată de clasificator, și o evaluare oarbă realizată de un supervizor LLM dintr-o familie de modele diferită, care notează șapte criterii pe o scală de la 1 la 5.
- Un reper fix. Supervizorul vede întotdeauna și un rezumat de referință de frontieră neschimbat, identificat printr-o literă aleatorie, astfel încât deriva proprie a evaluatorului să fie măsurată în fiecare rundă.
- O modificare odată. Erorile prezente în toate cele trei rulări și obiecțiile supervizorului determină câte o modificare specifică pe rundă, informată de o căutare în literatura de specialitate.
- O regulă de oprire fixă. Două runde consecutive fără îmbunătățire încheie bucla. Aceasta s-a oprit la v28.
- Un plafon de cost fix. În pipeline nu poate fi folosit niciun model mai costisitor decât modelul mic sau clasificatorul.
Ce am observat
Statistici descriptive pentru trei puncte de verificare (Anita înaintea ședințelor 13 și 20, Markus înaintea ședinței 12) și trei rulări pentru fiecare versiune.
Acoperirea conținutului: lista de verificare de referință
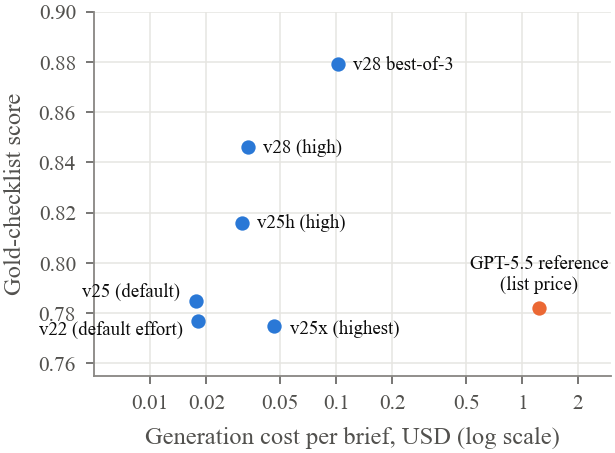
Modelul mic a pornit mult sub referință (0,647 față de 0,782), a depășit-o la v25 și a ajuns la 0,846 la v28. Toate cele trei rulări v28 (0,818, 0,842, 0,879) sunt peste referință. Două versiuni ulterioare nu au îmbunătățit rezultatul v28, iar bucla s-a oprit.
| Anita, înainte de S13 | Anita, înainte de S20 | Markus, înainte de S12 | |
|---|---|---|---|
| v28, media a 3 rulări | 0,963 | 0,800 | 0,776 |
| v28, best-of-3 (verificator) | 0,963 | 0,836 | 0,836 |
| referință GPT-5.5 (1 rulare) | 0,963 | 0,655 | 0,727 |
Medii pentru punctele de verificare: v28 0,846 · best-of-3 0,879 · referință 0,782.
Evaluare oarbă: în limitele zgomotului evaluatorului
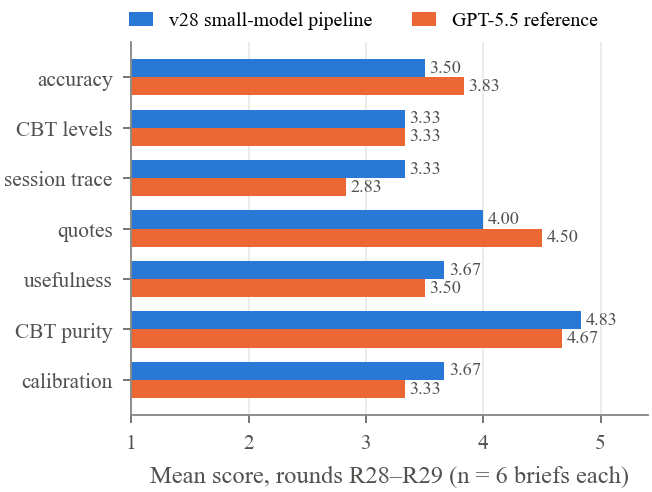
În rundele finale, cea mai bună versiune a modelului mic și referința au obținut 3,77 față de 3,87 (R28) și 3,77 față de 3,57 (R29). Pentru șase perechi din aceeași rundă, diferențele au fost −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: media +0,05, SD 0,49. Niciunul dintre sisteme nu a atins media-țintă de 4,0 a supervizorului. Pe criterii, v28 a fost în avantaj la urmărirea ședințelor și calibrare, în dezavantaj la acuratețe (concordanța cu reperul de referință) și citate și la același nivel la nivelurile CBT.
Cost
Un rezumat v28 costă aproximativ 0,03 USD pentru redactarea secțiunilor și durează 2,5–3 minute; un rezumat best-of-3 costă aproximativ 0,11 USD. Procesarea unei noi ședințe adaugă aproximativ 0,07 USD, în principal pentru trecerea clasificatorului peste fiecare propoziție. La prețurile de listă, rezumatul de referință de frontieră costă de aproximativ 19 ori mai mult decât un singur rezumat v28. Întregul proiect a folosit tokenuri ale modelului mic în valoare de 5,57 USD.
Ce a ajutat și ce nu
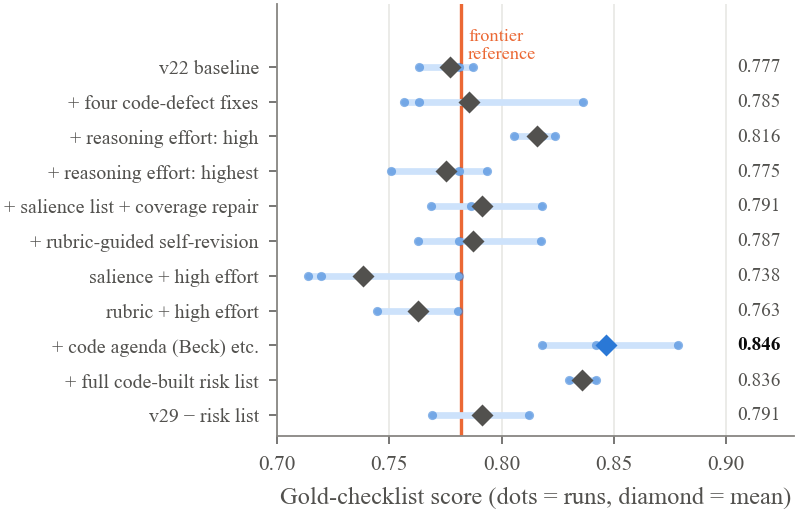
Trei lucruri au fost de ajutor: corectarea defectelor din codul determinist identificate de supervizor, un nivel ridicat de efort de raționament pentru redactarea secțiunilor (nivelul maxim a costat mai mult și a obținut un scor mai mic) și transferarea în cod a agendei sugerate, a barei predicțiilor și a celei mai recente afirmații privind riscurile. Mai multe completări plauzibile au avut efect negativ: combinarea a trei ciorne, o cronologie a convingerilor impusă de cod, indicii de relevanță însoțite de o etapă de reparare a acoperirii și autorevizuirea ghidată de o rubrică. Fiecare a adăugat o etapă de generare în care un model mic poate pierde sau denatura informații. Toate modificările care au redus volumul de lucru al modelului sau au selectat între rezultate fără a le rescrie au fost sigure.
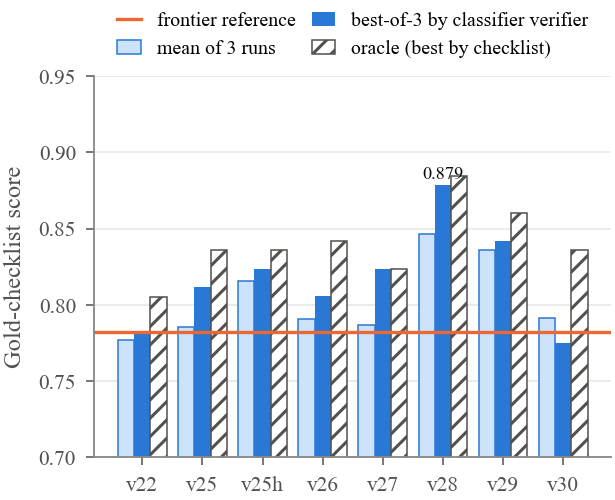
Selecția verificatorului a îmbunătățit scorul listei de verificare pentru șapte dintre cele opt versiuni; pentru v28, scorul a crescut de la 0,846 la 0,879, aproape de rezultatul oracolului (0,885). Deoarece verificatorul și evaluatorul listei de verificare sunt același clasificator, o parte din acest câștig poate reflecta preferințe comune.
Ce a rămas dificil
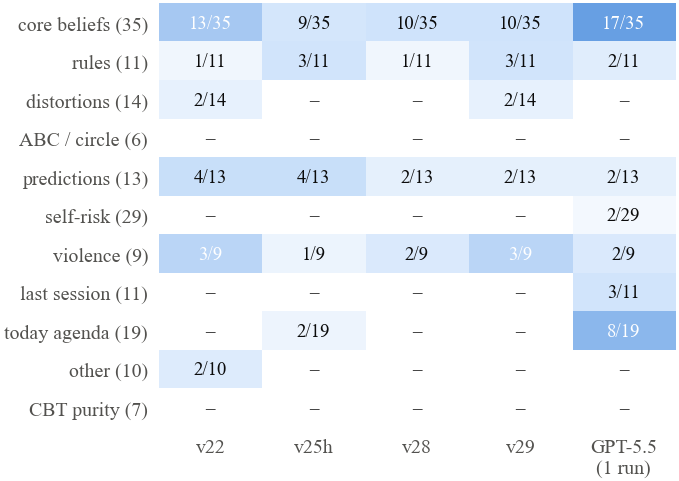
Erorile persistente au scăzut de la 25 la 15 unități ponderate din 164 între v22 și v28. Rămân cele mai subtile judecăți ale modelului cognitiv: starea unei convingeri după reactivarea ei, intervalele convingerilor care se opresc înaintea celui mai recent material și calificările privind sfera de aplicare. Afirmațiile despre riscuri au fost componenta cea mai dificilă: au fost penalizate atât omiterea unei afirmații recente, cât și interpretarea unei metafore, a unui exercițiu sau a unei evaluări a emoției drept semnal. Cel mai bun design a păstrat doar cea mai recentă afirmație literală și ședința în care terapeutul a întrebat ultima dată direct despre aceasta, lăsând fiecare interpretare în seama terapeutului.
Evaluatorul face parte din experiment
Deoarece rezumatul de referință nu s-a schimbat niciodată, scorurile sale măsoară exclusiv supervizorul.
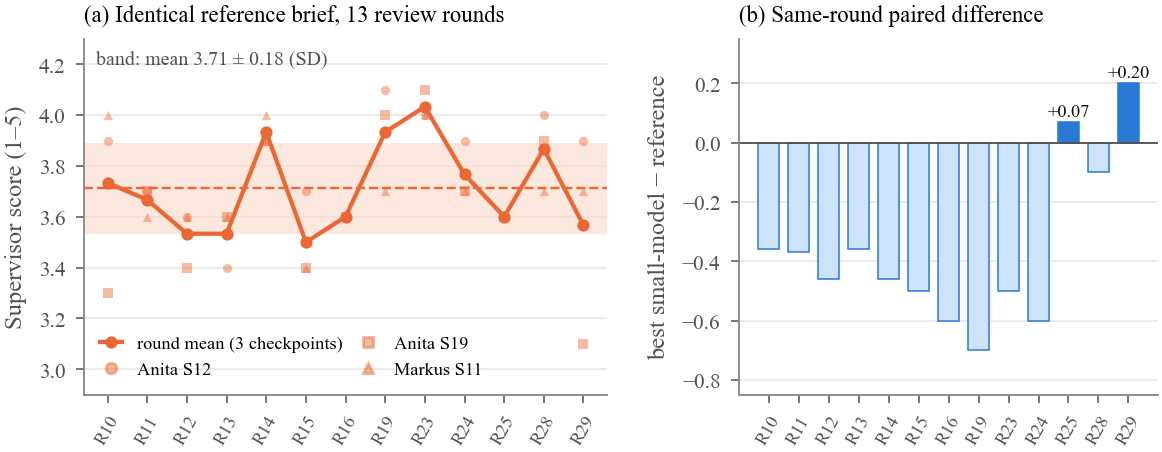
De-a lungul a 13 runde, același rezumat de referință a primit o medie de rundă de 3,71, cu SD 0,18 și un interval de 3,50–4,03 pe o scară de la 1 la 5. Pentru criterii individuale, SD a ajuns la 0,46, inclusiv pentru citatele verificate prin script și identice de fiecare dată. Acest zgomot este aproximativ la fel de mare ca întreaga îmbunătățire produsă de buclă pe aceeași scară.
Ce nu arată acest studiu
- Doar date sintetice. Doi pacienți sintetici, trei puncte de verificare, trei rulări per versiune. Doar statistici descriptive, fără teste de semnificație. Transferul la alte sarcini și la materiale reale este argumentat, nu demonstrat.
- Evaluare exclusiv bazată pe modele. Niciun clinician sau alt evaluator uman nu a participat, în mod deliberat. Scorurile descriu concordanța cu o listă de verificare de referință și judecata unui supervizor LLM, nu calitatea clinică, siguranța sau vreun efect asupra terapiei.
- Optimizare pe setul de evaluare. Toate versiunile au fost dezvoltate folosind aceleași puncte de verificare și aceiași evaluatori, astfel încât scorurile finale sunt optimiste. Un pacient păstrat separat ar fi testul adecvat.
- Indistinct nu înseamnă mai bun. În evaluarea oarbă, modelul mic și referința de frontieră nu au putut fi deosebite la această dimensiune a eșantionului; diferențele se încadrează în zgomotul propriu al evaluatorului.
- Clasificator comun. Evaluatorul listei de verificare, analizorul de propoziții și verificatorul sunt același model.
- O referință modestă. Referința de frontieră este o rulare anterioară, neoptimizată, a unui pipeline, executată o singură dată cu GPT-5.5, nu un pipeline de frontieră optimizat cu aceeași buclă.
Citește lucrarea, verifică cifrele
Lucrarea completă poate fi descărcată gratuit. Pachetul de date, cu liste de verificare, scoruri și exemple de rezumate, este trimis prin e-mail.
Lucrarea
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Preprint, 13 pagini, 9 figuri.
Descarcă pachetul de date
PDF-ul lucrării, toate cele nouă figuri, cele trei liste de verificare de referință, scorurile listei de verificare și ale verificatorului pentru fiecare versiune, evaluările oarbe din rundele finale împreună cu cheile literelor și trei exemple finale de rezumate. Un fișier README explică fiecare câmp.
Nu distribuim adresele. Linkul către date sosește în câteva minute.
Ce conține arhiva ZIP
paper/: lucrarea în format PDFfigures/: nouă figuri și cifrele care stau la baza lorscores/gold_checklists.json: 3 × 25 de afirmații ponderatescores/checklist_results.json: probabilități per element pentru 198 de rezumate evaluatescores/blind_review_R28.json,R29: șapte criterii, verdicte și obiecții, cu cheile literelorexample-briefs/: trei rezumate finale v28 (în poloneză, ca transcrierile)
Nu sunt incluse: transcrierile sintetice, prompturile și codul. Acestea pot fi obținute de la autori la cerere, în scopuri de cercetare.
Cum se citează
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}