
Modelo pequeno, pipeline cuidadoso
Um método de autoresearch para reduzir a distância em relação aos LLMs de ponta na sumarização longa de múltiplos documentos. Testado em resumos pré-sessão elaborados a partir das transcrições de dois pacientes sintéticos.
Um modelo barato pode chegar perto, se fizer menos
Modelos de linguagem de ponta resumem bem materiais longos com vários documentos, mas usar um antes de cada saída sai caro. Modelos pequenos são baratos, mas perdem informação com entradas longas. Perguntamos até onde um modelo de baixo custo pode chegar quando inserido em um pipeline cuidadosamente desenvolvido e aprimorado por um ciclo automatizado que avalia cada alteração com outros modelos, sem avaliadores humanos.
Em mais de 30 versões e 16 rodadas de revisão cega, o modelo pequeno passou de 0,647 para 0,846 em uma lista de verificação de referência ponderada (0,879 quando um verificador sem referência escolhe a melhor de três execuções). A referência de ponta obteve 0,782. Na revisão cega por um supervisor LLM, não foi possível distinguir os dois nesta amostra: a diferença média pareada foi de +0,05 (DP 0,49). O mesmo resumo de referência, sem alterações, recebeu notas entre 3,50 e 4,03 desse supervisor ao longo de 13 rodadas; assim, o próprio ruído do avaliador acabou sendo um achado por si só.
Índice
Entrada longa, estrutura fixa, uso rotineiro
Muitas tarefas práticas de sumarização têm três características em comum: a entrada é longa e distribuída por muitos documentos; a saída segue uma estrutura fixa, com contagens, datas e evidências literais; e a saída é produzida rotineiramente, portanto o custo importa.
Usamos uma dessas tarefas como banco de testes: um resumo estruturado que um terapeuta de TCC pode ler em cerca de três minutos antes de uma sessão. Ele lista crenças centrais com contagens de sessões, regras, distorções recorrentes, episódios ABC típicos, previsões testadas, a última sessão e pontos que o terapeuta talvez queira abordar na sessão de hoje. Na sessão 20, o material chega a cerca de 130.000 palavras.
A tarefa é adequada a uma questão de métodos porque tem uma estrutura conhecida (o modelo cognitivo de Beck), uma noção natural de evidência verificável (as palavras literais do paciente) e várias armadilhas: uma crença formulada inicialmente pelo terapeuta ou uma metáfora que não constitui uma afirmação sobre a morte.
Dois pacientes sintéticos
Os dois pacientes foram gerados com nosso método em camadas para pacientes sintéticos (primeiro, ficha de perfil, arco terapêutico, plano de sessões e guia de voz; depois, sessões geradas uma a uma como transcrições no estilo de ASR). Anita: 20 sessões, 131.498 palavras, TCC no estilo de J. Beck. Markus: 12 sessões, 83.978 palavras, com um terapeuta que trabalha parcialmente com terapia do esquema, de modo que o resumo precisa traduzir o material de volta para termos da TCC. Para cada paciente, uma referência de referência foi redigida de forma independente, após a leitura completa das transcrições. Não foram usados dados de pacientes reais.
Divisão do trabalho
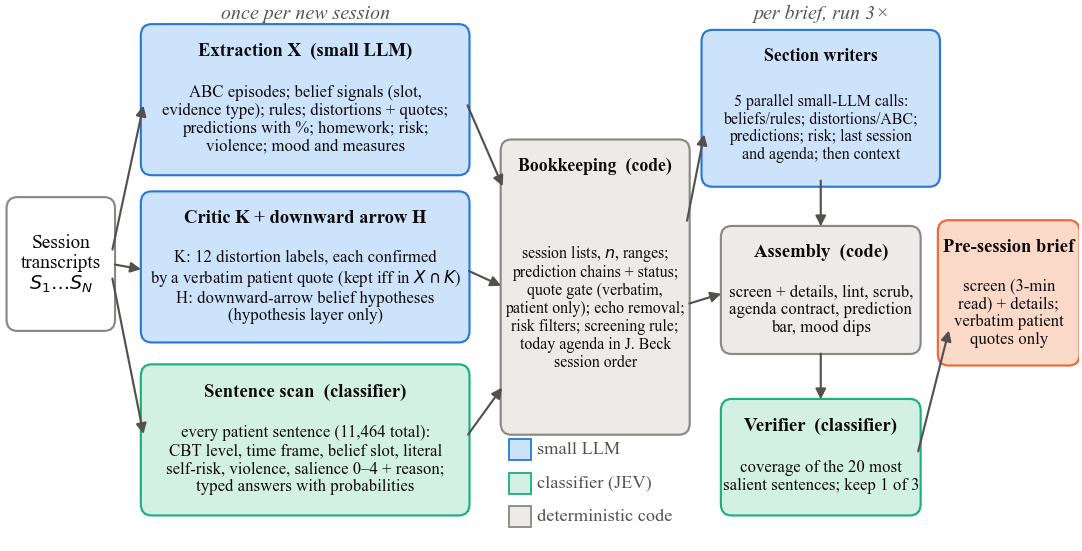
As mudanças decisivas não foram prompts melhores, mas uma redistribuição de responsabilidades. Cada componente faz apenas aquilo em que é bom.
Código determinístico
Tudo o que pode ser contado, ordenado ou verificado
Listas de sessões, contagens e intervalos para cada crença; cadeias de previsões vinculadas entre sessões; um filtro de citações literais que elimina qualquer citação não encontrada nas falas do próprio paciente; remoção de ecos do terapeuta; e, a partir da versão 28, a ordem dos pontos sugeridos para a sessão de hoje. Quando um defeito nesse código é encontrado, ele permanece corrigido.
Um classificador de frases
Avaliações que não exigem geração de texto
Cada frase do paciente (11.464 no total) recebe uma classificação única: nível de TCC (pensamento automático, regra, crença, emoção, comportamento…), período temporal (atual ou recordado), formulação literal ou figurada e possível relevância da frase para a próxima sessão, cada uma com uma probabilidade. Mais tarde, o mesmo classificador atua como verificador sem referência e avaliador da lista de verificação.
Um modelo de linguagem pequeno
Redação breve a partir de material preparado
Por sessão, o modelo pequeno extrai a estrutura, confirma distorções com citações literais e propõe hipóteses (armazenadas como hipóteses, nunca como evidências). Para cada resumo, cinco redatores de seção são executados em paralelo; cada um vê apenas os dados numerados por sessão de sua própria seção e recebe instruções para nunca inventar números de sessão ou citações.
Melhor de três, sem consultar a resposta
As diferenças entre execuções de uma mesma versão eram frequentemente maiores do que as diferenças entre versões. Por isso, o pipeline no nível do resumo é executado três vezes e um verificador escolhe uma delas: ele seleciona as 20 frases mais relevantes do paciente e pergunta ao classificador se cada uma está refletida no resumo. O verificador nunca vê a referência de referência nem a lista de verificação.
O ciclo de autoresearch
Um ciclo automatizado de desenvolvimento, na linha dos trabalhos recentes sobre experimentação automatizada: propor uma alteração, executá-la e mantê-la apenas se duas métricas independentes concordarem.
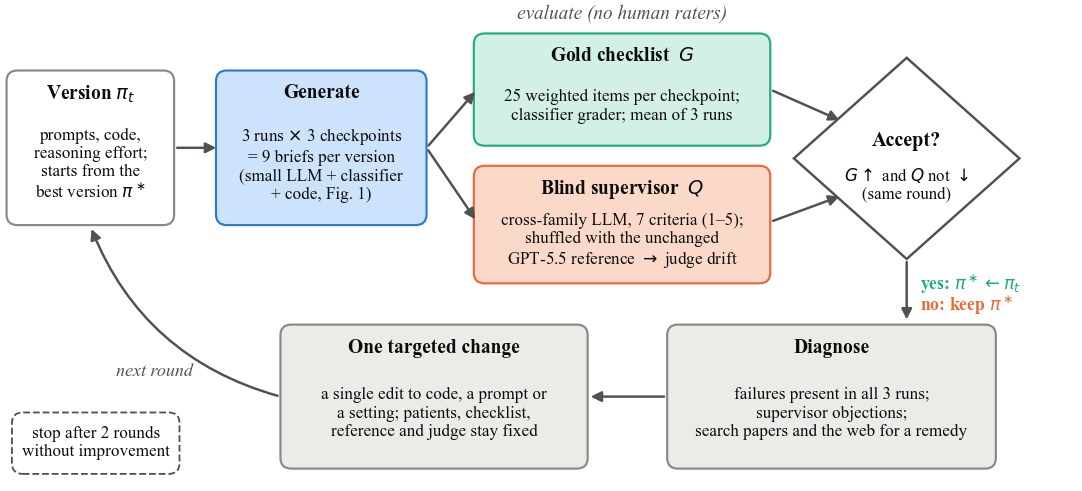
- Duas métricas. Uma lista de verificação de referência com 25 afirmações ponderadas por ponto de verificação, avaliada pelo classificador, e uma revisão cega por um supervisor LLM de outra família de modelos, que pontua sete critérios numa escala de 1 a 5.
- Uma referência fixa. O supervisor também recebe sempre um resumo de referência de ponta inalterado, identificado por uma letra aleatória, para que o desvio do próprio avaliador seja medido em cada rodada.
- Uma alteração de cada vez. As falhas presentes nas três execuções e as objeções do supervisor orientam uma alteração direcionada por rodada, informada por uma busca na literatura.
- Uma regra de parada fixa. Duas rodadas consecutivas sem melhoria encerram o ciclo. Ele parou na v28.
- Um limite de custo fixo. Não se pode usar dentro do pipeline nenhum modelo mais caro do que o modelo pequeno ou o classificador.
O que observamos
Estatísticas descritivas em três pontos de verificação (Anita antes das sessões 13 e 20, Markus antes da sessão 12) e três execuções por versão.
Cobertura de conteúdo: a lista de verificação de referência
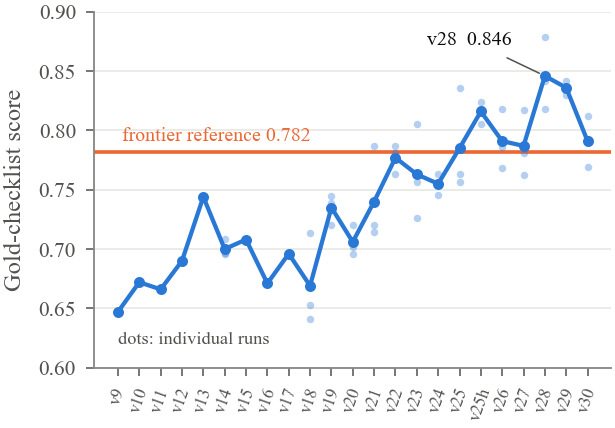
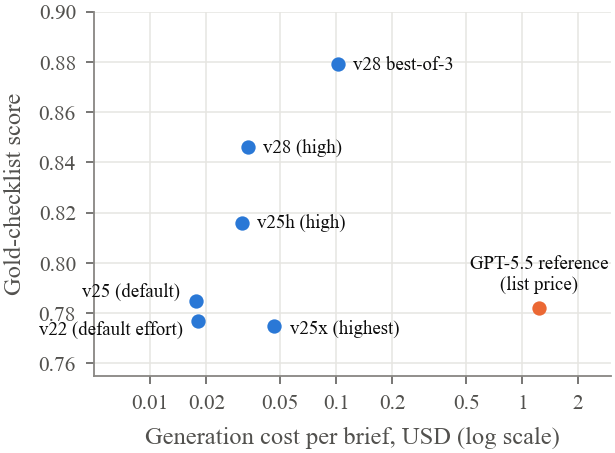
O modelo pequeno começou bem abaixo da referência (0,647 vs. 0,782), superou-a na v25 e chegou a 0,846 na v28. As três execuções da v28 (0,818, 0,842, 0,879) ficaram acima da referência. Duas versões posteriores não melhoraram em relação à v28, e o ciclo foi encerrado.
| Anita, antes de S13 | Anita, antes de S20 | Markus, antes de S12 | |
|---|---|---|---|
| v28, média de 3 execuções | 0,963 | 0,800 | 0,776 |
| v28, best-of-3 (verificador) | 0,963 | 0,836 | 0,836 |
| Referência GPT-5.5 (1 execução) | 0,963 | 0,655 | 0,727 |
Médias nos pontos de verificação: v28 0,846 · best-of-3 0,879 · referência 0,782.
Revisão cega: dentro do ruído do avaliador
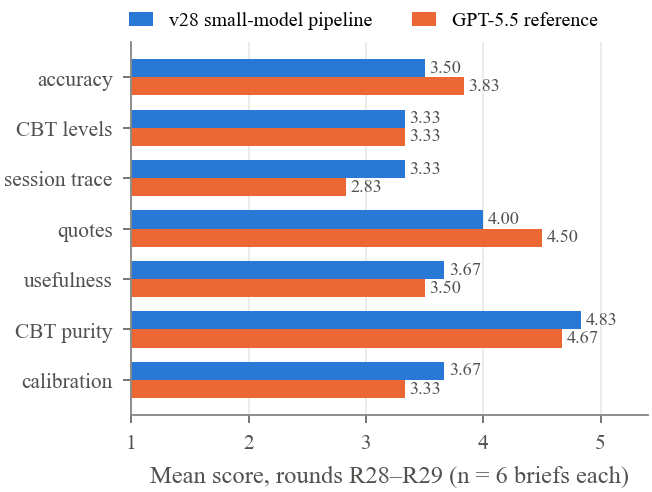
Nas rodadas finais, a melhor versão do modelo pequeno e a referência receberam 3,77 vs. 3,87 (R28) e 3,77 vs. 3,57 (R29). Em seis pares da mesma rodada, as diferenças foram −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: média +0,05, DP 0,49. Nenhum dos sistemas atingiu a média-alvo de 4,0 do supervisor. Por critério, a v28 ficou à frente no acompanhamento das sessões e na calibração, atrás na precisão (concordância com a referência de referência) e nas citações, e empatou nos níveis de TCC.
Custo
Um resumo v28 custa cerca de USD 0,03 na redação das seções e leva de 2,5 a 3 minutos; um resumo best-of-3 custa cerca de USD 0,11. O processamento de uma nova sessão acrescenta cerca de USD 0,07, em sua maior parte devido à passagem do classificador por todas as frases. Aos preços de tabela, o resumo de referência de ponta custa cerca de 19 vezes mais do que um único resumo v28. O projeto inteiro usou USD 5,57 em tokens do modelo pequeno.
O que ajudou e o que não ajudou
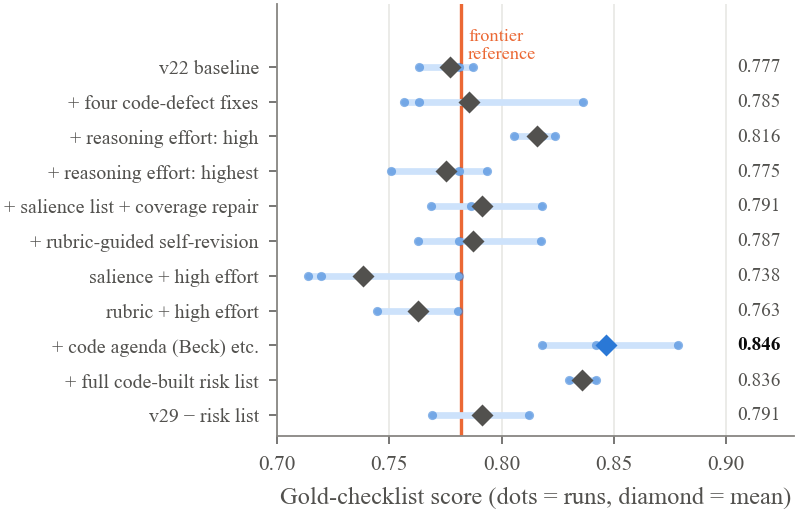
Três coisas ajudaram: corrigir defeitos no código determinístico identificados pelo supervisor; definir um esforço de raciocínio alto para os redatores de seção (a configuração mais alta custou mais e teve pontuação menor); e transferir para o código a agenda sugerida, a barra de previsões e a declaração mais recente relacionada a risco. Várias adições plausíveis prejudicaram os resultados: fundir três rascunhos, impor por código uma linha do tempo das crenças, fornecer indicações de relevância com uma etapa de correção de cobertura e fazer autorrevisão orientada por rubrica. Cada uma acrescentou uma etapa de geração na qual um modelo pequeno pode perder ou distorcer informações. Todas as alterações que retiraram trabalho do modelo ou selecionaram entre saídas sem reescrevê-las foram seguras.
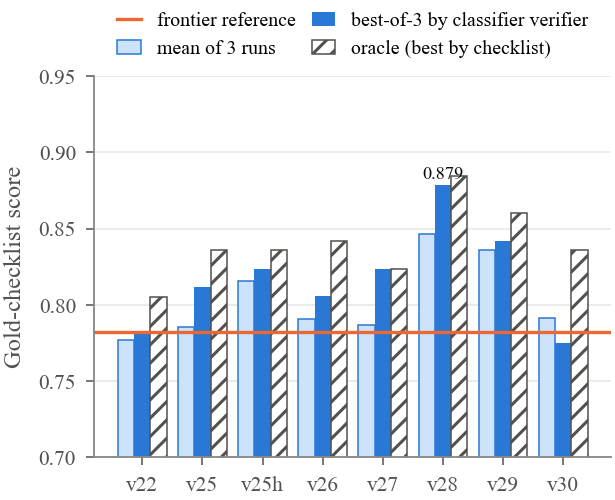
A seleção do verificador melhorou a pontuação na lista de verificação em sete das oito versões; na v28, de 0,846 para 0,879, perto do oráculo (0,885). Como o verificador e o avaliador da lista de verificação são o mesmo classificador, parte desse ganho pode refletir preferências compartilhadas.
O que continuou difícil
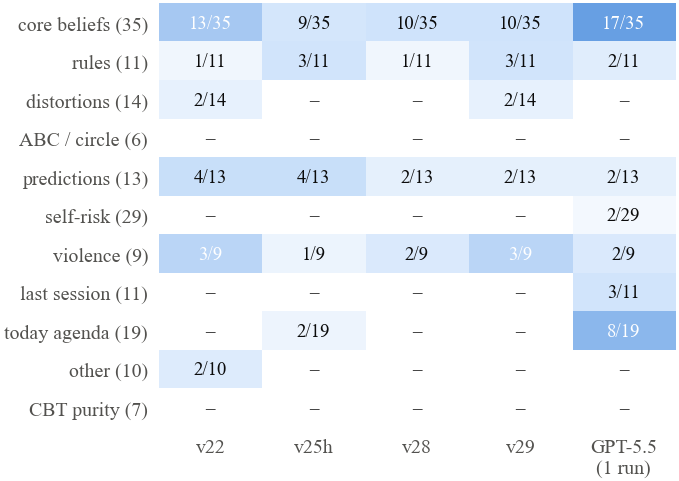
As falhas persistentes caíram de 25 para 15 unidades de peso, de v22 a v28, entre 164 unidades. O que resta são os juízos mais sutis do modelo cognitivo: o estado de uma crença depois de ser reativada, intervalos de crenças que terminam antes do material mais recente e qualificações de escopo. As falas sobre risco foram o componente mais difícil: foram penalizadas tanto a omissão de uma declaração recente quanto a interpretação de uma metáfora, exercício ou avaliação de emoção como um sinal. O melhor projeto manteve apenas a declaração literal mais recente e a sessão em que o terapeuta perguntou diretamente sobre ela pela última vez, deixando toda interpretação a cargo do terapeuta.
O avaliador faz parte do experimento
Como o resumo de referência nunca mudou, suas pontuações medem apenas o supervisor.
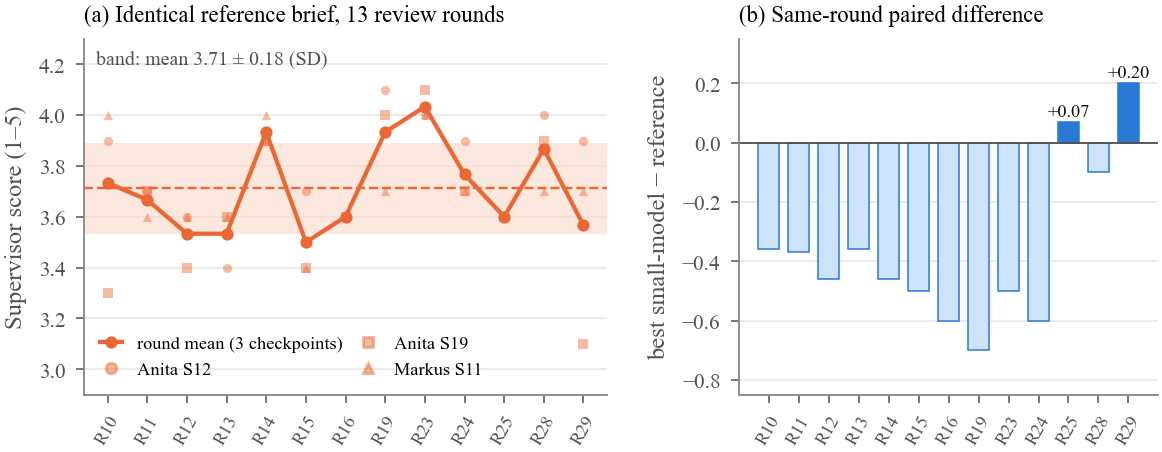
Ao longo de 13 rodadas, o resumo de referência idêntico recebeu uma média por rodada de 3,71, com DP 0,18 e intervalo de 3,50–4,03 numa escala de 1 a 5. Em critérios individuais, o DP chegou a 0,46, inclusive para citações verificadas por script e idênticas em todas as ocasiões. Esse ruído é aproximadamente tão grande quanto toda a melhoria que o ciclo produziu na mesma escala.
O que este estudo não demonstra
- Apenas dados sintéticos. Dois pacientes sintéticos, três pontos de verificação, três execuções por versão. Apenas estatísticas descritivas, sem testes de significância. A transferência para outras tarefas e materiais reais é argumentada, não demonstrada.
- Apenas avaliação baseada em modelos. Nenhum clínico ou outro avaliador humano participou, por projeto. As pontuações descrevem a concordância com uma lista de verificação de referência e o julgamento de um supervisor LLM, não a qualidade clínica, a segurança ou qualquer efeito sobre a terapia.
- Ajuste no conjunto de avaliação. Todas as versões foram desenvolvidas com base nos mesmos pontos de verificação e avaliadores, portanto as pontuações finais são otimistas. O teste adequado seria usar um paciente retido.
- Não ser distinguível não significa ser melhor. Na revisão cega, não foi possível distinguir o modelo pequeno da referência de ponta nesta amostra; as diferenças estão dentro do próprio ruído do avaliador.
- Classificador compartilhado. O avaliador da lista de verificação, o analisador de frases e o verificador são o mesmo modelo.
- Uma referência modesta. A referência de ponta é uma execução anterior, não otimizada, de um pipeline, executada uma vez com GPT-5.5; não é um pipeline de ponta ajustado com o mesmo ciclo.
Leia o artigo, confira os números
O artigo completo pode ser baixado gratuitamente. O pacote de dados com listas de verificação, pontuações e exemplos de resumos é enviado por e-mail.
O artigo
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Pré-publicação, 13 páginas, 9 figuras.
Baixar o pacote de dados
PDF do artigo, todas as nove figuras, as três listas de verificação de referência, pontuações da lista de verificação e do verificador para cada versão, revisões cegas das rodadas finais com suas chaves de letras e três exemplos de resumos finais. Um README explica cada campo.
Não compartilhamos endereços. O link para os dados chega em poucos minutos.
O que contém o ZIP
paper/: o artigo em PDFfigures/: nove figuras e os números correspondentesscores/gold_checklists.json: 3 × 25 afirmações ponderadasscores/checklist_results.json: probabilidades por item para 198 resumos avaliadosscores/blind_review_R28.json,R29: sete critérios, veredictos e objeções, com chaves de letrasexample-briefs/: três resumos finais v28 (em polonês, como as transcrições)
Não incluídos: transcrições sintéticas, prompts e código. Estão disponíveis mediante solicitação aos autores para fins de pesquisa.
Como citar
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}