
Klein model, zorgvuldige pipeline
Een autoresearchmethode om de kloof met frontier-LLM's te dichten bij lange samenvattingen van meerdere documenten. Getest op briefings voorafgaand aan sessies, samengesteld op basis van de transcripties van twee synthetische patiënten.
Een goedkoop model kan dicht in de buurt komen, als het minder doet
Frontier-taalmodellen vatten lange teksten uit meerdere documenten goed samen, maar zo'n model telkens voor elke output inzetten loopt snel in de kosten. Kleine modellen zijn goedkoop, maar verliezen informatie bij lange input. We onderzochten hoe ver een goedkoop model kan komen wanneer het deel uitmaakt van een zorgvuldig ontworpen pipeline en wordt verbeterd via een geautomatiseerde lus die elke wijziging met andere modellen evalueert, zonder menselijke beoordelaars.
In ruim 30 versies en 16 blinde beoordelingsrondes steeg de score van het kleine model van 0,647 naar 0,846 op een gewogen gouden checklist (0,879 wanneer een verifier zonder referentie de beste van drie runs kiest). De frontierreferentie scoorde 0,782. Bij blinde beoordeling door een LLM-supervisor waren de twee bij deze steekproefgrootte niet van elkaar te onderscheiden: het gemiddelde gepaarde verschil bedroeg +0,05 (SD 0,49). Dezelfde, ongewijzigde referentiebrief kreeg van die supervisor in 13 rondes scores tussen 3,50 en 4,03. De eigen ruis van de beoordelaar bleek dus op zichzelf een bevinding.
Inhoud
Lange input, vaste structuur, routinematig gebruik
Veel praktische samenvattingstaken hebben drie eigenschappen gemeen: de input is lang en verspreid over veel documenten, de output volgt een vaste structuur met aantallen, datums en letterlijk bewijs, en de output wordt routinematig geproduceerd, waardoor de kosten ertoe doen.
We gebruikten een dergelijke taak als testomgeving: een gestructureerde briefing die een CGT-therapeut in ongeveer drie minuten kan lezen vóór een sessie. Ze bevat kernopvattingen met sessietellingen, regels, terugkerende denkfouten, typische ABC-episodes, getoetste voorspellingen, de vorige sessie en punten die de therapeut tijdens de sessie van vandaag mogelijk wil bespreken. Tegen sessie 20 omvat het materiaal ongeveer 130.000 woorden.
Deze taak is geschikt voor een methodologische onderzoeksvraag omdat ze een bekende structuur heeft (het cognitieve model van Beck), een natuurlijke vorm van verifieerbaar bewijs (de letterlijke woorden van de patiënt) en verschillende valkuilen: een overtuiging die aanvankelijk door de therapeut is verwoord, of een metafoor die geen uitspraak over de dood is.
Twee synthetische patiënten
Beide patiënten werden gegenereerd met onze gelaagde methode voor synthetische patiënten (eerst een profielblad, therapeutisch verloop, sessieplan en stemgids, vervolgens sessies die één voor één werden gegenereerd als ASR-achtige transcripties). Anita: 20 sessies, 131.498 woorden, CGT in de stijl van J. Beck. Markus: 12 sessies, 83.978 woorden, met een therapeut die deels met schematherapie werkt. De briefing moet het materiaal dus opnieuw formuleren in CGT-termen. Voor elke patiënt werd onafhankelijk een gouden referentie opgesteld na een volledige lezing van de transcripties. Er werden geen gegevens van echte patiënten gebruikt.
Taakverdeling
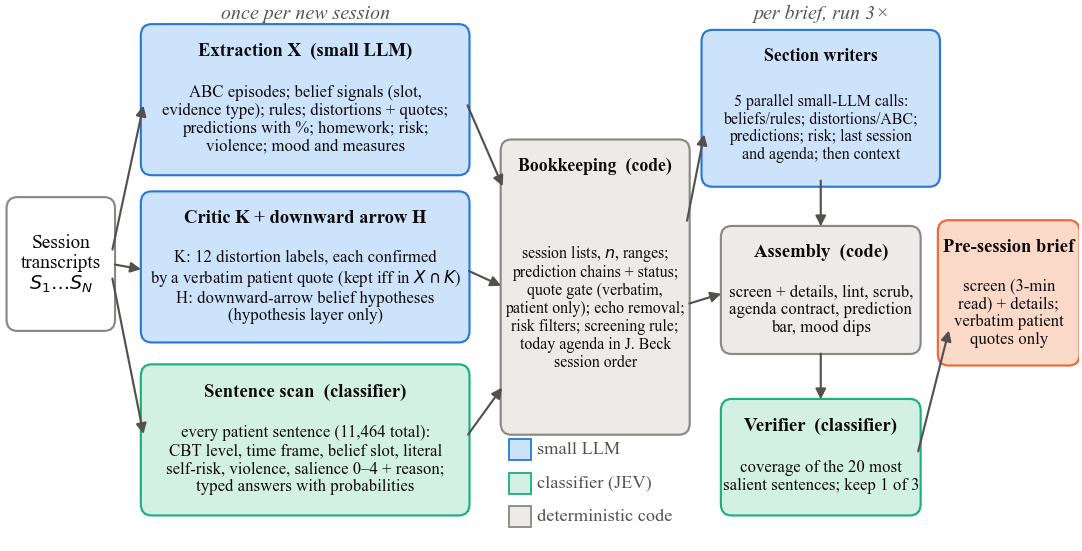
De doorslaggevende veranderingen waren geen betere prompts, maar een herverdeling van verantwoordelijkheden. Elke component doet alleen wat hij goed kan.
Deterministische code
Alles wat geteld, geordend of gecontroleerd kan worden
Sessielijsten, aantallen en bereiken voor elke overtuiging; voorspellingsketens die over sessies heen worden gekoppeld; een filter voor letterlijke citaten die elk citaat schrapt dat niet in de eigen uitspraken van de patiënt voorkomt; verwijdering van echo's van de therapeut; en vanaf versie 28 de volgorde van de voorgestelde punten voor de sessie van vandaag. Zodra een defect in deze code wordt gevonden, blijft het verholpen.
Een zinsclassifier
Oordelen waarvoor geen tekstgeneratie nodig is
Elke zin van de patiënt (in totaal 11.464) krijgt één label: CGT-niveau (automatische gedachte, regel, overtuiging, emotie, gedrag…), tijdskader (nu of herinnering), letterlijke of figuurlijke formulering, en hoe relevant de zin mogelijk is voor de volgende sessie; elk label krijgt ook een waarschijnlijkheid. Dezelfde classifier fungeert later als verifier zonder referentie en als beoordelaar van de checklist.
Een klein taalmodel
Korte teksten op basis van voorbereid materiaal
Per sessie haalt het kleine model structuur uit de tekst, bevestigt het denkfouten met letterlijke citaten en formuleert het hypotheses (opgeslagen als hypotheses, nooit als bewijs). Per briefing werken vijf sectieschrijvers parallel. Elk ziet alleen de gegevens met sessienummers voor de eigen sectie en krijgt de instructie nooit sessienummers of citaten te verzinnen.
De beste van drie, zonder het antwoord te zien
Verschillen tussen runs binnen één versie waren vaak groter dan verschillen tussen versies. Daarom draait de pipeline op briefingsniveau drie keer en kiest een verifier er één: die neemt de 20 meest relevante zinnen van de patiënt en vraagt de classifier of elke zin in de briefing terugkomt. De verifier ziet de gouden referentie of checklist nooit.
De autoresearchlus
Een geautomatiseerde ontwikkelingslus in de geest van recent werk rond geautomatiseerde experimenten: stel één wijziging voor, voer die uit en behoud ze alleen als twee onafhankelijke maatstaven overeenkomen.
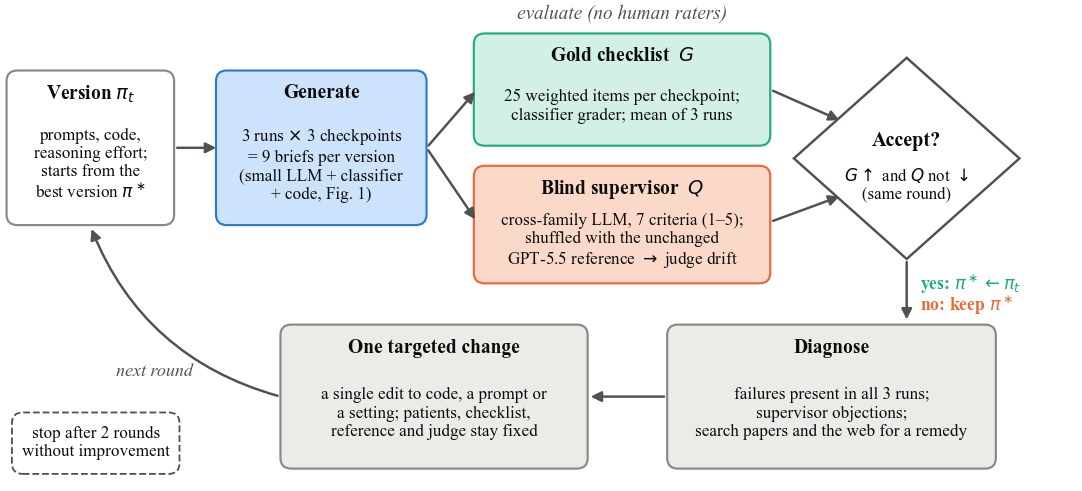
- Twee maatstaven. Een gouden checklist met 25 gewogen beweringen per controlepunt, beoordeeld door de classifier, en een blinde beoordeling door een LLM-supervisor uit een andere modelfamilie, met zeven criteria op een schaal van 1–5.
- Een vast anker. De supervisor ziet telkens ook één ongewijzigde frontierreferentiebrief onder een willekeurige letter, zodat de eigen drift van de beoordelaar in elke ronde wordt gemeten.
- Één wijziging tegelijk. Fouten die in alle drie de runs voorkomen en bezwaren van de supervisor sturen per ronde één gerichte wijziging, geïnformeerd door een literatuurzoektocht.
- Een vaste stopregel. Twee opeenvolgende rondes zonder verbetering beëindigen de lus. Ze stopte bij v28.
- Een vaste kostengrens. Binnen de pipeline mag geen model worden gebruikt dat duurder is dan het kleine model of de classifier.
Wat we waarnamen
Beschrijvende statistieken op drie controlepunten (Anita vóór sessie 13 en 20, Markus vóór sessie 12) en drie runs per versie.
Dekking van de inhoud: de gouden checklist
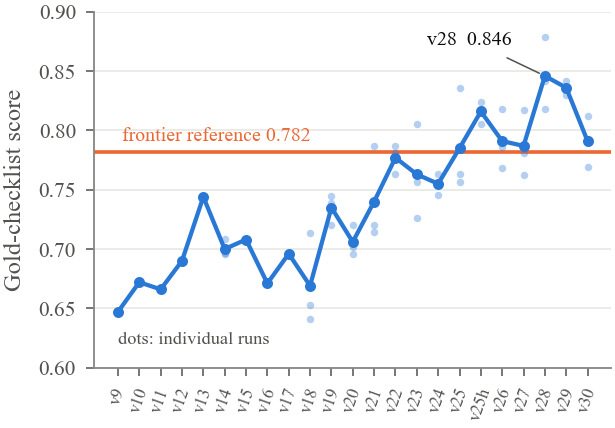
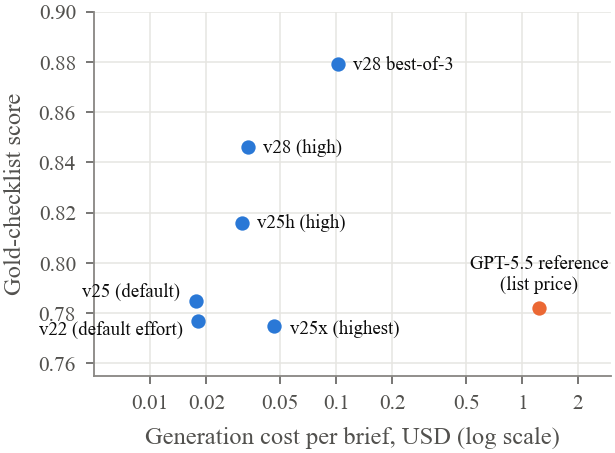
Het kleine model begon ruim onder de referentie (0,647 tegenover 0,782), haalde die in op v25 en bereikte 0,846 op v28. Alle drie v28-runs (0,818, 0,842, 0,879) liggen boven de referentie. Twee latere versies verbeterden niet ten opzichte van v28 en de lus stopte.
| Anita, vóór S13 | Anita, vóór S20 | Markus, vóór S12 | |
|---|---|---|---|
| v28, gemiddelde van 3 runs | 0,963 | 0,800 | 0,776 |
| v28, best-of-3 (verifier) | 0,963 | 0,836 | 0,836 |
| GPT-5.5-referentie (1 run) | 0,963 | 0,655 | 0,727 |
Gemiddelden over controlepunten: v28 0,846 · best-of-3 0,879 · referentie 0,782.
Blinde beoordeling: binnen de ruis van de beoordelaar
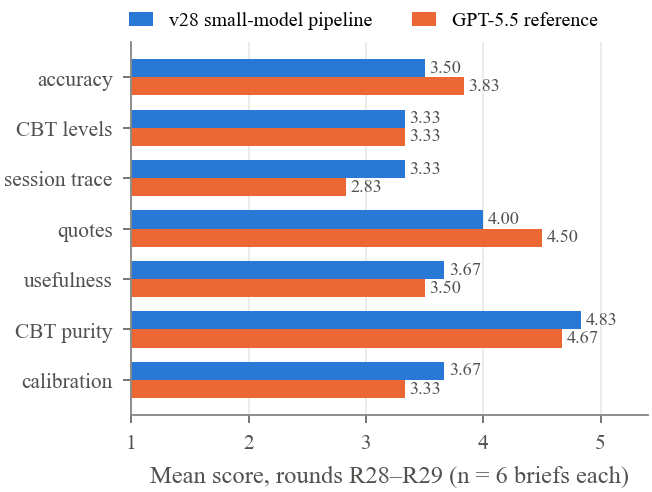
In de laatste rondes scoorden de beste versie van het kleine model en de referentie respectievelijk 3,77 tegenover 3,87 (R28) en 3,77 tegenover 3,57 (R29). Over zes paren binnen dezelfde ronde bedroeg het verschil −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: gemiddelde +0,05, SD 0,49. Geen van beide systemen haalde het beoogde gemiddelde van 4,0 van de supervisor. Per criterium scoorde v28 hoger op sessieverloop en kalibratie, lager op nauwkeurigheid (overeenstemming met de gouden referentie) en citaten, en gelijk op CGT-niveaus.
Kosten
Eén v28-briefing kost ongeveer USD 0,03 voor het schrijven van de secties en duurt 2,5–3 minuten; een best-of-3-briefing kost ongeveer USD 0,11. Het verwerken van een nieuwe sessie kost ongeveer USD 0,07 extra, grotendeels door de classifierpass over elke zin. Tegen catalogusprijzen kost de frontierreferentiebriefing ongeveer 19 keer zoveel als één v28-briefing. Voor het volledige project werd USD 5,57 aan tokens van het kleine model gebruikt.
Wat hielp en wat niet
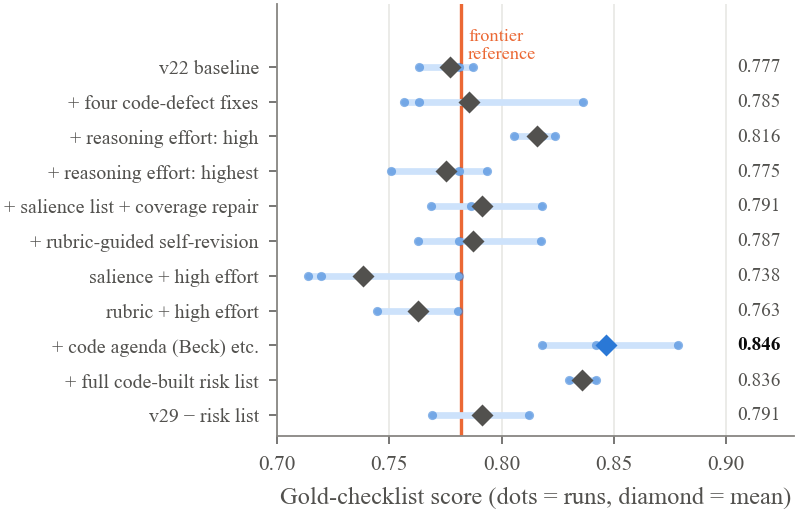
Drie zaken hielpen: defecten verhelpen in deterministische code die de supervisor had ontdekt, een hoge instelling voor redeneerinspanning bij de sectieschrijvers (de hoogste instelling kostte meer en scoorde lager), en de voorgestelde agenda, de voorspellingsbalk en de meest recente risico-gerelateerde uitspraak naar code verplaatsen. Verschillende aannemelijke toevoegingen werkten averechts: drie ontwerpen samenvoegen, een door code opgelegde tijdlijn van overtuigingen, hints over relevantie met een herstelronde voor dekking, en rubric-gestuurde zelfherziening. Elk daarvan voegde een generatiestap toe waarin een klein model informatie kan verliezen of vervormen. Elke wijziging die werk bij het model weghaalde of outputs selecteerde zonder ze te herschrijven, was veilig.
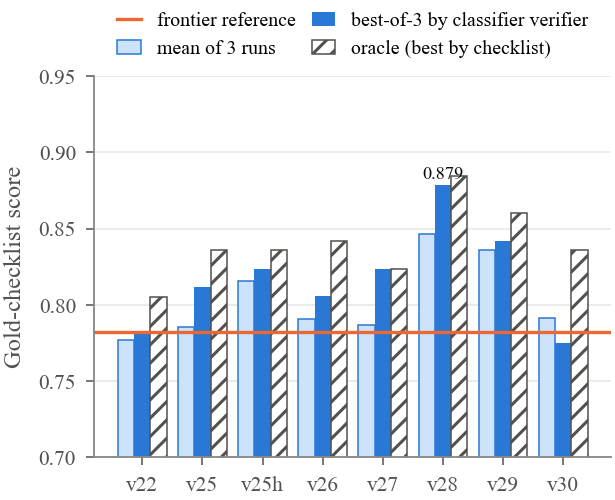
Verifierselectie verbeterde de checklistscore voor zeven van de acht versies; voor v28 steeg die van 0,846 naar 0,879, dicht bij het orakel (0,885). Omdat de verifier en de checklistbeoordelaar dezelfde classifier zijn, kan een deel van deze winst gedeelde voorkeuren weerspiegelen.
Wat moeilijk bleef
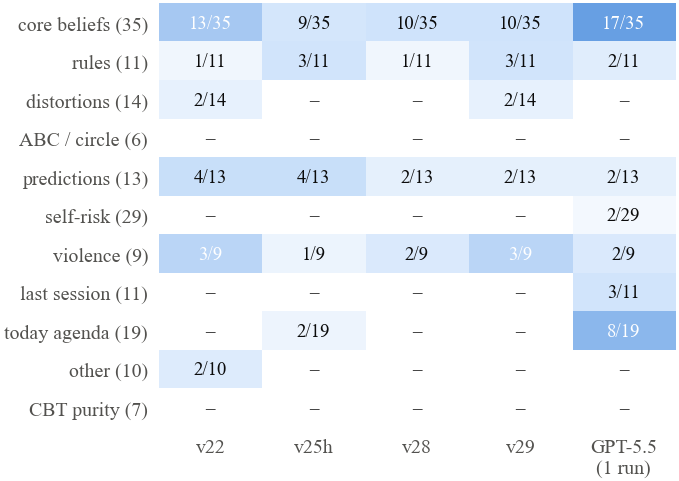
Aanhoudende fouten daalden tussen v22 en v28 van 25 naar 15 van de 164 gewichtseenheden. Wat overblijft, zijn de subtielste oordelen van het cognitieve model: de toestand van een overtuiging nadat die opnieuw is geactiveerd, bereiken voor overtuigingen die stoppen vóór het meest recente materiaal, en kwalificaties van de reikwijdte. Uitspraken over risico waren het moeilijkste onderdeel: zowel het ontbreken van een recente uitspraak als het interpreteren van een metafoor, een oefening of een emotionele score als signaal werd bestraft. In het beste ontwerp bleef alleen de meest recente letterlijke uitspraak behouden, samen met de sessie waarin de therapeut er het laatst rechtstreeks naar vroeg; alle interpretatie werd aan de therapeut overgelaten.
De beoordelaar maakt deel uit van het experiment
Omdat de referentiebrief nooit veranderde, meten de scores ervan alleen de supervisor.
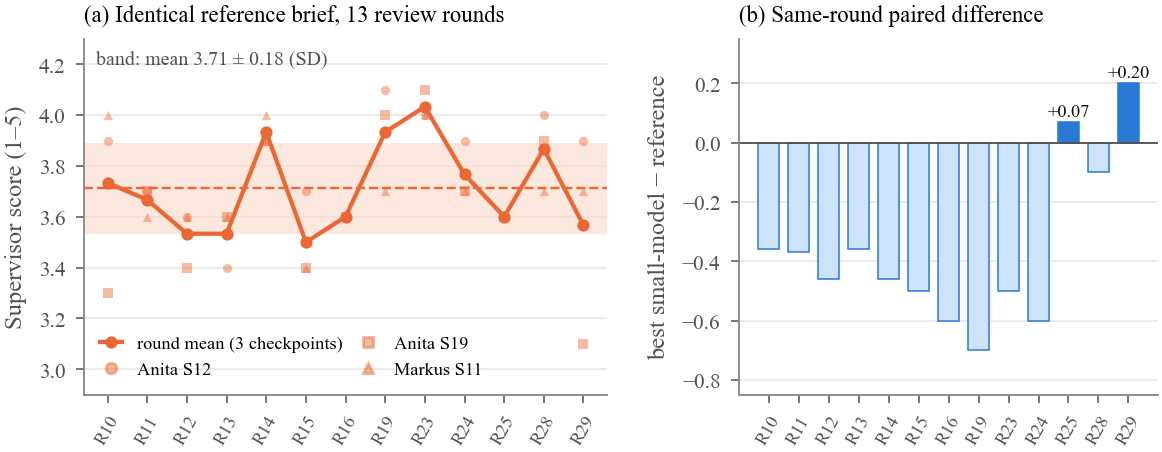
Over 13 rondes kreeg de identieke referentiebrief een rondescoregemiddelde van 3,71 met SD 0,18 en een bereik van 3,50–4,03 op een schaal van 1–5. Voor afzonderlijke criteria liep de SD op tot 0,46, ook voor citaten die scriptmatig waren geverifieerd en elke keer identiek waren. Die ruis is ongeveer even groot als de volledige verbetering die de lus op dezelfde schaal opleverde.
Wat deze studie niet aantoont
- Uitsluitend synthetische gegevens. Twee synthetische patiënten, drie controlepunten, drie runs per versie. Alleen beschrijvende statistieken, geen significantietoetsen. Overdraagbaarheid naar andere taken en echt materiaal wordt beargumenteerd, niet aangetoond.
- Uitsluitend modelevaluatie. Er namen bewust geen clinici of andere menselijke beoordelaars deel. Scores beschrijven de overeenstemming met een gouden checklist en het oordeel van een LLM-supervisor, niet de klinische kwaliteit of veiligheid, of enig effect op therapie.
- Afgestemd op de evaluatieset. Alle versies werden ontwikkeld op basis van dezelfde controlepunten en beoordelaars, waardoor de eindscores optimistisch zijn. Een patiënt die buiten de evaluatie werd gehouden, zou de geschikte test zijn.
- Niet te onderscheiden betekent niet beter. Bij blinde beoordeling waren het kleine model en de frontierreferentie bij deze steekproefgrootte niet van elkaar te onderscheiden; de verschillen vallen binnen de eigen ruis van de beoordelaar.
- Gedeelde classifier. De checklistbeoordelaar, de zinscanner en de verifier zijn hetzelfde model.
- Een bescheiden referentie. De frontierreferentie is één eerdere, niet-geoptimaliseerde pipeline-run met GPT-5.5, niet een frontierpipeline die met dezelfde lus is geoptimaliseerd.
Lees de paper, controleer de cijfers
De volledige paper kan gratis worden gedownload. Het datapakket met checklists, scores en voorbeeldbriefings wordt per e-mail verstuurd.
De paper
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Preprint, 13 pagina's, 9 figuren.
Download het datapakket
PDF van de paper, alle negen figuren, de drie gouden checklists, checklist- en verifierscores voor elke versie, blinde beoordelingen uit de laatste rondes met hun lettersleutels, en drie finale voorbeeldbriefings. Een README licht elk veld toe.
We delen geen e-mailadressen. De datalink komt binnen enkele minuten aan.
Wat zit er in de ZIP
paper/: de paper als PDFfigures/: negen figuren en de onderliggende cijfersscores/gold_checklists.json: 3 × 25 gewogen beweringenscores/checklist_results.json: kansen per item voor 198 beoordeelde briefingsscores/blind_review_R28.json,R29: zeven criteria, oordelen en bezwaren, met lettersleutelsexample-briefs/: drie finale v28-briefings (in het Pools, net als de transcripties)
Niet inbegrepen: synthetische transcripties, prompts en code. Die zijn op verzoek beschikbaar bij de auteurs voor onderzoeksgebruik.
Hoe te citeren
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}