
Petit modèle, pipeline soigneusement conçu
Une méthode d’autorecherche pour réduire l’écart avec les LLM de pointe dans la synthèse longue de plusieurs documents. Évaluée sur des comptes rendus pré-séance élaborés à partir des transcriptions de deux patients synthétiques.
Un modèle peu coûteux peut s’en approcher, à condition d’en faire moins
Les modèles de langage de pointe résument bien les contenus longs et constitués de plusieurs documents, mais les utiliser avant chaque production coûte cher. Les petits modèles sont peu coûteux, mais perdent des informations lorsque les entrées sont longues. Nous avons cherché jusqu’où un modèle peu coûteux pouvait aller lorsqu’il s’inscrit dans un pipeline soigneusement conçu et qu’une boucle automatisée l’améliore en évaluant chaque changement à l’aide d’autres modèles, sans évaluateurs humains.
Sur plus de 30 versions et 16 cycles d’évaluation à l’aveugle, le score du petit modèle sur une checklist de référence pondérée est passé de 0,647 à 0,846 (0,879 lorsque le vérificateur sans référence choisit le meilleur de trois résultats). La référence de pointe a obtenu 0,782. Lors de l’évaluation à l’aveugle par un superviseur LLM, les deux n’ont pas pu être distingués à cette taille d’échantillon : la différence moyenne appariée était de +0,05 (ET 0,49). Le même compte rendu de référence, inchangé, a reçu des notes comprises entre 3,50 et 4,03 de ce superviseur au fil de 13 cycles ; le bruit propre au juge s’est donc révélé être lui-même un résultat.
Sommaire
Entrée longue, structure fixe, usage courant
De nombreuses tâches pratiques de synthèse ont trois propriétés en commun : l’entrée est longue et répartie entre de nombreux documents ; la sortie suit une structure fixe avec des décomptes, des dates et des éléments justificatifs verbatim ; et la production est régulière, si bien que le coût compte.
Nous avons utilisé une telle tâche comme banc d’essai : un compte rendu structuré qu’un thérapeute en TCC peut lire en environ trois minutes avant une séance. Il présente les croyances fondamentales et leur nombre d’occurrences en séance, les règles, les distorsions récurrentes, les épisodes ABC typiques, les prédictions testées, la dernière séance et les points que le thérapeute pourrait aborder lors de la séance du jour. À la séance 20, le contenu représente environ 130 000 mots.
Cette tâche convient à une question méthodologique, car sa structure est connue (le modèle cognitif de Beck), elle offre une notion naturelle d’élément vérifiable (les paroles verbatim du patient) et présente plusieurs pièges : une croyance formulée initialement par le thérapeute, ou une métaphore qui ne constitue pas une déclaration au sujet de la mort.
Deux patients synthétiques
Les deux patients ont été générés à l’aide de notre méthode de création de patients synthétiques à plusieurs niveaux (fiche de profil, parcours thérapeutique, plan des séances et guide de voix d’abord, puis séances générées une par une sous forme de transcriptions de type ASR). Anita : 20 séances, 131 498 mots, TCC de type J. Beck. Markus : 12 séances, 83 978 mots ; son thérapeute pratique en partie la thérapie des schémas, de sorte que le compte rendu doit reformuler le contenu en termes de TCC. Pour chaque patient, une référence de référence a été rédigée indépendamment après lecture intégrale des transcriptions. Aucune donnée de patients réels n’a été utilisée.
Répartition des tâches
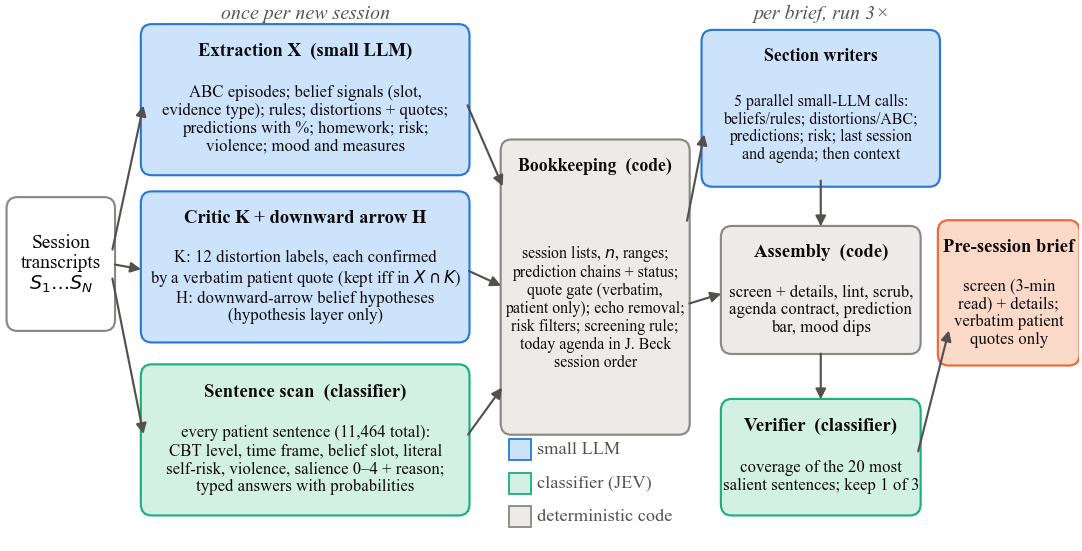
Les changements déterminants ne tenaient pas à de meilleurs prompts, mais à une nouvelle répartition des responsabilités. Chaque composant ne fait que ce pour quoi il est adapté.
Code déterministe
Tout ce qui peut être dénombré, ordonné ou vérifié
Listes de séances, décomptes et plages pour chaque croyance ; chaînes de prédictions reliées entre les séances ; filtre de citations verbatim qui écarte toute citation absente des propos du patient ; suppression des reprises des paroles du thérapeute ; et, à partir de la version 28, ordre des points suggérés pour la séance du jour. Dès qu’un défaut de ce code est repéré, il est corrigé définitivement.
Un classificateur de phrases
Des jugements qui ne nécessitent pas de génération de texte
Chaque phrase du patient (11 464 au total) est étiquetée une fois : niveau de TCC (pensée automatique, règle, croyance, émotion, comportement…), période (actuelle ou remémorée), formulation littérale ou figurée, et degré de pertinence potentielle pour la prochaine séance, chacun assorti d’une probabilité. Le même classificateur sert ensuite de vérificateur sans référence et d’évaluateur de la checklist.
Un petit modèle de langage
Rédaction concise à partir de contenus préparés
Pour chaque séance, le petit modèle extrait la structure, confirme les distorsions à l’aide de citations verbatim et propose des hypothèses (conservées comme hypothèses, jamais comme éléments de preuve). Pour chaque compte rendu, cinq rédacteurs de section fonctionnent en parallèle ; chacun ne voit que les données numérotées par séance de sa propre section et reçoit pour consigne de ne jamais inventer de numéros de séance ni de citations.
Le meilleur de trois, sans consulter la réponse
Les différences d’une exécution à l’autre au sein d’une même version étaient souvent supérieures aux différences entre versions. Le pipeline au niveau du compte rendu s’exécute donc trois fois, puis un vérificateur sélectionne un résultat : il prend les 20 phrases du patient jugées les plus pertinentes et demande au classificateur si chacune est reprise dans le compte rendu. Le vérificateur ne voit ni la référence de référence ni la checklist.
La boucle d’autorecherche
Une boucle de développement automatisée, dans l’esprit des travaux récents sur l’expérimentation automatisée : proposer un changement, l’exécuter et ne le retenir que si deux métriques indépendantes concordent.
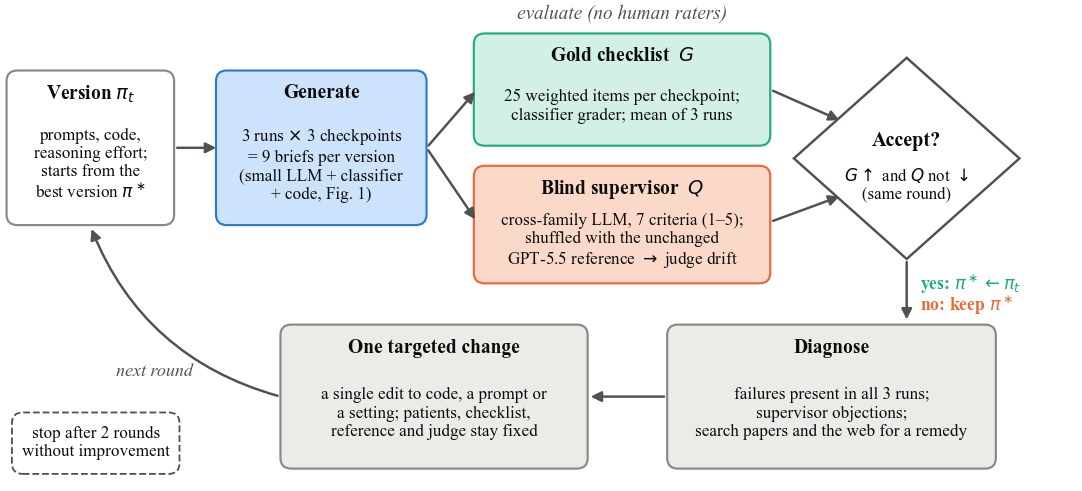
- Deux métriques. Une checklist de référence de 25 énoncés pondérés par point de contrôle, évaluée par le classificateur, et une évaluation à l’aveugle par un superviseur LLM d’une autre famille de modèles, selon sept critères sur une échelle de 1 à 5.
- Un repère fixe. Le superviseur voit toujours aussi un compte rendu de référence de pointe inchangé, associé à une lettre aléatoire, afin que la dérive propre au juge soit mesurée à chaque cycle.
- Un changement à la fois. Les défauts présents dans les trois exécutions et les objections du superviseur orientent un changement ciblé par cycle, éclairé par une recherche bibliographique.
- Une règle d’arrêt fixe. Deux cycles consécutifs sans amélioration mettent fin à la boucle. Elle s’est arrêtée à v28.
- Un plafond de coût fixe. Aucun modèle plus coûteux que le petit modèle ou le classificateur ne peut être utilisé dans le pipeline.
Ce que nous avons observé
Statistiques descriptives sur trois points de contrôle (Anita avant les séances 13 et 20, Markus avant la séance 12) et trois exécutions par version.
Couverture du contenu : la checklist de référence
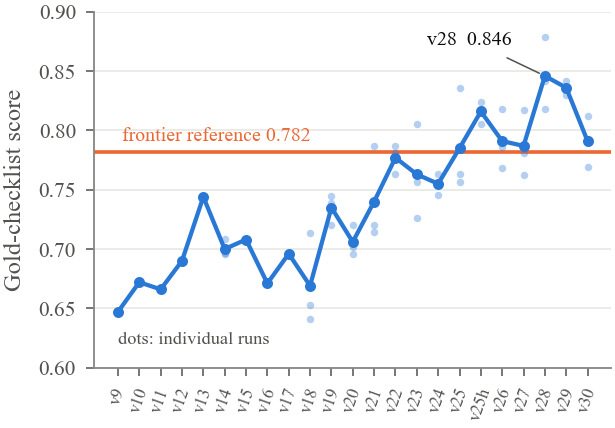
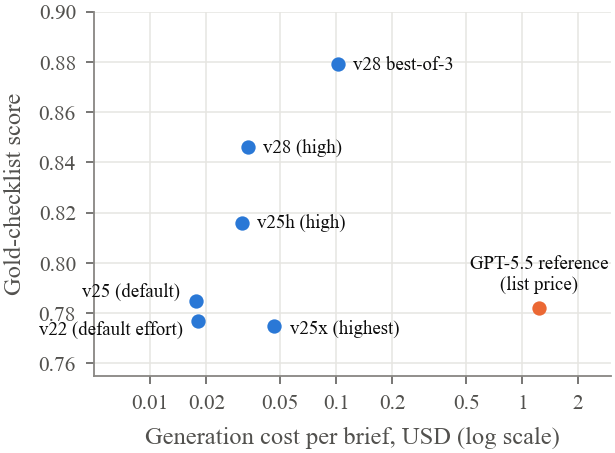
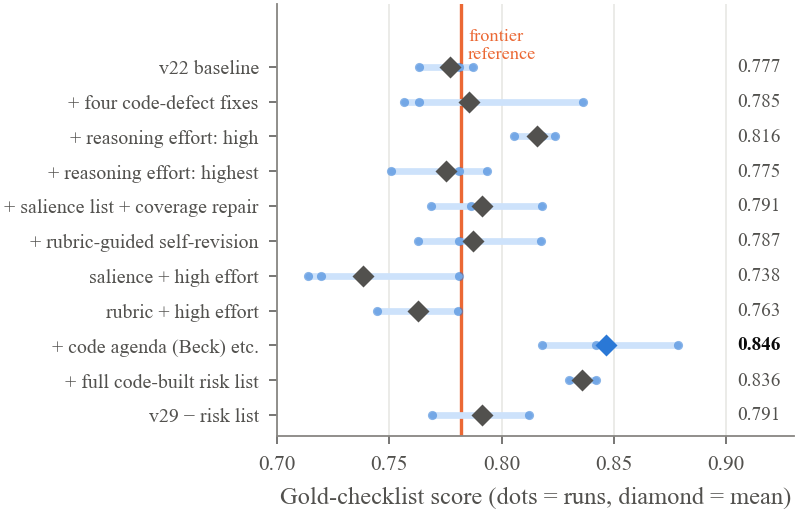
Le petit modèle a démarré nettement en dessous de la référence (0,647 contre 0,782), l’a dépassée à v25 et a atteint 0,846 à v28. Les trois exécutions de v28 (0,818, 0,842, 0,879) sont toutes supérieures à la référence. Deux versions ultérieures n’ont pas amélioré v28, et la boucle s’est arrêtée.
| Anita, avant S13 | Anita, avant S20 | Markus, avant S12 | |
|---|---|---|---|
| v28, moyenne de 3 exécutions | 0,963 | 0,800 | 0,776 |
| v28, best-of-3 (vérificateur) | 0,963 | 0,836 | 0,836 |
| Référence GPT-5.5 (1 exécution) | 0,963 | 0,655 | 0,727 |
Moyennes sur les points de contrôle : v28 0,846 · best-of-3 0,879 · référence 0,782.
Évaluation à l’aveugle : dans la marge de bruit du juge
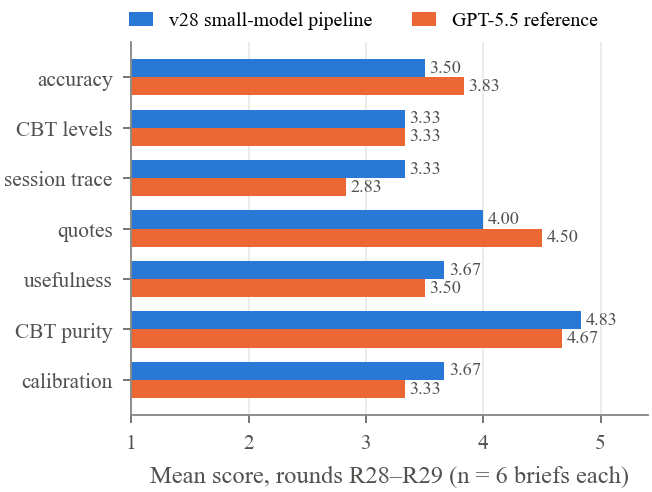
Lors des derniers cycles, la meilleure version du petit modèle et la référence ont obtenu 3,77 contre 3,87 (R28) et 3,77 contre 3,57 (R29). Sur six paires évaluées au cours d’un même cycle, les différences étaient de −0,4, +0,2, −0,1, −0,5, +0,9 et +0,2 : moyenne +0,05, ET 0,49. Aucun des deux systèmes n’a atteint la moyenne cible de 4,0 du superviseur. Par critère, v28 était en avance pour le suivi des séances et le calibrage, en retrait pour l’exactitude (concordance avec la référence) et les citations, et à égalité pour les niveaux de TCC.
Coût
Un compte rendu v28 coûte environ USD 0,03 en rédaction des sections et prend 2,5 à 3 minutes ; un compte rendu best-of-3 coûte environ USD 0,11. Le traitement d’une nouvelle séance ajoute environ USD 0,07, principalement pour le passage du classificateur sur chaque phrase. Aux tarifs catalogue, le compte rendu de référence de pointe coûte environ 19 fois plus qu’un compte rendu v28 unique. Le projet entier a utilisé USD 5,57 de jetons du petit modèle.
Ce qui a aidé, et ce qui n’a pas aidé
Trois éléments ont aidé : corriger les défauts du code déterministe repérés par le superviseur ; utiliser un niveau d’effort de raisonnement élevé pour les rédacteurs de section (le niveau le plus élevé coûtait davantage et obtenait un score inférieur) ; et déplacer dans le code l’ordre du programme suggéré, la barre des prédictions et l’énoncé lié au risque le plus récent. Plusieurs ajouts plausibles ont nui aux résultats : fusionner trois brouillons, imposer une chronologie des croyances par le code, ajouter des indications de pertinence avec une étape de correction de la couverture et procéder à une autorévision guidée par une grille d’évaluation. Chacun ajoutait une étape de génération au cours de laquelle un petit modèle peut perdre ou déformer des informations. Tous les changements qui retiraient des tâches au modèle, ou sélectionnaient parmi les résultats sans les réécrire, se sont révélés sûrs.
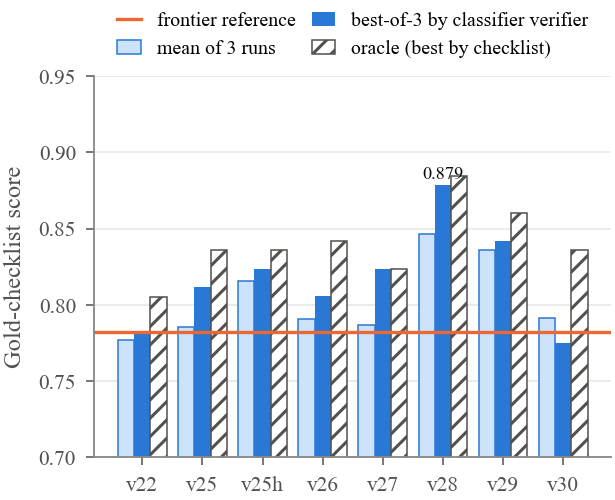
La sélection par vérificateur a amélioré le score de la checklist pour sept des huit versions ; pour v28, il est passé de 0,846 à 0,879, proche de l’oracle (0,885). Comme le vérificateur et l’évaluateur de la checklist sont le même classificateur, une partie de ce gain peut refléter des préférences communes.
Ce qui est resté difficile
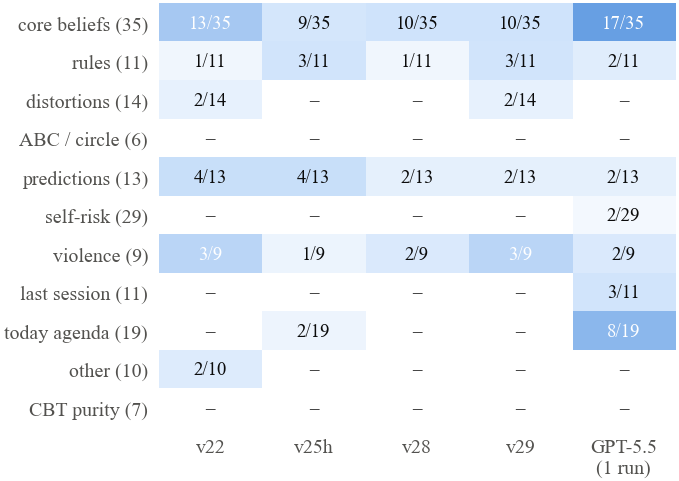
Le nombre de défaillances persistantes est passé de 25 à 15 unités de poids sur 164 entre v22 et v28. Les difficultés restantes concernent les jugements les plus subtils du modèle cognitif : l’état d’une croyance après sa réactivation, les plages de croyance qui s’arrêtent avant le contenu le plus récent et les précisions de portée. Les passages sur le risque constituaient la composante la plus difficile : l’absence d’un énoncé récent et la transformation d’une métaphore, d’un exercice ou d’une évaluation émotionnelle en signal ont toutes été pénalisées. La meilleure conception ne conservait que l’énoncé littéral le plus récent et la séance au cours de laquelle le thérapeute avait posé la question directement pour la dernière fois, laissant toute interprétation au thérapeute.
Le juge fait partie de l’expérience
Comme le compte rendu de référence n’a jamais changé, ses scores mesurent uniquement le superviseur.
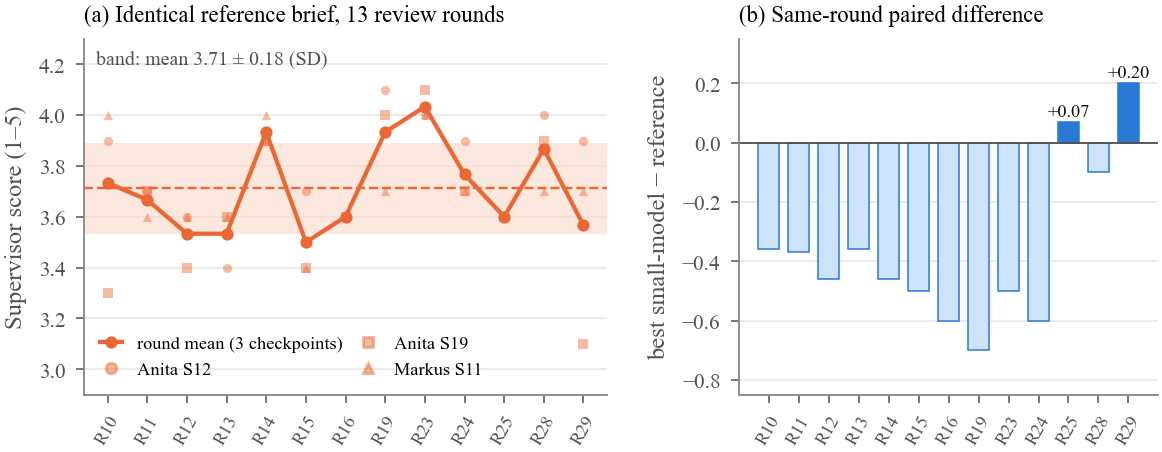
Sur 13 cycles, le compte rendu de référence identique a obtenu une moyenne par cycle de 3,71, avec un ET de 0,18 et une plage de 3,50–4,03 sur une échelle de 1 à 5. Pour certains critères pris isolément, l’ET atteignait 0,46, y compris pour les citations vérifiées par script et identiques à chaque fois. Ce bruit est à peu près de la même ampleur que l’amélioration totale produite par la boucle sur cette même échelle.
Ce que cette étude ne montre pas
- Données synthétiques uniquement. Deux patients synthétiques, trois points de contrôle, trois exécutions par version. Statistiques descriptives uniquement, sans tests de significativité. Le transfert à d’autres tâches et à des données réelles est avancé comme plausible, mais n’est pas démontré.
- Évaluation par modèles uniquement. Aucun clinicien ni autre évaluateur humain n’a participé, conformément au protocole. Les scores décrivent la concordance avec une checklist de référence et le jugement d’un superviseur LLM, et non la qualité clinique, la sécurité ou un quelconque effet sur la thérapie.
- Optimisation sur le jeu d’évaluation. Toutes les versions ont été développées à partir des mêmes points de contrôle et des mêmes juges ; les scores finaux sont donc optimistes. Un patient tenu à l’écart constituerait le test approprié.
- Indiscernable ne signifie pas meilleur. Lors de l’évaluation à l’aveugle, le petit modèle et la référence de pointe n’ont pas pu être distingués à cette taille d’échantillon ; les différences se situent dans la marge de bruit propre au juge.
- Classificateur partagé. L’évaluateur de la checklist, l’analyseur de phrases et le vérificateur sont le même modèle.
- Une référence modeste. La référence de pointe correspond à une seule exécution antérieure, non optimisée, d’un pipeline avec GPT-5.5 ; il ne s’agit pas d’un pipeline de pointe optimisé avec la même boucle.
Lire l’article, vérifier les chiffres
L’article complet est téléchargeable gratuitement. Le jeu de données, qui comprend les checklists, les scores et des exemples de comptes rendus, est envoyé par courriel.
L’article
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Prépublication, 13 pages, 9 figures.
Télécharger le jeu de données
PDF de l’article, les neuf figures, les trois checklists de référence, les scores de checklist et de vérification pour chaque version, les évaluations à l’aveugle des derniers cycles avec leurs clés de lettres, et trois exemples finaux de comptes rendus. Un fichier README explique chaque champ.
Nous ne partageons pas les adresses. Le lien vers les données arrive en quelques minutes.
Contenu du ZIP
paper/: l’article au format PDFfigures/: neuf figures et les chiffres qui les sous-tendentscores/gold_checklists.json: 3 × 25 énoncés pondérésscores/checklist_results.json: probabilités par élément pour 198 comptes rendus évaluésscores/blind_review_R28.json,R29: sept critères, verdicts et objections, avec les clés de lettresexample-briefs/: trois comptes rendus finaux v28 (en polonais, comme les transcriptions)
Non inclus : les transcriptions synthétiques, les prompts et le code. Ils sont disponibles auprès des auteurs sur demande, pour un usage de recherche.
Comment citer
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}